先说个真事:脚本跑到第37页就停了
上周有个做母婴用品的运营团队找我,说他们写了个小脚本,每天把竞品店铺的商品价格和库存扒一遍,做价格带分析。前两周跑得挺好,突然有一天跑到第37页就停了,后面全是空白,偶尔返回一个 403。
我打开他们代码看了一眼——代码里压根没设置代理。请求全都从办公室那一条固定出口发出去,一分钟几十次,目标站的风控两天就给它挂上了标签。这种情况不是脚本写得不好,是缺了最基础的一环:把请求分散到不同的出口 IP 上,而 HTTPS 代理就是最省事的做法。
下面这篇就按他们这套采集需求来走一遍,从拿到一条代理,到写进代码,到跑稳,中间踩的坑也一并写出来。
HTTPS 代理到底"代理"了什么
不少人第一次配代理会卡在一个特别小的地方:明明要访问的是 HTTPS 网站,为什么填代理地址还写 http:// 开头?
原因在于,HTTPS 请求走代理时用的是一种叫 CONNECT 的隧道方式。你的程序先跟代理服务器打个招呼:"帮我连到目标站的 443 端口",代理回一句"通了",之后数据就在这条隧道里加密传输。代理服务器看不到你在传什么,只能看到你连了哪个域名。所以填地址时写的是代理服务器本身的协议(通常是 http),后面跟的端口才是代理的端口——不是目标站的 443,这两个数字经常被搞混。
这也带来一个好处:加密是端到端的,代理服务商拿不到你的业务数据,采集的商品信息只在你自己和目标站之间流转。
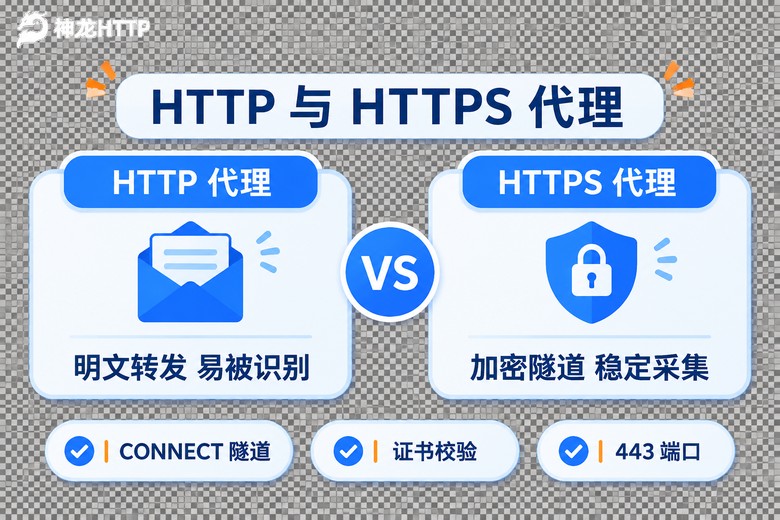
| 对比项 | HTTP 代理 | HTTPS 代理 |
|---|---|---|
| 传输方式 | 明文转发 | CONNECT 加密隧道 |
| 能否看到请求内容 | 可以 | 看不到,只看到域名 |
| 访问 HTTPS 站点 | 需要额外处理,容易出错 | 直接可用 |
| 电商采集适配度 | 低 | 高,主流做法 |
| 代码里填写的代理前缀 | http:// | 同样是 http:// |
做电商采集,几乎全是 HTTPS 站点,所以选代理的时候优先挑同时支持 HTTP/HTTPS/SOCKS5 的服务就行,别在协议上纠结太久,重点在后面的接入和轮换节奏。
第一步:先弄到一条真能用的代理
代理的来源一般分两种形态,选哪种取决于你的采集节奏。
要抓的是"每天扫一遍全店商品"这种长任务,建议用长效静态IP,一条 IP 能撑几小时到一天,连接稳定,不容易半路断掉,适合持续翻页。要是抓的是"分城市看不同地区展示价格"这种短平快的活,就用短效动态IP,用完即换,按量提取更划算。神龙HTTP 这两类都有,另外还有固定IP代理,一个账号里可以先各拿一点试试效果。
拿到的东西通常是三样:代理地址、端口、账号密码。有些服务商直接给一条带认证信息的完整串,形如 http://用户名:密码@代理地址:端口,这种最省事,粘到代码里就能跑。
判断一条代理能不能用,别一上来就跑全量。先干一件事:访问一个能回显 IP 的页面,看看返回的 IP 是不是代理的 IP。之前那位运营同学的脚本里就漏了这步,结果代理配错了三天他都没发现。
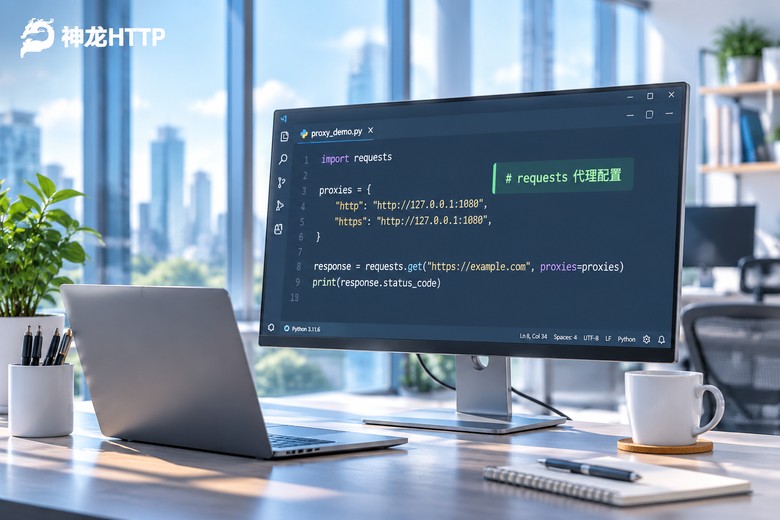
import requests

proxies = {
    "http":  "http://用户名:密码@代理地址:端口",
    "https": "http://用户名:密码@代理地址:端口",
}

r = requests.get("https://目标站/ip回显页", proxies=proxies, timeout=8)
print(r.status_code)
print(r.text[:200])
返回的 IP 和代理列表里的对得上,说明链路是通的。对不上,先检查账号密码有没有多余空格,再检查端口填错没有。
第二步:把代理写进代码,三种写法按需挑
设置代理这件事,在不同位置上做,效果差别挺大。
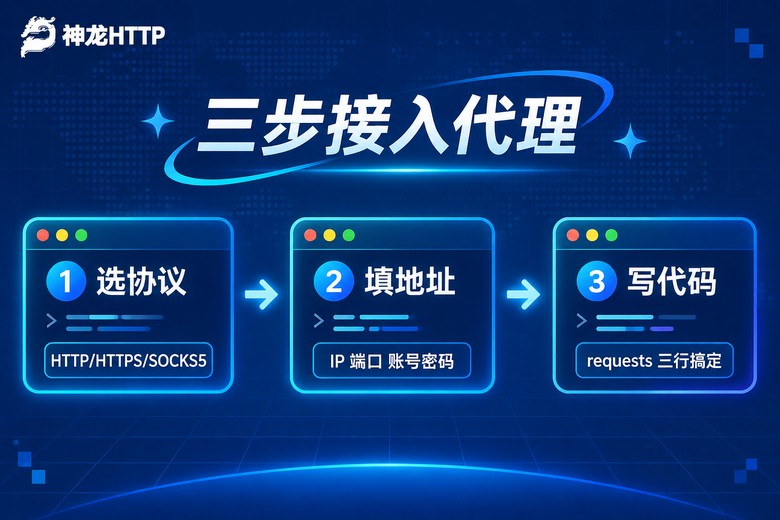
写法一:单次请求里传 proxies。最直接,适合临时验证和少量请求。上面那段代码就是。
写法二:用 Session 复用。电商采集里,同一批商品页往往要连带请求列表页、详情页、评价页,用 Session 能复用连接,速度快不少,也顺手带上 Cookie。
import requests

session = requests.Session()
session.proxies = {
    "http":  "http://用户名:密码@代理地址:端口",
    "https": "http://用户名:密码@代理地址:端口",
}
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
                  "(KHTML, like Gecko) Chrome/124.0 Safari/537.36",
    "Accept-Language": "zh-CN,zh;q=0.9",
})

resp = session.get("https://目标站/商品详情页", timeout=10)
print(resp.status_code, len(resp.text))
写法三:异步并发,配合代理池。要一次跑几千个 SKU,同步的方式太慢。用 httpx 异步请求,每次从代理池里取一条新的,是最常见的组合。
import asyncio, httpx

PROXY_POOL = [
    "http://用户名:密码@代理地址1:端口",
    "http://用户名:密码@代理地址2:端口",
]

async def fetch(client, url, proxy):
    try:
        r = await client.get(url, proxy=proxy, timeout=12)
        return url, r.status_code, len(r.text)
    except Exception as e:
        return url, "ERR", str(e)[:60]

async def main(urls):
    async with httpx.AsyncClient(headers={"User-Agent": "Mozilla/5.0 ..."}) as client:
        tasks = [fetch(client, u, PROXY_POOL[i % len(PROXY_POOL)]) for i, u in enumerate(urls)]
        for result in await asyncio.gather(*tasks):
            print(result)

asyncio.run(main(["https://目标站/商品页?id=1",
                  "https://目标站/商品页?id=2"]))
还有一种绕开代码的土办法:在系统里设环境变量,让整个进程默认走代理。临时调试可以,但正式采集不推荐——一旦要按请求换 IP,就得频繁改变量,反而麻烦。
# macOS / Linux 终端里临时设置
export HTTPS_PROXY="http://用户名:密码@代理地址:端口"
export HTTP_PROXY="http://用户名:密码@代理地址:端口"
第三步:电商采集场景的几个实操细节
代理配通了只是开始,能不能跑稳,看的是下面这几件小事。
1. 先列表后详情,两级节奏分开。列表页一次拿 60 条商品,翻页间隔放慢到 2 到 4 秒;详情页数据量大、请求多,用并发拉,但每 20 到 30 个请求换一条 IP。别一上来就对列表页做并发,那一页最容易被盯上。
2. 超时一定要设,而且要短。默认不设超时,一条坏代理能把整个任务卡死十分钟。设 8 到 12 秒,超了就当失败,换 IP 重试,最多重试两次。
3. 遇到 SSL 报错先别急着关校验。很多人一见证书错误就加 verify=False,其实多数情况是代理不支持隧道,或者代理地址端口填错。先确认链路通不通,再考虑关校验。真要关,也别在全局关,只对特定请求关。
# 只对当前会话放宽证书校验,并关掉告警提示
import urllib3, requests
urllib3.disable_warnings()

session = requests.Session()
session.verify = False
session.proxies = {"https": "http://用户名:密码@代理地址:端口"}
4. 请求头别偷懒。同一个 IP 短时间内带着一模一样的 UA 连续请求,就是在告诉对方"我是脚本"。轮换几个常见 UA,带上 Accept 和 Referer,成功率能明显提升。
5. 把失败率当指标看。每轮采集结束后统计一下 200、403、超时的比例。403 突然上升,说明这批 IP 在同站点上用得太密,该换地区或者拉长换 IP 间隔了。
报错了怎么办:四个高频问题对照排查
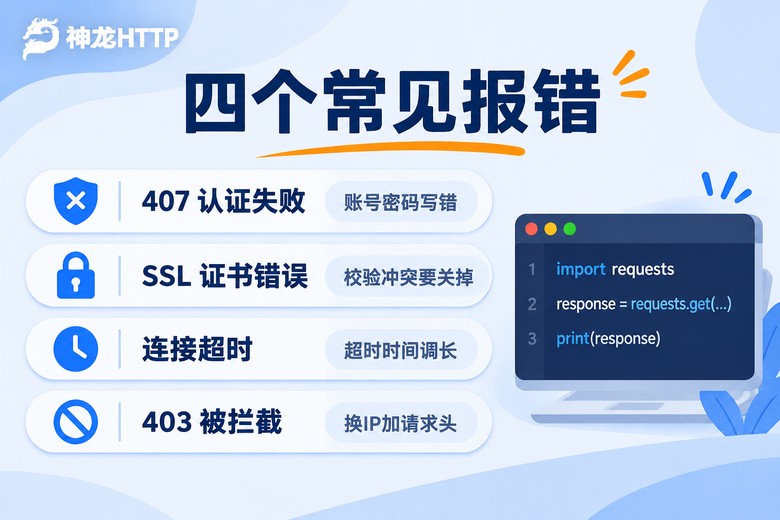
- 407 Proxy Authentication Required:认证没通过。九成是账号密码抄错、加了空格,或者密码里有特殊字符没转义。把密码里的 @、# 换成 URL 编码再试。
- SSL: CERTIFICATE_VERIFY_FAILED:大概率是代理不支持 CONNECT 隧道,或者你用了 HTTP 代理去访问 HTTPS 站点。换一条支持 HTTPS 的代理即可。
- ReadTimeout:代理本身慢或已经失效。给代理加上"取用前先探活"的逻辑,用一条极轻量的请求先试,通了才进池子。
- 403 / 返回验证页:IP 被目标站标记了。缩短单 IP 的使用时长,把并发从 20 降到 8,并补上请求头。通常调整两三轮就能恢复。
把代理池接进来,任务才算真正跑起来
手动往代码里粘代理,最多跑几百个请求就撑不住了。规模化采集的做法是:通过接口按需提取 IP,程序每次请求前调一次接口拿新的,用完丢弃。
神龙HTTP 的接口是标准化的,返回格式清爽,Python 里几行就能接上,主流爬虫语言也都有现成示例代码,官方文档里连重试逻辑都给了模板。它的资源侧是 3000万+ 正规授权代理IP,国内三大运营商授权,可用率 99.9%、IP 纯度 99.8%,300+ 城市级定位——做分地区价格对比的时候,这个城市定位能力比随机出口好用太多,同一个商品在上海和成都能看到不一样的活动价,采出来的数据才有分析价值。
另一个容易被忽略的点是用量监控。采集任务跑起来之后,最怕的是"钱在烧但我不知道哪条线路在浪费"。个人中心里有可视化用量统计和实时监控,哪段时间消耗陡增、哪批 IP 失败率高,一眼能看出来,调轮换策略的时候心里有数。技术上卡住了,7×24 小时的技术支持也能顶上,比自己翻半天日志快。
常见问题
Q:为什么访问 HTTPS 网站,代理地址还要写 http:// 开头?
因为这里写的是代理服务器本身的协议,不是目标网站。HTTPS 请求通过 CONNECT 隧道穿过代理,代理那边仍按 http 协议接收你的连接请求。端口填代理给的端口,不是目标站的 443。
Q:电商采集一般多久换一次 IP?
没有标准答案,看目标站的敏感度。列表页建议 20 到 30 个请求换一次,详情页可以放宽到 50 个左右。发现 403 比例超过 5%,就把间隔砍半。做分城市价格对比的,干脆按城市分配 IP,每个城市固定用几条,数据也更干净。
Q:代码里代理设置了,还是被拦,问题出在哪?
先确认代理有没有真的生效——打印一下请求实际出口的 IP。IP 变了还被拦,基本是请求头、访问频率或者 Cookie 的问题。把 UA 轮换起来,并发降下来,给翻页加个随机停顿,多数情况能解决。
Q:短效动态和长效静态,做采集选哪个?
看任务时长。一次跑十几分钟、以量取胜的,选短效动态,按量提取成本低;要连续翻几十页、中途不能断的,选长效静态,连接稳、掉线少。两种都在一个账号里,先各拿一小批测一测成功率,再决定主用哪种。