代理IP池:把一堆可用IP当成资源库来管
很多人第一次听到“代理IP池”,会把它理解成一张很长的IP列表。列表当然算池的一部分,但真正让池有用的,是背后的管理逻辑:哪些IP能用,哪些IP该休息,哪些IP适合某个任务,哪些IP需要立刻剔除。换句话说,代理IP池不是“IP堆”,而是一套可分配、可检测、可恢复的IP资源库。
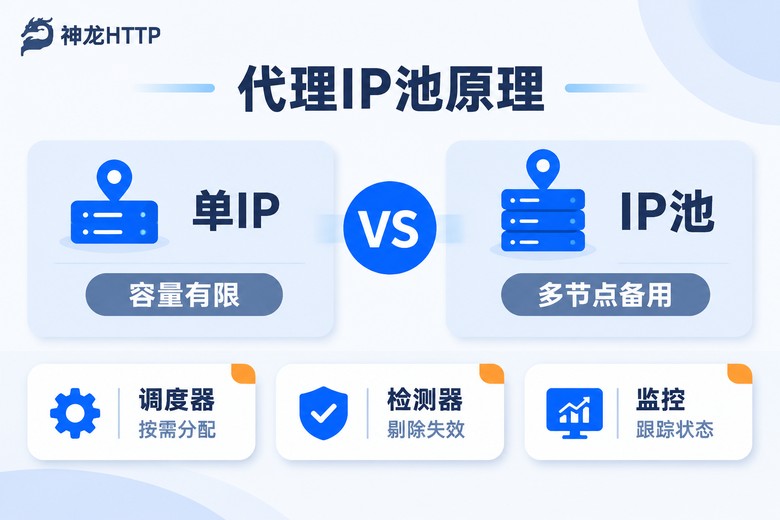
打个比方,单个代理IP像一辆车,能跑,但一旦限行、故障或到达终点,任务就卡住。代理IP池则像一支车队,调度员可以根据路况、目的地和车辆状态,给任务分配合适的车。任务多了,车队也能并行跑,不会把所有压力压到一辆车上。
原理:请求为什么会绕到池里
正常情况下,程序发请求会直接带着自己的出口IP去访问目标。使用代理IP池后,请求会先交给池内的调度层。调度层从可用IP里挑一个,把请求通过代理节点发出去。目标端看到的,就是代理节点的IP,而不是你本地的IP。
这里的关键不是“多一个IP”,而是池把IP变成了可管理的资源。一个IP可以记录城市、运营商、协议、延迟、可用状态、上次使用时间和失败次数。任务来了,调度层按规则取IP;任务失败,池会把这个IP标记为异常,下次少用或不用。这样,整体成功率会比“只有一个IP”稳定很多。
import random

pool = [
    {"ip": "1.2.3.4", "port": 8888, "city": "上海", "isp": "运营商A", "status": "ok"},
    {"ip": "5.6.7.8", "port": 8888, "city": "深圳", "isp": "运营商B", "status": "ok"},
]

def get_proxy(pool):
    ok = [item for item in pool if item["status"] == "ok"]
    if not ok:
        return None
    return random.choice(ok)
这段代码看起来很短,但已经体现了池的核心:先筛选可用IP,再按规则取用。真实业务里,取用规则会更复杂,比如优先选低延迟IP、优先选某城市IP、连续失败后进入冷却期。
搭建逻辑:从需求到监控的完整链路
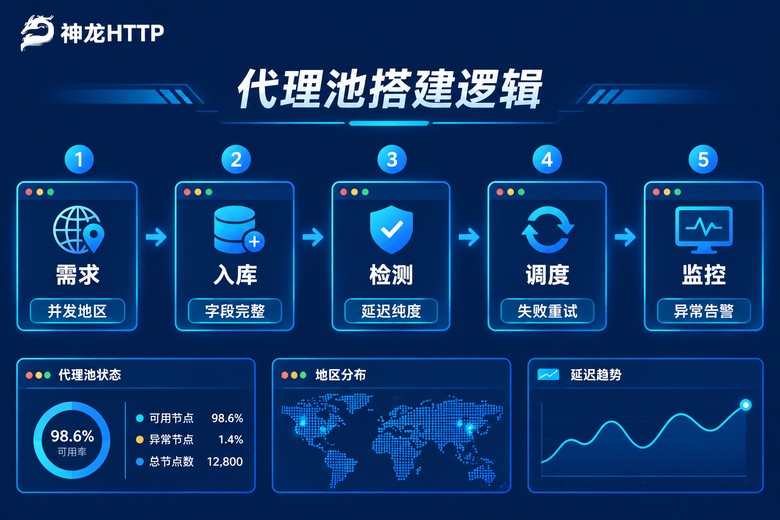
搭代理IP池,别一上来就找IP。先把需求写清楚:任务需要哪些地区,并发量大概多少,允许多少延迟,IP需要保持多久,协议是HTTP、HTTPS还是SOCKS5。需求没定清楚,池越大越乱。
第一步是入库。每个IP至少要有关联信息,不能只有地址和端口。城市、运营商、协议、账号归属、创建时间、最后检测时间,这些字段后面都会用到。第二步是检测。检测不是做一次就结束,而是持续做。延迟、可用状态、响应纯度、异常率,都要进记录。第三步是分组。同一类任务用同一组IP,避免不同业务互相影响。第四步是调度。调度决定“谁先用、谁后用、失败后怎么办”。第五步是监控。没有监控的池,就像没有仪表盘的车,跑久了也不知道哪里出问题。
调度策略常见有几种:随机取用适合简单任务;固定取用适合需要稳定出口的任务;失败重试适合临时异常;冷却机制适合避免反复打到坏IP。下面是一个带重试的示例:
def fetch_with_proxy(target_url, pool, retries=3):
    for _ in range(retries):
        proxy = get_proxy(pool)
        if proxy is None:
            break
        try:
            # proxy_url 由代理服务提供,这里不写具体地址
            response = requests.get(target_url, proxies={"http": proxy_url}, timeout=8)
            if response.status_code == 200:
                return response.text
        except Exception:
            pool[pool.index(proxy)]["status"] = "bad"
    return None
这个示例的重点是:失败不要只重试,还要把失败信息写回池里。池的价值,就是让“坏IP”尽快退出可用队列。
什么时候该自建,什么时候直接用成熟池
自建代理IP池适合对数据链路、字段结构、调度策略有明确要求的团队。你可以完全控制检测阈值、分组规则、告警方式和成本边界。但代价也很明显:找源、清洗、监控、协议兼容、异常处理,每一段都要人盯。IP数量少时还好,数量一多,维护成本会快速上升。
如果业务目标是公开数据采集、市场研究或AI大模型训练,而且不想把团队时间耗在维护IP上,可以直接使用成熟代理IP服务。神龙HTTP提供3000万+正规授权代理IP储备,支持API接入,兼容主流爬虫编程语言,文档和示例代码也比较直接。接入后,你主要关注任务逻辑,IP的可用性、提取速度和基础监控交给服务方。
| 维度 | 自建代理IP池 | 使用神龙HTTP代理IP池 |
|---|---|---|
| IP来源 | 需要自行寻找、测试和清洗 | 提供3000万+正规授权代理IP储备 |
| 维护成本 | 需要持续检测、分组和告警 | 由服务方持续维护,用户关注任务本身 |
| 接入方式 | 需要自己写入库、调度和重试逻辑 | 提供API,兼容主流爬虫编程语言 |
| 适合场景 | 强定制、强控制、长期技术投入 | 快速上线、稳定取用、降低维护负担 |
我的建议是:先用最小池跑通任务,再决定要不要自建。最小池可以只有几十个IP,但必须包含状态、延迟和失败记录。跑通后,再看并发和地区需求,决定扩大规模还是接入成熟服务。
常见问题
Q: 代理IP池和单个代理IP有什么区别?
A: 单个代理IP只能承担一条链路,池则是一组可管理IP。池能做检测、分组、分配和容错,任务失败时可以从池里获取新的IP,而不是整条任务卡住。
Q: 代理IP池越大越好吗?
A: 不是。数量只是基础,真正影响效果的是可用状态、延迟、地区匹配和调度策略。一个管理良好的中等规模池,往往比一堆失效IP更有用。
Q: 动态池和固定池怎么选?
A: 公开数据采集、市场研究这类任务,常用动态池,因为需要不断获取新的IP来应对临时异常。长期固定出口、需要稳定IP的任务,更适合固定IP。选择时先看任务对IP稳定性的要求,再看数量。
Q: 自建代理IP池最难的地方在哪里?
A: 不是写代码,而是持续维护。IP会失效、延迟会波动、异常会积累。检测、冷却、告警和用量统计做不好,池很快会失去稳定性。这也是很多团队会选择神龙HTTP这类成熟服务的原因。