一个跑到第四十小时的任务,是怎么翻车的
前阵子帮人看一个公开数据采集的项目。量不算大,一天两万来条公开页面,计划跑三天。前面三十九个小时都挺顺,第四十个小时的凌晨两点,日志里开始成片地报连接超时。等早上他打开电脑,进度条卡在 78%,重试队列里堆了三千多条待补的链接。
他说的一句话特别典型:"我测的时候挺快的啊。"
问题就出在这个"快"字上。跑十分钟的测试,只能证明这十分钟里链路是通的,证明不了四十个小时里它一直是通的。长周期任务真正吃的不是峰值速度,而是你那条链路在半夜、在目标站抖动、在某个出口节点被挤爆的时候,还能不能自己爬回来。
下面这套东西是我自己做链路验收时的顺序和阈值,谈不上多专业,但照着走能少踩不少坑。
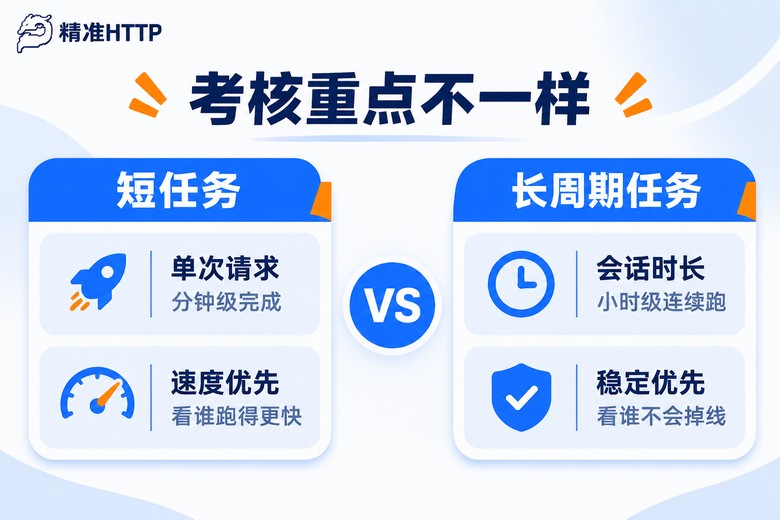
短任务看速度,长跑任务看曲线
这两类活对链路的要求,不是"高一点低一点"的差别,是方向都不一样。
跑十分钟的活,你关心的是这一下能不能过;跑三天的活,你关心的是第 200 次请求和第 20000 次请求的成功率是不是还一样。我见过太多这种情况:开头十分钟成功率 98%,两小时之后掉到 70%,一查原因,某个节点白天闲得很、晚上被挤到没法用。你测的时候刚好是它最舒服的时间段。
| 关注点 | 十分钟的测试 | 三天两夜的任务 |
|---|---|---|
| 核心指标 | 单次请求有多快 | P95 延迟和抖动幅度 |
| IP 使用方式 | 一次一换也无所谓 | 同一会话要能撑住 |
| 失败的处理 | 重试一次就过去了 | 失败会不会越滚越大 |
| 看什么数据 | 最后有没有跑完 | 每小时的成功率曲线 |
五个验收指标,阈值我一般这么定
提取成功率。连续调 200 次取 IP 的接口,看有多少次是正常返回的。这个数字低于 99% 就别急着上任务了,因为长跑过程中你要调用它成百上千次,一次异常就可能卡住整个队列。
首次连通率。拿到 IP 之后立刻去打目标站,第一次就成功的比例。有些资源看着量很大,但拿到的 IP 里有一部分是"死的",第一次请求就超时。我的及格线是 95%,低于这个数,你会花很多时间在无意义的等待上。
会话保持时长。同一个 IP 连续请求,直到它失效为止,能撑多久。这个指标最容易被忽略,但它是长周期任务的分水岭——需要登录态、需要连续翻页、需要保持同一个出口的场景,IP 换得太勤,前面拿到的上下文全废了。
延迟抖动,看 P95 和 P99,别看平均值。平均值 300ms 听着挺好,但如果 P99 是 4000ms,那你每一百次请求里就有一次要卡四秒,一个百万级的任务能为此多跑好几个小时。我一般要求 P99 不超过平均值的 3 倍。
故障恢复耗时。人为掐断一次,从失败到下一次成功,中间隔多久。这个数字决定了你的任务在凌晨掉线之后,是十分钟自己缓过来,还是等你早上起床手动重跑。
| 指标 | 怎么测 | 我用的及格线 |
|---|---|---|
| 提取成功率 | 连续调取 IP 接口 200 次 | ≥ 99% |
| 首次连通率 | 拿到 IP 立刻打目标站 | ≥ 95% |
| 会话保持 | 同一 IP 请求到失败为止 | 静态 ≥ 30 分钟 |
| 延迟抖动 | 统计 P95 / P99,不看平均 | P99 < 平均 × 3 |
| 故障恢复 | 掐断后到下一次成功 | < 10 秒 |
| 并发爬坡 | 10 → 50 → 100 并发 | 失败率不随并发线性上涨 |
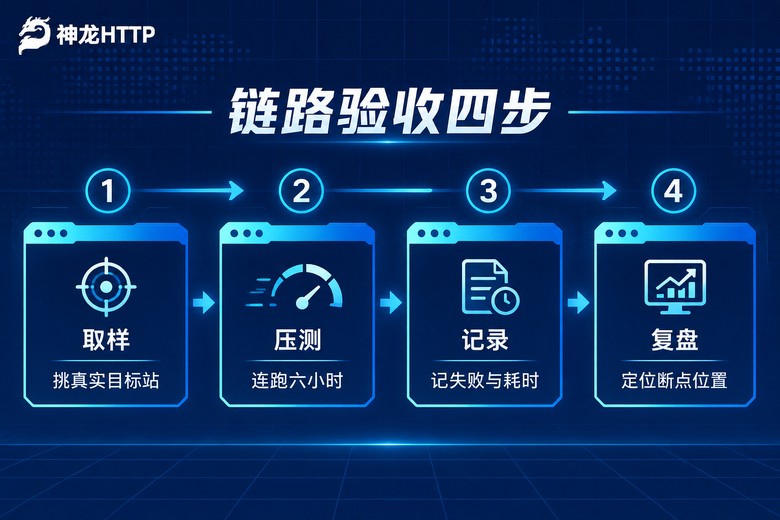
压测别用测速网站,拿你自己的目标站跑六小时
这一点很多人会偷懒。测速网站告诉你"这个 IP 到某地的延迟是 120ms",听起来不错,但它测的不是你要打的那个站,也不带你的请求头、你的 Cookie、你的翻页逻辑。真正的验收,一定是拿业务本身的请求去打。
我常用的做法很简单:挑 20 条真实链接,用小并发连续跑六个小时,中间把每次请求的结果都记下来。脚本没什么花哨的,几十行就够。
import time, requests

TARGET = "你的目标公开页面地址"
API = "服务商的提取接口地址"
PROXY = {"http": "", "https": ""}

def pick_ip():
    r = requests.get(API, timeout=5)
    ip = r.text.strip()
    return {"http": f"http://{ip}", "https": f"http://{ip}"}

def run_one(url, proxy, rounds=5):
    ok, costs, first_ok = 0, [], False
    for i in range(rounds):
        t0 = time.time()
        try:
            requests.get(url, proxies=proxy, timeout=8,
                         headers={"User-Agent": "Mozilla/5.0"})
            ok += 1
            if i == 0:
                first_ok = True
            costs.append(round(time.time() - t0, 3))
        except Exception:
            costs.append(None)
        time.sleep(1)
    return first_ok, ok, costs

# 主循环:每轮换一个 IP,把结果追加进 csv
while True:
    proxy = pick_ip()
    first, ok, costs = run_one(TARGET, proxy)
    print(time.strftime("%H:%M"), first, ok, costs)
    time.sleep(2)
跑完之后,你手上会有一张很朴素的表:每个 IP 第一次通没通、五次里成功几次、每次耗时多少。就看三种典型曲线——
成功率从头到尾是一条平线,可以放心上任务;前半小时漂亮、后面断崖式下跌,多半是会话保持的问题,得换成能长时间保持的静态线路;耗时慢慢往上爬,比如从 300ms 一路涨到 2s 以上,那说明你用的节点在被持续挤压,白天测不出来,晚上才现原形。
掉线之后,先分清是谁的锅
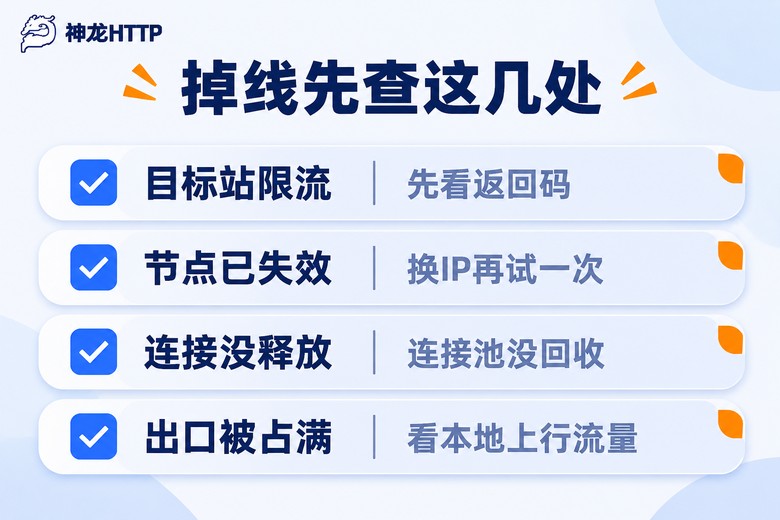
任务断了,第一反应别是"代理不行"。我排查的顺序是这样的:
先翻日志里的返回码。如果大量是 429 或 403,那是目标站在限流,跟链路稳不稳没关系,你要调的是请求间隔和并发数。如果是一水儿的连接超时、connection reset,那才轮到怀疑节点。
再看是不是代码没把连接释放掉。这个坑我自己踩过:请求失败之后连接没关,句柄越积越多,跑到几万次之后本地就卡死了,表现跟代理掉线一模一样,换个服务商也白搭。
然后看本地上行带宽。一百个并发同时拉页面,出口被自己占满,延迟一样会飙。
最后才是换节点复测。同一个链接、同一个时间点,换一条线路再打一次,能通就说明是节点问题,把这条线路从池子里摘掉就行。
选服务商时,我一般只问三个问题
第一个:静态线路能保持多久,中途会不会被动切走。长周期任务里,能长时间保持同一个出口的线路价值很高,尤其是需要连续翻页、带登录态的采集。
第二个:有没有能看历史数据的面板。只看当下的"可用率 99.9%"意义不大,你要看的是过去 24 小时每小时的曲线有没有毛刺。神龙HTTP 的个人中心里有可视化的用量统计和实时监控,异常能识别出来,使用趋势也能看,做长跑任务时这点挺省心——半夜掉没掉线,第二天打开面板一眼就知道是哪一段出的问题。
第三个:出问题多久有人回。这类事基本都发生在非工作时间。神龙HTTP 的技术团队是 7×24 小时支持,接口兼容主流爬虫语言,文档和示例代码都有,接进去通常一两个小时的事。
顺带说一句资源本身:神龙HTTP 有 3000 万+正规授权代理 IP 储备,国内三大运营商正规授权,可用率 99.9%,IP 纯度 99.8%,覆盖 300+ 城市级定位,支持 HTTP/HTTPS/SOCKS5。产品线分了短效动态、长效静态和固定 IP 代理,长周期任务优先选长效静态那类,别用短效的硬扛。
常见问题
Q:长周期任务是不是必须用长效静态 IP?
不一定,但要看你的任务对会话的依赖程度。如果只是抓公开列表页,每条链接互相独立,短效动态 IP 换得勤一点反而更安全;如果涉及连续翻页、需要保持同一个出口的上下文,那长效静态或者固定 IP 更合适。判断标准很简单:IP 一换,前面的状态是不是就白做了。是,就选静态。
Q:延迟 200ms 算快还是慢?
单看这个数没意义。国内公开站点,200ms 到 400ms 都算正常;真正要看的是同一批 IP 在六个小时里,P95 有没有从 300ms 涨到 1500ms。稳定在 400ms 的线路,比平均值 200ms 但时不时蹦到 5 秒的线路好用得多。
Q:任务跑到一半掉线,代码里怎么兜底?
三个动作就够:失败链接单独进重试队列,别让主队列卡住;单个 IP 连续失败三次就标记停用,换一条新的继续;每跑一千条落一次盘,把已完成的位置记下来。这样即使凌晨断了,第二天从断点续上,损失也就是那一段没跑完的,不至于整批重来。
Q:价格特别低的那种代理,能扛住三天两夜吗?
大概率扛不住,但不是因为"便宜",而是因为那类资源通常是很多人共用一个池子,你没法知道它什么时候被挤爆。长周期任务最怕的就是不可预测,宁可一开始就用有明确可用率承诺、有监控面板能回看的服务,省下来的排查时间比省下的那点成本值钱得多。