先看清:接口给你吐出来的到底是个什么东西
第一次翻代理IP文档的人,大概都会有这种体验——每个字都认识,连起来不知道在说什么。提取链接、白名单、隧道、鉴权,一堆词砸过来就懵了。
把话说白:调用代理IP接口,就是让你的程序发一个网络请求过去,对方回你一串"能用"的地址。长这样:
112.85.131.7:4521
112.85.131.8:4521
112.85.131.9:4521
冒号前面是IP,后面是端口。你把这两样拼进代码里,请求就会从这串地址出去,而不是从你自己的机器出去。
市面上常见两种形态,别搞混:
一种是主动提取型。你调一次接口,它给你一批IP,用多久看你买的套餐。用完你再调一次,换一批新的。适合那种"一次跑一批任务、跑完就换"的场景。
另一种是隧道转发型。接口地址和端口是固定的,每次你往这个固定入口发请求,它在背后自动给你换出口。你代码里写死一个地址就行,不用反复取IP。适合长时间挂着跑的任务。
先想清楚自己属于哪一种,再往下看,否则后面参数填得再对也是白搭。
鉴权这一步,八成的坑都埋在这里
鉴权说白了就是"证明这通请求是你发的"。主流的做法有三种,选错一种,后面全流程都在报错。
| 鉴权方式 | 怎么配 | 适合谁 | 常见翻车点 |
|---|---|---|---|
| IP白名单 | 把本机公网IP填进后台,接口就不校验账号了 | 服务器固定、跑定时任务的 | 换了网络、重启路由器,公网IP变了没同步 |
| 账号密码 | IP拼成 用户名:密码@IP:端口 的形式 | 多台机器共用一套资源 | 密码里有特殊字符,没做URL编码 |
| API Key | 把密钥当参数拼在接口请求里 | 脚本、临时调试、多人协作 | Key写进了公开仓库,被人蹭用 |
我自己踩过最蠢的一次,是在家里调试通了,第二天把脚本丢到公司服务器上跑,直接一片 403。折腾半小时才反应过来——白名单里绑的还是家里那条宽带出去的地址。这类问题跟代码质量一点关系没有,纯粹是配置没跟上环境。
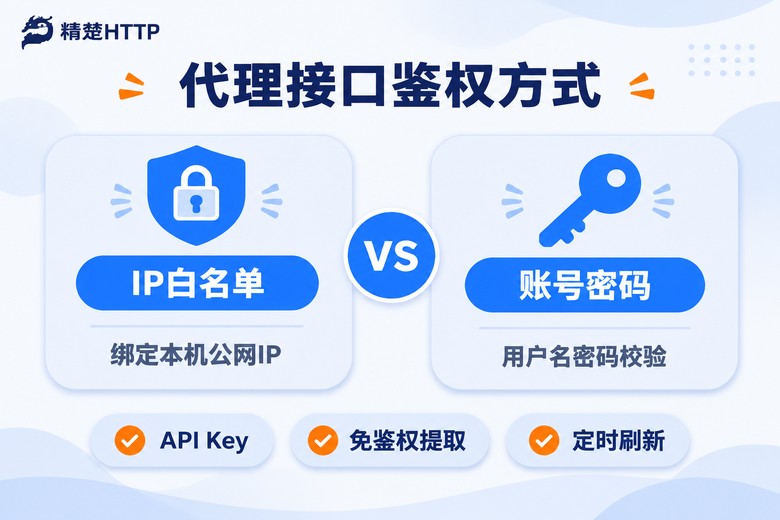
选的时候有个简单判断:如果你的机器出口IP长期不变,白名单最省事,因为调用接口时完全不用带任何身份信息,链接干净好维护;如果要在几台机器间来回切换,那就走账号密码,一台一份配置,互不干扰。
一次完整的调用,从拼参数到拿到IP
参数不用全填,但有几个是有实际影响的,挨个说:
数量——一次要几个IP。别一上来就填几百,先填3到5个试,跑通了再放量。协议——HTTP 还是 SOCKS5,跟你后续代码里写的一致就行,写错会连得上但请求发不出去。地区——想要哪个城市的出口。填得越细越容易返回空列表,从省份开始试更稳。格式——JSON 还是纯文本。要程序解析就选 JSON,肉眼看着核对就选纯文本。
用 Python 举例,一次调用大概长这样:
import requests

API = "服务商文档里给你的提取地址"
params = {
    "key": "你的密钥",
    "num": 5,          # 提取数量
    "protocol": "http",
    "area": "上海",
    "format": "json",
}

resp = requests.get(API, params=params, timeout=10)
result = resp.json()

if result.get("code") == 0:
    for item in result["data"]:
        print(item["ip"], item["port"])
else:
    print("没取到:", result.get("msg"))
返回体一般是固定结构:一个状态码、一句提示、一个数组。数组里每个元素带 ip、port,有的还会带过期时间。把 ip 和 port 拼成 ip:port 字符串存进列表,这一步就结束了。

有个细节很多人会漏:拿到IP不等于能直接用。建议在正式跑任务前加一次轻量校验,随便挑个稳定的小页面发个请求,两秒内没回来就换下一个。这一步能挡掉一大半"任务跑到一半全挂"的情况。
拿到IP之后,怎么挂进你的请求里
以 requests 为例,就一个 proxies 参数的事儿:
proxies = {
    "http":  "http://用户名:密码@112.85.131.7:4521",
    "https": "http://用户名:密码@112.85.131.7:4521",
}

r = requests.get("你要访问的页面", proxies=proxies, timeout=8)
print(r.status_code)
注意 http 和 https 两个键都要写。只写 http 的话,遇到 https 的目标地址,请求会绕过代理直连,而你往往还察觉不到——看日志以为是代理生效了,其实一直是本机在跑。
如果要做成一整段会话都走同一个出口,就用 session:
s = requests.Session()
s.proxies.update(proxies)
s.get("你要访问的页面", timeout=8)
s.get("另一个页面", timeout=8)
用 session 的好处是连接复用,同一批任务里不用每次都重新握手,整体耗时会明显下降。
报错不用慌,对着这张表查
接口调不通,绝大多数情况就那么几种。挨个排,别乱改代码:
| 现象 | 最可能的原因 | 怎么处理 |
|---|---|---|
| 返回 403 / 鉴权失败 | 本机公网IP变了,白名单没同步 | 去后台重新绑定当前出口IP |
| 返回 429 / 频率限制 | 调用得太密,超过约定的间隔 | 两次提取之间留出间隔,别死循环硬刷 |
| 返回空列表 | 地区条件太窄,当前没有匹配资源 | 把地区放宽到省份,或去掉地区参数 |
| 提示成功但连不上 | IP到期了 / 协议写错 | 核对过期时间,检查 http 与 socks5 是否填反 |
| 请求一直超时 | 目标地址本身慢,或代理池里这颗IP不可用 | 换下一个IP重试,加超时兜底 |

建议在代码里给每个IP记两样东西:提取时间、失败次数。失败两次的直接从池子里剔掉,别反复试。这个习惯养成之后,任务成功率会稳很多。
选服务商时,盯着这几个硬指标看
接口这东西,参数和返回格式各家大同小异,真正拉开差距的是背后的资源池和稳定性。跑大规模采集的时候,池子不够大,你调一百次接口也是那几颗IP轮流转,很快就没得用了。
神龙HTTP在这块的底子是:3000万+正规授权代理IP储备,可用率99.9%,IP纯度99.8%,覆盖300+城市级定位,国内三大运营商正规授权,支持 HTTP / HTTPS / SOCKS5 三种协议。产品线上分短效动态IP、长效静态IP、固定IP代理,短任务用动态、需要稳定出口用静态,按场景挑就行。
对接体验上,接口兼容主流爬虫编程语言,文档和示例代码都给全了,拿过去改两个参数就能跑。个人中心里有可视化用量统计和实时监控,能看出调用趋势,也能识别异常调用——这对排查"到底是接口问题还是脚本问题"特别有用。遇到卡壳的地方,技术团队7×24小时在线,不用干等。

常见问题
Q:接口返回成功,但代码里用起来一直报连接错误,是代理坏了?
先排除协议写错。很多人照着示例复制,结果是http的地址被塞进了https的位置,或者反过来。第二看IP有没有过期,提取时返回的过期时间经常被忽略。第三才是换IP重试,一般连试两颗都不通,就说明不是单颗IP的问题了。
Q:白名单和账号密码能同时开吗?
大部分情况下可以,但没必要。两个都开反而容易搞混:你以为走的是白名单,实际程序里还带着账密,出问题时排查方向就乱了。建议一个环境只保留一种鉴权方式。
Q:一次提取多少个IP比较合适?
看你的任务节奏。如果单个任务的请求量不大,一次提5到10个,用完再提,比一次提一大把放着过期更划算。提取频率太快容易触发限流,两次之间留个几秒间隔,稳得多。
Q:本地调试通了,部署到服务器就403,怎么回事?
九成是白名单绑的是本地宽带出去的地址,服务器出口是另一个。去后台把服务器的公网出口地址加进去,或者干脆改用密钥参数鉴权,换机器就不用再改配置了。