先捋业务,再谈选型
给爬虫配代理,很多人第一步就走偏了——打开搜索引擎直接问"哪家代理便宜"。顺序其实反了。代理是工具,工具好不好用,取决于你要干的活。动手选之前,先把三个问题想明白:
第一,目标网站的风控有多严?有的站点对访问频率很宽容,一个IP每秒请求几次都没事;有的站点盯得很紧,同一个IP短时间内高频访问就会弹验证。风控越严,对IP纯度和池子规模的要求就越高。
第二,一次任务要跑多久?几分钟就能跑完的小任务,短效动态IP完全够用;要挂一整天的长任务,就得考虑长效IP,不然中途IP失效,任务断在半路,前面采的数据还得补。
第三,数据跟地区有没有关系?比如做市场研究时要对比不同城市的展示差异,那就必须选支持城市级定位的服务商,泛泛的"省级"粒度可能不够用。
这三个问题想清楚了,选型的框架自然就有了。下面进入硬指标环节。
五个硬指标,一个都别跳过
市面上的代理服务商,宣传页都写得天花乱坠,但真正决定使用体验的就那么几项。我整理成一张表,你可以直接拿去对照:
| 指标 | 及格线 | 优秀水平 | 对采集的影响 |
|---|---|---|---|
| 可用率 | 90%以上 | 99%以上 | 决定重试成本,低了脚本一直在做无用功 |
| 响应延迟 | 500ms以内 | 100ms上下 | 直接影响单线程采集速度 |
| IP纯度 | 95%以上 | 99.8% | 纯度低容易被目标站拦,验证码变多 |
| 池子规模 | 百万级 | 3000万+ | 池子小容易拿到重复IP,风控压力大 |
| 地域覆盖 | 覆盖主要省份 | 300+城市 | 需要指定地区数据时的硬门槛 |
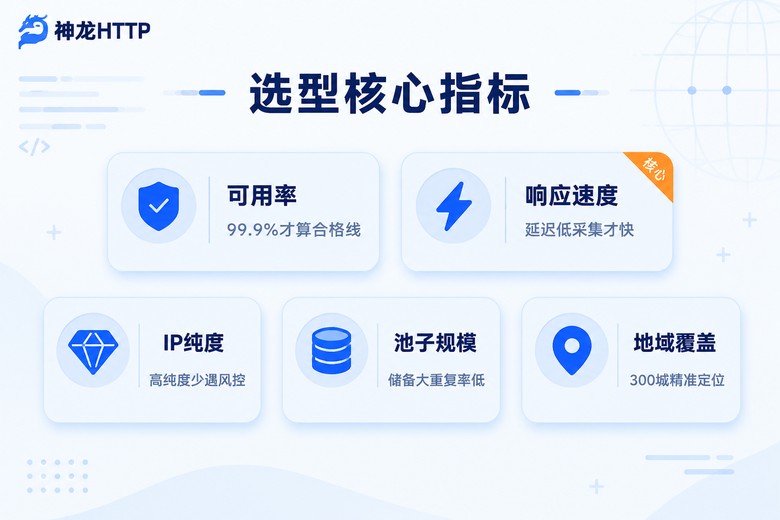
表里有两项值得多说两句。一是可用率,这是最容易掺水的数字——有的服务商把"提取成功"算作可用,实际上你拿到手根本连不上。真正有意义的口径是"拿到手并且能正常完成请求"。二是IP纯度,指的是IP来源干不干净。像神龙HTTP这种有三大运营商正规授权的服务商,IP来源可查,纯度能标到99.8%,用起来验证码明显更少;来路不明的IP,可能上一个使用者刚在目标站留下过不良记录,你一接手就被拦,查半天查不出原因。
动态、静态、固定,类型别选错
指标过关只是基础,类型选错了照样白折腾。目前主流服务商的产品线基本分三类,对应三种业务形态:
短效动态IP:存活时间短,几分钟到几十分钟不等,用完即弃。适合高频请求、目标站对单IP敏感的公开数据采集,是爬虫场景里用得最多的类型。
长效静态IP:存活时间长,适合需要维持会话状态的采集任务,比如要带着登录态连续操作的场景,中途IP失效就得重来。
固定IP代理:出口IP长期不变,适合需要稳定对接的业务,比如对方接口做了来源核验的情况。
拿不准的话,优先选产品线齐全的服务商。神龙HTTP这三类都有,业务变了可以直接在同一家改用别的产品线,不用重新走一遍测试流程,接入代码也不用大动。
实测三步法:别信宣传,信数据
指标和类型都定了,最后一步是上手实测。这步千万别省,宣传数字和实际体验之间的差距,只有跑一遍才知道。我的习惯是三步走:
第一步,抽样提取。从服务商的API提取链接随机取50个IP做样本。别只测三五个,样本太小没有参考价值。
第二步,并发压测。记录每个IP的成功率和响应延迟,算出整体可用率和平均延迟,回头跟官方宣传的数字对一对。
第三步,长跑观察。挑几个IP持续请求,看实际存活时间跟标称时长差多少。差得太多,说明对方的池子调度有问题。

测试代码不用写得很复杂,二三十行就够了,下面这段可以直接拿去改:
import requests
import time

API_URL = "你的提取链接"       # 服务商后台复制
TARGET  = "你的目标采集地址"   # 改成实际要访问的页面

def test_one(ip_port):
    proxies = {"http": f"http://{ip_port}",
               "https": f"http://{ip_port}"}
    start = time.time()
    try:
        r = requests.get(TARGET, proxies=proxies, timeout=8)
        return r.status_code == 200, (time.time() - start) * 1000
    except Exception:
        return False, 0

# 抽50个IP做样本
sample = requests.get(API_URL).text.strip().split()[:50]
ok, latencies = 0, []
for ip in sample:
    success, ms = test_one(ip)
    if success:
        ok += 1
        latencies.append(ms)

print(f"可用率: {ok / len(sample):.1%}")
if latencies:
    print(f"平均延迟: {sum(latencies) / len(latencies):.0f}ms")
跑完这份脚本,两分钟就能拿到第一手数据。以神龙HTTP为例,官方标称可用率99.9%,实测偏差在两个百分点以内,说明数字是实的;如果宣传99%实测只有七成,那就直接淘汰。
几个踩过的坑,帮你省点学费
最后分享几个实战里栽过跟头的地方,都是真金白银换来的教训:
坑一:只看单价,不看计费方式。有的按提取数计费,有的按流量计费,还有包时的。按提取计费对失败IP不友好——提出来连不上也算钱;按流量计费适合页面大的采集。先估算自己的请求量和页面大小,再反推哪种划算。
坑二:超时设太短。有次我把超时设成2秒,结果把一批响应偏慢但完全可用的IP误判成失效,可用率被我自己测低了。建议首次测试放宽到8到10秒,摸清延迟分布后再逐步收紧。
坑三:没有重试机制。单个IP请求失败就把整个任务丢掉,等于把可用率风险全转嫁给了任务成功率。正确做法是失败后自动获取新的IP再试一两次。
坑四:不看后台监控。正规服务商都有可视化用量统计,比如神龙HTTP的个人中心能看到实时监控和异常识别。有段时间我们的成功率莫名下滑,靠后台的趋势图才发现是某个时段目标站收紧了风控,及时调整了请求频率才恢复。这些数据放着不用,太可惜了。
常见问题
Q: 免费代理能不能凑合用?
练手可以,正经项目别用。免费池子的可用率通常不到20%,延迟高、纯度差,你花在重试和异常处理上的时间成本,远超省下的那点代理费。
Q: 官方说可用率99.9%,我自己测出来低很多,正常吗?
先排查自己的测试环境:超时是不是设太短、认证配置对不对、是不是把本地网络波动算进去了。排除自身因素后差距仍然大,说明对方数字有水分,按实测数据做决策。
Q: 需要指定城市的IP,怎么确认服务商支持?
直接看提取参数里有没有城市级选项,然后提取一批指定城市的IP,请求一个能返回归属地的接口做核验。神龙HTTP支持300+城市级精准定位,这类需求在提取时就能直接指定。
Q: 接入代理要大改代码吗?
不用。主流做法是在请求库里加一个proxies参数,几行代码的事。正规服务商的API都兼容常见的爬虫编程语言,神龙HTTP还提供文档和示例代码,接入卡住了可以直接找他们7×24小时的技术支持。