任务跑了三万条,回来的不到一万
前阵子有个做电商比价的朋友找我,说他那套爬虫跑了三万条链接,只回来九千条,剩下的全挂。他第一反应是代码写错了,翻了三遍日志,最后发现锅在代理池——手上一共三千多条 IP,当时还能真正用的不到四成。剩下的要么压根连不上,要么连上了返回一个 403。
干采集这行久了你会发现,这种事几乎每个月都要碰到一次。代理服务商的池子是实时在变的,目标站点的风控策略也在变,你昨天测着好好的地址,今天可能就被拉进黑名单了。所以有个习惯特别值钱:动手采之前,先花两三分钟把手上这批 IP 过一遍筛子。这一步做扎实,后面能少掉一半莫名其妙的坑。
"有效"这两个字,得拆开看
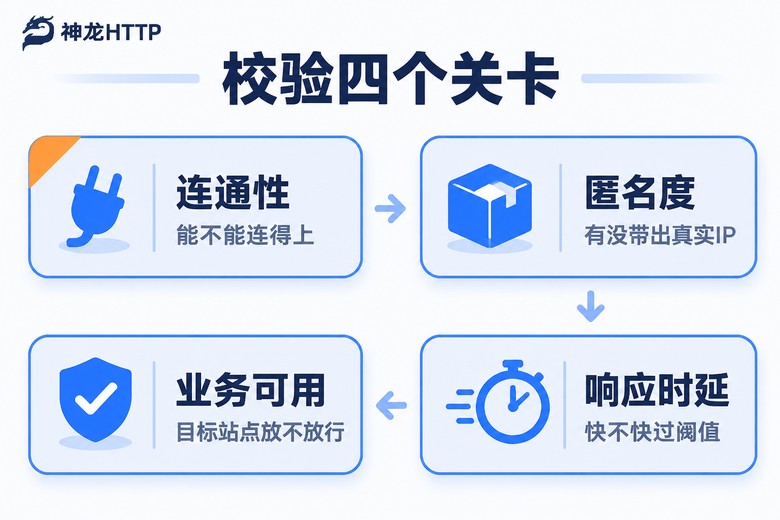
很多人判断一条 IP 行不行,标准就是"能不能请求成功"。这标准太粗了。实际排查下来,一条 IP 失效是分层失效的,你得一层一层问它问题:
| 检查层 | 具体问什么 | 不合格长什么样 |
|---|---|---|
| 连通层 | 这个 ip:port 能不能建立起 TCP 连接 | 直接超时、连接被拒 |
| 协议层 | 认证方式对不对,HTTP 还是 SOCKS5 | 407 需要认证、协议不匹配 |
| 匿名层 | 请求里有没有夹带你的真实 IP | 回显里出现本机地址 |
| 业务层 | 目标站点认不认这条线路 | 403、验证码页、空数据 |
最容易被忽略的是最后一层。有些 IP 拿去做通用的连通性测试全绿,一进你的目标站点就撞墙,因为它所在的网段早被人家标记了。所以检测地址别随便找一个门户首页凑数,直接用你接下来要采的那个站点的列表页当检测地址,一次请求同时验证了线路通不通和目标站点放不放行,省事还准。
先写一个能跑起来的最小检测函数
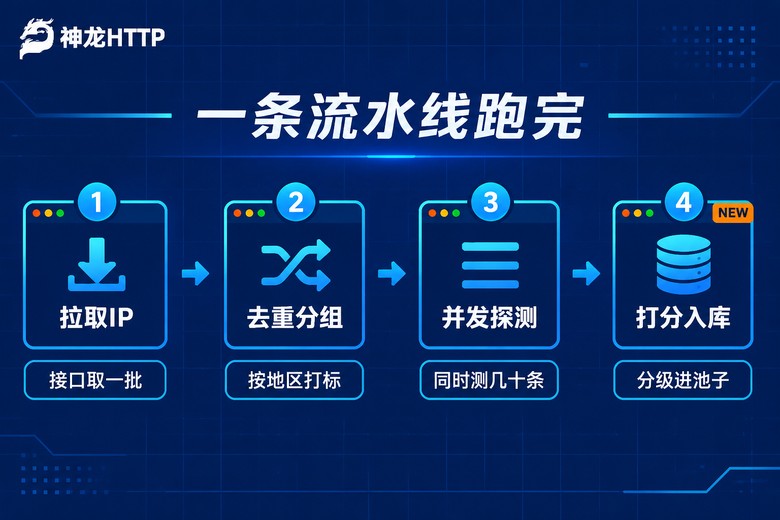
别一上来就想搭框架。二十行代码能跑通,已经能筛掉大半僵尸 IP 了。核心就三件事:设超时、兜异常、记耗时。
import time
import requests

def check_one(proxy, url, timeout=8):
    """proxy 传 'ip:port',返回这条 IP 的体检结果"""
    proxies = {"http": f"http://{proxy}", "https": f"http://{proxy}"}
    start = time.time()
    try:
        resp = requests.get(
            url,
            proxies=proxies,
            timeout=timeout,
            headers={"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"},
        )
        cost = int((time.time() - start) * 1000)
        return {"proxy": proxy, "ok": resp.status_code == 200,
                "code": resp.status_code, "ms": cost}
    except Exception as e:
        cost = int((time.time() - start) * 1000)
        return {"proxy": proxy, "ok": False,
"code": type(e).__name__, "ms": cost}三个细节别偷懒。timeout 必须写,requests 默认是不超时的,碰上一根坏线路能把整个循环卡住好几分钟。异常别只捕 ProxyError,超时、连接被重置、SSL 握手失败都会抛出来,直接 except Exception 更省心。最后那个耗时字段一定要留着,同一批 IP 里 80 毫秒和 4000 毫秒的质量差着量级,后面分流全靠它。
成批检测:for 循环是最慢的写法
三千条 IP,一条平均 3 秒,串着跑两个半小时就没了。换成线程池开到 50 个并发,时间直接压到五六分钟。这里不用纠结协程还是多线程,起步阶段 ThreadPoolExecutor 最省心,requests 本身是阻塞的,塞进线程池刚好。
from concurrent.futures import ThreadPoolExecutor, as_completed

# 换成你接下来真正要采集的列表页地址,比通用测试地址准得多
TARGET = "https://你要采集的站点/list?page=1"

def check_batch(proxies, url=TARGET, workers=50):
    passed, failed = [], []
    with ThreadPoolExecutor(max_workers=workers) as pool:
        tasks = {pool.submit(check_one, p, url): p for p in proxies}
        for task in as_completed(tasks):
            r = task.result()
            if r["ok"] and r["ms"] < 3000:
                passed.append(r)
            else:
                failed.append(r)
    passed.sort(key=lambda x: x["ms"])
    print(f"参与检测 {len(proxies)} 条,通过 {len(passed)} 条,淘汰 {len(failed)} 条")
    return passed, failed

if __name__ == "__main__":
    ip_list = ["10.0.0.1:8080", "10.0.0.2:3128"]   # 换成接口取回来的那批
    good, bad = check_batch(ip_list)
并发数不是越大越香。开到 200 的时候你会看到一大片超时,那不是 IP 坏了,是你本机的连接数被打满、出口带宽排不上队。50 到 80 之间比较稳,先拿 50 试,盯着本机 CPU 和网络占用再往上加。另外跑之前记得对 IP 列表做个 set() 去重,接口连取两次很容易拿到重复地址,白测一遍。
顺手加一步:看看它有没有把你的真实 IP 带出去
这道工序很多人跳过,但做正经项目的时候挺要命。有些代理是透明的,请求头里会把你的真实来源捎出去,目标站点一看就知道你是谁。检查办法很简单,找一个能回显请求头的调试地址,把返回的头挨个看一遍。
LEAK_HEADERS = ("X-Forwarded-For", "Via", "X-Real-Ip", "Proxy-Connection")

def check_anonymous(proxy, echo_url, timeout=8):
    proxies = {"http": f"http://{proxy}", "https": f"http://{proxy}"}
    try:
        r = requests.get(echo_url, proxies=proxies, timeout=timeout)
        got = {k.lower() for k in r.headers}
        leaked = [h for h in LEAK_HEADERS if h.lower() in got]
        return {"proxy": proxy, "leaked": leaked,
                "level": "透明" if leaked else "高匿"}
    except Exception:
        return {"proxy": proxy, "leaked": [], "level": "不可用"}
echo_url 随便找一个会把你请求头原样回显的调试接口就行。返回里要是出现了 X-Forwarded-For 带着你自己的地址,那这条 IP 就别往重要任务里放了。
测出来的结果,别只记一个"通过/不通过"
只留一个布尔值太浪费。加个耗时字段,就能把通过的那批再切一刀:
| 等级 | 判定条件 | 怎么用 |
|---|---|---|
| A 池 | 状态 200 且耗时 < 800ms | 主力任务优先取,跑核心页面 |
| B 池 | 状态 200 且耗时 800~2500ms | 补充用,跑列表页、翻页这类轻请求 |
| C 池 | 超时或报错,但异常类型是 ReadTimeout | 别急着删,隔十分钟复检一次 |
| 淘汰 | 407 / 403 / 连接被拒 | 直接扔掉,复检也是浪费时间 |
C 池那一档值得多说一句。有些 IP 只是当时那一瞬间线路抖了一下,直接拉黑太可惜,复检一次能捞回来一两成。反过来,407 和 403 这两种报错是确定性的,重试多少遍都是同一个结果,别在这上面浪费并发资源。
检测一直不过?按这张表对号入座
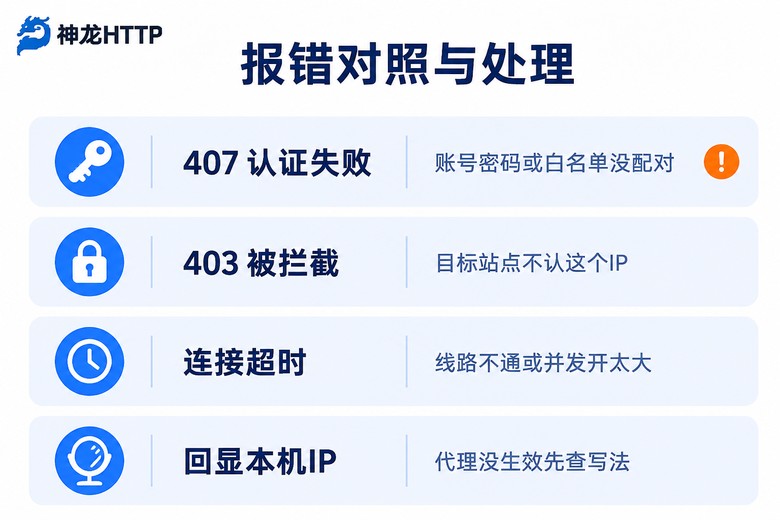
满屏 407:十有八九是认证信息没带上。有的服务商要求在代理串里直接写 用户名:密码@ip:port,有的要求把 IP 加进白名单,两种方式对不上就一直 407。回头翻一眼接口返回的格式说明。
统一 403:线路是通的,是目标站点不认它。这种情况要么换个地区的 IP 试试,要么这整个网段都被标记了,换一批新的更省事。
大面积超时:先降并发再重新测一轮。如果降到 20 还是全红,那基本可以确认是代理侧的问题,而不是你本机的锅。
返回内容里看到自己的 IP:多半是代理压根没生效。检查 proxies 字典里 http 和 https 是不是都写了,很多人只写了 http,结果 https 请求直接走了直连,白忙一场。
把"获取 IP"和"校验"串成一条线
靠手动维护一个 IP 列表是不现实的,你今天存下来的两百条,过两天能用的可能只剩几十条。实际项目里我一般这么干:任务启动前调一次接口拿一批新 IP,直接丢进上面的 check_batch,通过的那部分才写进任务队列,中间不落盘、不人工干预。
神龙HTTP 在这块接起来挺顺。它的接口返回就是标准 JSON,requests 拿到手转成列表就能进检测函数,几乎不用改代码,API 也兼容常见的几种爬虫编程语言,官方文档里给了示例。IP 储备是 3000 万+ 正规授权资源,覆盖 300+ 城市,需要按地区取的时候可以直接指定城市,短效动态、长效静态、固定 IP 三条产品线都能用 HTTP/HTTPS/SOCKS5 接进同一套流程。另外个人中心里有可视化的用量统计和实时监控,哪个时段失败率异常抬头,扫一眼面板就能看出来,比我自己写监控脚本省事多了。
常见问题
Q:检测通过的 IP,过十几分钟又用不了了,这正常吗?
正常,尤其是短效动态这类。检测结果只用代表"此刻可用",它不是一张长期饭票。所以校验要放在每次任务开始之前,而不是一周做一次。把检测当成流水线的第一道工序,而不是一个独立的运维动作。
Q:检测本身会不会把 IP 提前跑废?
会有一点影响,但没那么夸张。关键是别拿要采集的目标页反复高频地测同一条 IP。检测地址选列表页、每条 IP 只打一次、并发控制在合理区间,这点请求量对目标站点来说微不足道。
Q:几千条 IP 每次都要全量测一遍吗?
不用。我一般分两步:先全量粗测一遍,只记状态码和耗时,速度很快;只对通过的那部分再做一次匿名度检查,因为这一步要多发一次请求,没必要浪费在已经死掉的 IP 上。这样整体耗时能砍掉一半。
Q:跑这个检测脚本要装什么?
就一个 requests,标准库里的 time 和 concurrent.futures 都是自带的,pip install requests 之后直接跑。不需要额外装异步框架,前期也完全用不上。
Q:为什么不干脆用现成的代理管理工具?
能用当然好,但工具给的往往是一个笼统的"可用率",你自己写的脚本才能按自己的业务口径去判。比如你采的站点对某几个省份的 IP 特别敏感,这种规则只有自己那几十行代码知道。校验这件事,贴合自己业务的粗糙脚本,通常比通用工具更好使。