周一早上十点,季度复盘会。你刚开口讲第二页数据,屏幕上的人像就定格成了一个歪嘴的表情,声音断断续续像卡带。主持人问"你那边网络是不是有问题",十几双眼睛在会议窗口里齐刷刷看过来——这个场面,做过远程协作的人应该都不陌生。
很多人第一反应是"家里宽带不行",可实际换了套餐、换了路由器,问题照样出现。真正的毛病往往藏在你看不见的那一段链路上。这篇文章不讲空话,我按实际排查的顺序,把视频会议和远程协作里怎么用好高速电信ip代理做网络质量检查、怎么定位卡顿来源,一步步拆开讲。
一、先搞清楚:会议卡顿到底卡在哪一段
视频会议的数据流大概是这么走的:你的电脑 → 本地路由器 → 宽带运营商 → 中间若干跳骨干网 → 会议平台接入点 → 对方。任何一跳出问题,你看到的都是"卡"这一个结果,但原因完全不同。
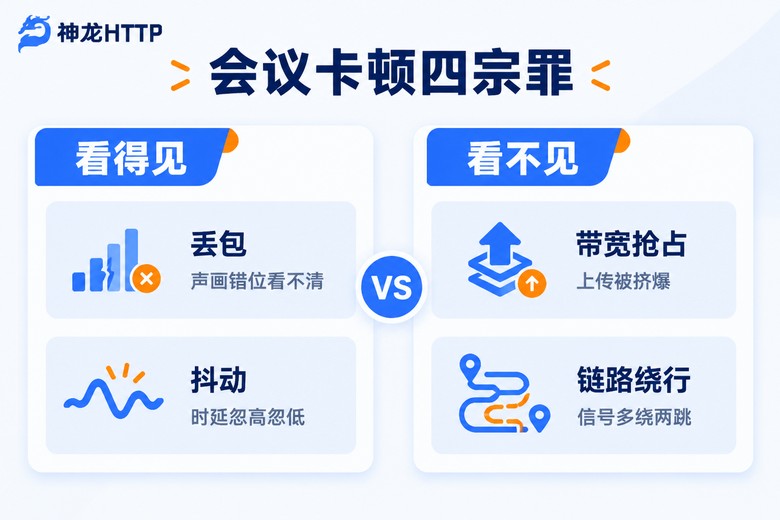
实操里最有用的判断方式是分四类看:
丢包——画面出现马赛克块、声音吞字。少量丢包还能靠算法补,一旦超过 1% 就会明显听得出来。
抖动——时延忽高忽低,你说话对方两秒后才听到,然后突然一连串涌过来。抖动比纯延迟更伤体验。
上传带宽被抢占——同一网络里有人在跑备份、下大文件,视频编码器拿不到足够的上行带宽,画面直接糊成一片。
链路绕行——明明同城开会,数据却绕到外地再绕回来,多两跳就多几十毫秒。
这四类里,前三类你在自己这边就能查;第四类恰恰是最容易被忽略的,因为它需要在不同地区、不同运营商线路上分别测一次才能对比出来。这也是为什么单靠办公室一条网线,永远说不清楚"到底是谁的问题"。
二、多地区链路体检:用代理IP当"远程探针"
思路很简单:把分布在不同城市的代理IP当成一个个临时探针,从这些节点去请求会议平台的鉴权接口、媒体调度接口,记录往返时延和抖动。这样你手里就有一张"哪个城市、哪条运营商线路,连会议平台更顺"的真实地图。
之所以强调高速电信ip代理,是因为国内团队里电信线路占比很高,南方城市尤其明显。拿电信线路的节点去做基准,测出来的结果更贴近大多数参会者的真实体感。如果测出来电信线路表现好、某条别的线路明显偏差,那基本就能锁定问题不在会议室,而在接入链路上。
下面是一段可以直接跑的巡检脚本,用 Python 的 requests 就行,不需要额外装什么复杂框架:
import time, statistics, requests

# 代理信息从服务商后台拿到,格式:http://用户名:密码@IP:端口
PROXIES = {
    "http":  "http://user:pass@112.xx.xx.10:8080",
    "https": "http://user:pass@112.xx.xx.10:8080",
}

# 换成你的会议平台域名或自建协作服务地址
MEETING_HOST = "https://your-meeting-platform.example"

ENDPOINTS = [
    "/api/v1/token",          # 鉴权:会议入场必经
    "/api/v1/media/route",    # 媒体调度:决定你连哪个接入点
]

def probe(path, times=8):
    rtts, fails = [], 0
    for _ in range(times):
        t0 = time.time()
        try:
            r = requests.get(MEETING_HOST + path,
                             proxies=PROXIES, timeout=6)
            if r.status_code == 200:
                rtts.append((time.time() - t0) * 1000)
            else:
                fails += 1
        except Exception:
            fails += 1
        time.sleep(0.4)
    if not rtts:
        return None
    return {
        "avg_ms": round(statistics.mean(rtts), 1),
        "jitter_ms": round(statistics.pstdev(rtts), 1),
        "loss_pct": round(fails / times * 100, 1),
    }

for ep in ENDPOINTS:
    print(ep, probe(ep))
跑完之后盯着三个数看:平均往返时延、抖动、丢包率。一般经验是——平均时延低于 60ms 算舒服,60~120ms 能正常开但会有点滞后,抖动超过 30ms 就会开始出现"抢话"的尴尬,丢包超过 1% 基本就要动手处理了。
同样的活,不想写脚本也可以用命令行快速验证一条链路:
curl -x http://user:pass@112.xx.xx.10:8080 \
     -o /dev/null -s \
     -w "连接:%{time_connect}s 首字节:%{time_starttransfer}s 总计:%{time_total}s\n" \
     https://your-meeting-platform.example/api/v1/token
把 IP 换成不同城市的节点,重复跑几遍,把结果填进 Excel。表格一列出来,哪条线路拖后腿一目了然。

三、远程协作场景别只测一个接口
视频会议只是其中一环。实际远程协作里还有一堆东西同时在跑:文档协同的实时同步、共享屏幕的画质、云盘的附件上传、代码仓库的拉到本地。这些东西对网络的要求不太一样,只测会议接口容易漏。
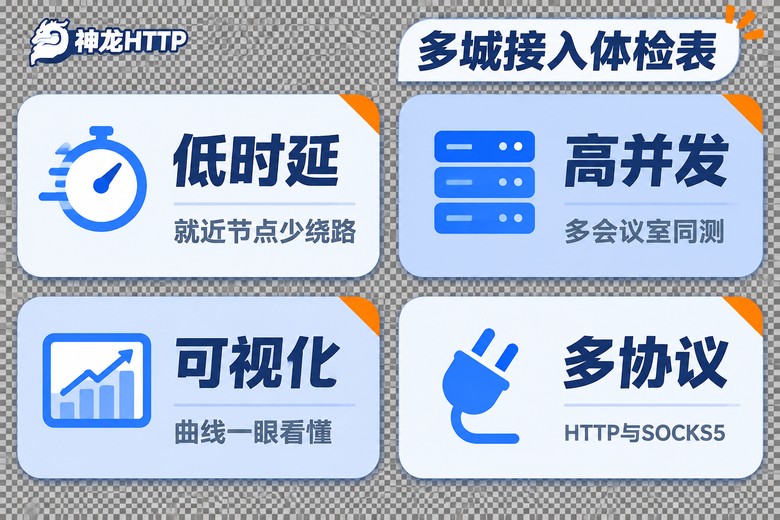
我一般按这个套路做一张"多城接入体检表",每个城市跑一轮:
| 检测项 | 用什么方式测 | 看什么指标 | 参考红线 |
|---|---|---|---|
| 会议入场(鉴权接口) | 代理节点 GET 鉴权地址 | 首字节时间、丢包率 | 丢包 >1% 需处理 |
| 媒体接入点调度 | 代理节点 GET 调度地址 | 往返时延、抖动 | 抖动 >30ms 需关注 |
| 协同文档实时同步 | 长连接心跳接口轮询 | 心跳间隔稳定性 | 连续 2 次超时告警 |
| 附件上传 | 代理节点上传 5MB 文件 | 上行速率、耗时 | 上行 <2Mbps 影响共享屏幕 |
再补一张不同运营商线路的对比,把测试城市、线路、时延、抖动、丢包都列清楚。下面是我按常见情况整理的示意表,你们实测时把数字换成自己的就行:
| 线路类型 | 同城平均时延 | 抖动 | 丢包 | 适合场景 |
|---|---|---|---|---|
| 电信线路 · 就近节点 | 15~35ms | 低 | <0.3% | 日常站会、一对一沟通 |
| 电信线路 · 跨省节点 | 40~80ms | 中 | 0.3%~0.8% | 多人评审、屏幕共享 |
| 其他线路 · 跨省节点 | 70~150ms | 偏高 | 1% 左右 | 仅作对比参考 |
看到这里应该能明白:问题不是"代理快不快",而是"你能不能拿到多地区、多线路的真实数据来做判断"。这个价值在远程协作团队里比什么都实在——尤其是在跟外部客户开会,对方一口咬定"是你们那边网络差"的时候,甩一张覆盖五个城市、三个运营商线路的巡检表过去,比解释十分钟都管用。
四、选节点、跑巡检,几个容易踩的坑
第一,别一直用同一个 IP 反复测。同一个 IP 时间长了,遇到限流或缓存,测出来的数据会失真。巡检脚本跑完一轮,拿一批新的 IP 继续,结果才有代表性。神龙HTTP 的短效动态 IP 就比较适合这种"测完就换"的用法,API 拉取后直接喂给脚本批量跑。
第二,长期盯的节点用静态的。如果你是给某个固定会议室做长期质量监控,需要连续几周记录同一条线路的趋势曲线,那就该用长效静态 IP 或固定IP代理,保证基准一致,不然前后数据没法比。
第三,定位精度很重要。300+ 城市级精准定位意味着你能把探针铺到二三线城市,而不是只有北上广深几个点。很多团队的会议卡顿恰恰发生在非一线办公室,只测大城市是测不出来的。
第四,把数据留下来。神龙HTTP 个人中心里有可视化用量统计和实时监控,配合你自己的巡检表看,异常时段和线路能对得上,分析趋势比单次测速有用得多。技术上有卡点也可以直接找他们的技术团队,7×24 小时都有人在。
至于集成成本,其实不高。HTTP/HTTPS/SOCKS5 三种协议都支持,API 兼容主流爬虫编程语言,文档和示例代码直接拿来改,上面那段 Python 脚本换个代理地址就能用。选型的时候挑一两个关键点对上就行,不用把参数表看花眼。
常见问题
Q:视频会议一卡,换个 IP 就能解决吗?
不一定,得先判断原因。如果本地路由和带宽都正常,测出来是链路绕行或者某条线路抖动大,那换一个就近地区的 IP、走更顺的线路确实有明显改善;但如果是会议室上行带宽被备份任务占满,换 IP 也没用,得先把带宽腾出来。
Q:用代理去测会议接口,会不会让会议本身更慢?
会有一点额外开销,所以要点在于"测"和"用"分开。建议的做法是用代理节点做分布式的质量巡检,拿到哪个地区哪条线路更顺的结论后,再去调整会议室的实际接入方式;不要一边开着高负载代理一边开正式会议。
Q:短效动态 IP 和长效静态 IP,巡检场景该用哪个?
两轮以上的横向对比、想覆盖更多城市节点,用短效动态 IP 更灵活,成本也低;如果要做连续多天的趋势监控、固定基线对比,用长效静态 IP 或固定IP代理,避免基准漂移导致数据不可比。两个搭配着用是最常见的做法。
Q:几个城市的分公司都要测,是不是得派人一台台机器去跑?
不用。把巡检脚本放到各分支的一台常开设备上,代理节点从服务商后台统一拉取,结果集中汇总到一张表里就行。API 提取的方式支持高并发,几十个节点同时跑一轮也就几分钟的事,做完把数据收回来画个趋势图,哪个点该优化一目了然。