先搞清楚:什么样的代理才算"可用"
不少人有这样的经历:从服务商那里提取了一批IP,直接塞进爬虫就开跑,结果十分钟不到,日志里全是超时重试,成功率从九成一路掉到五成。回头排查半天,发现问题不在代码,而是拿到的IP里本来就混着不少失效的。所以动手写采集逻辑之前,校验这一步不能省。
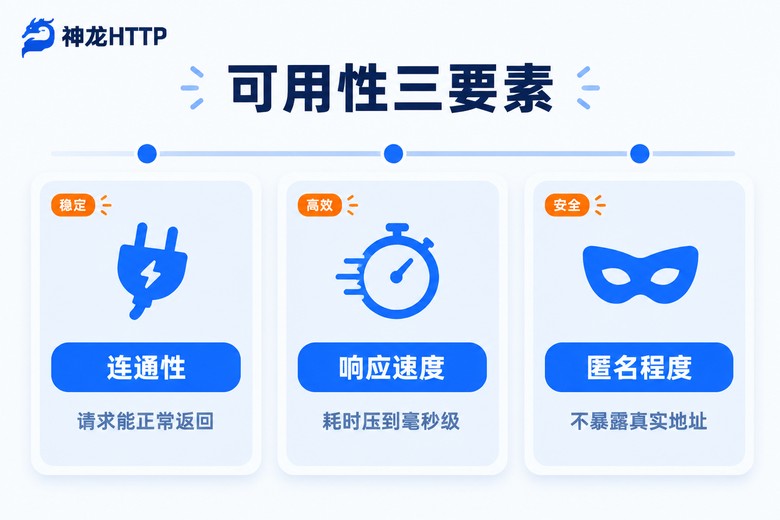
判断一个代理IP能不能用,不能只看"能不能连上",建议拆成三个维度来看:
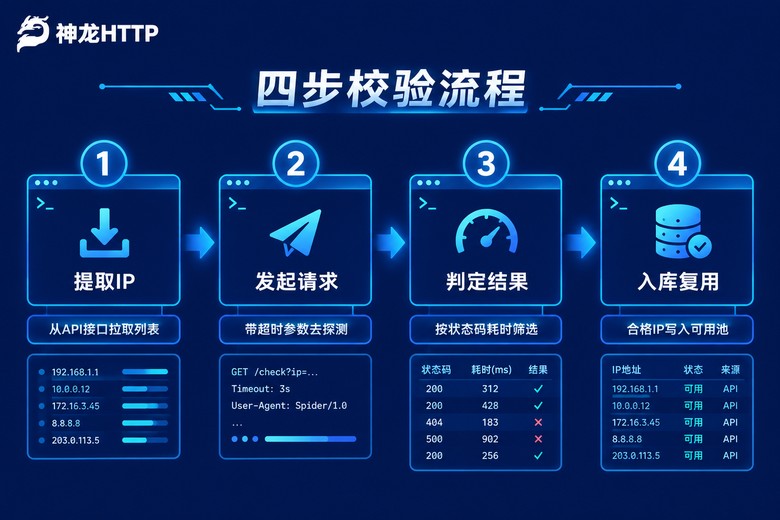
连通性:带着这个代理去请求一个目标地址,能拿到响应、状态码正常,才算活着。连握手都完不成的,直接淘汰。
响应速度:能返回和快速返回是两回事。一个8秒才吐出响应的IP,放进任务里只会拖慢整体进度,宁可不要。
匿名程度:看目标服务器看到的出口IP是不是代理本身的地址。如果把你本机的真实IP也带上了,这个代理的价值就打了折扣。
把这几条整理成一张表,校验的时候照着执行就行:
| 校验维度 | 合格标准 | 不合格怎么办 |
|---|---|---|
| 连通性 | 状态码200,响应体完整 | 直接剔除 |
| 响应速度 | 2秒内完成返回 | 2~5秒的降级观察,超过5秒淘汰 |
| 匿名程度 | 回显出口IP与真实IP不同 | 改用高匿名IP |
| 稳定性 | 连续2~3轮复检都通过 | 只通过一轮的先放观察区 |
前两条是硬门槛,后两条决定你愿不愿意继续用它。下面按从简单到复杂的顺序,把校验方案一个个落地。
基础版:带着代理发一次真实请求
思路很朴素——与其猜测,不如让代理自己跑一趟。用 requests 带上代理参数去访问一个回显服务,能按时把响应带回来,就说明这个IP是通的:
import time
import requests

def check_proxy(ip, port, timeout=5):
    """检测单个代理,返回 (是否可用, 耗时ms, 出口IP)"""
    proxies = {
        "http": f"http://{ip}:{port}",
        "https": f"http://{ip}:{port}",
    }
    start = time.time()
    try:
        resp = requests.get("https://httpbin.org/get",
                            proxies=proxies, timeout=timeout)
        cost_ms = int((time.time() - start) * 1000)
        if resp.status_code == 200:
            origin = resp.json().get("origin", "")
            return True, cost_ms, origin
    except (requests.Timeout, requests.ConnectionError):
        pass
    return False, None, None

ok, cost, origin = check_proxy("183.164.12.34", 4231)
print(ok, cost, origin)    # True 812 "183.164.12.34"
几个容易踩的坑说一下:
timeout 必须显式设置。不设的话 requests 会一直干等,一个死IP就能把整个任务卡住。探测场景给3到5秒足够。
为什么选 httpbin.org?它会把你经过代理之后的出口IP原样返回在 origin 字段里,正好拿来核对匿名度:返回值和代理IP一致,说明是高匿;混进了你本机的地址,那就是透明代理,得斟酌着用。
状态码200只是及格线。拿到200之后最好再确认响应体内容完整,有些半死不活的IP会返回空页面,光看状态码发现不了。
进阶版:一次校验几十上百个
单个检测是串行的,假设每个IP平均耗时2秒,200个IP就要跑将近7分钟。等测完,排在前面通过的短效IP可能都快过期了。解决办法是上并发——开几十个线程同时探测,整体耗时直接压到几十秒:
import time
import requests
from concurrent.futures import ThreadPoolExecutor, as_completed

TEST_URL = "https://httpbin.org/get"

def check_one(proxy):
    """proxy 格式为 ip:port"""
    proxies = {"http": f"http://{proxy}", "https": f"http://{proxy}"}
    start = time.time()
    try:
        resp = requests.get(TEST_URL, proxies=proxies, timeout=5)
        cost = int((time.time() - start) * 1000)
        # 状态码200 且 2秒内返回,才算真正合格
        if resp.status_code == 200 and cost <= 2000:
            return proxy, True, cost
    except (requests.Timeout, requests.ConnectionError):
        pass
    return proxy, False, None

def check_all(proxy_list, workers=50):
    alive, dead = [], []
    with ThreadPoolExecutor(max_workers=workers) as pool:
        futures = [pool.submit(check_one, p) for p in proxy_list]
        for f in as_completed(futures):
            proxy, ok, cost = f.result()
            (alive if ok else dead).append((proxy, cost))
    return alive, dead

if __name__ == "__main__":
    ip_list = [
        "183.164.12.34:4231",
        "117.68.55.90:8080",
        "223.240.78.101:3128",
        # ... 这里填从API提取到的完整列表
    ]
    alive, dead = check_all(ip_list)
    print(f"可用 {len(alive)} 个,失效 {len(dead)} 个")
    for p, c in alive:
        print(f"  {p}  {c}ms")
实际跑下来差距非常直观:同一份200个IP的列表,串行检测耗时约6分40秒,开50个并发后只要38秒左右。并发数别开太猛,50到100之间比较稳妥,再高的话本机带宽和文件句柄数都可能先成为瓶颈。
别测完就撒手:定时复检与失效剔除
短效动态IP的生命周期往往只有几分钟到几十分钟,也就是说,校验结果是有"保质期"的。测一轮就不管,跑到任务后半程照样会撞上一堆失联IP。合理的做法是把校验做成一个循环:定期把池子里的IP重新过一遍,失联的踢出去,数量不够了再从API补充新的IP进来。
import time
import schedule   # 先 pip install schedule

alive_pool = []   # 校验通过的IP池,元素为 "ip:port" 字符串

def recheck():
    global alive_pool
    alive, dead = check_all(alive_pool, workers=30)
    alive_pool = [p for p, _ in alive]
    print(f"本轮剔除 {len(dead)} 个失效IP,池内剩余 {len(alive_pool)} 个")
    if len(alive_pool) < 20:                # 低于警戒线就补充新的IP
        alive_pool += fetch_new_proxies()   # 封装你自己的提取逻辑

schedule.every(5).minutes.do(recheck)

while True:
    schedule.run_pending()
    time.sleep(1)
除了定时复检,还可以在爬虫运行时"边用边检":某个IP请求失败就记一次差评,连续两次失败立刻移出可用池。两套机制配合着跑,池子里基本只剩能干活的了。
源头选对,校验成本能省一大半
校验模块写得再漂亮,如果每次提取的IP里失效的占三成,你还是在反复做无用功。更划算的思路是从源头控制质量——一开始就选可用率高的服务商。
拿神龙HTTP来说,官方标注的可用率是99.9%、IP纯度99.8%,资源来自国内三大运营商正规授权。实际体验里,提取下来的IP稍作复检就能直接进任务,很少出现整批失联的情况,校验模块从"主力过滤器"退化成"最后兜底",写起来轻松不少。它的个人中心还带可视化的用量统计和实时监控,哪个时段消耗异常、请求成功率有没有波动,打开面板一眼就能看到,连监控脚本都省了。
常见问题
Q:检测通过的IP,用一会儿又失效了,正常吗?
正常,尤其是短效动态IP,生命周期本来就短,失效是常态而不是异常。这也是为什么复检机制必须常驻后台,而不是测一次管到底。
Q:超时时间设多少合适?
连通性探测建议3到5秒;业务请求按目标站点的正常响应时间上浮50%来设。设太短会误杀响应慢但可用的IP,设太长又会拖慢整体节奏,两头都要权衡。
Q:检测用的目标地址怎么选?
优先选和你的业务目标同类型、同量级的地址,这样测出来的耗时才有参考价值。通用场景下,httpbin.org 这类回显服务最省事,一次请求能同时拿到连通性和匿名度两项信息。
Q:复检频率多高算合理?
短效动态IP建议3到5分钟一轮;长效静态IP可以放宽到半小时甚至一小时,配合"边用边检"的差评机制兜底。频率太高浪费请求资源,太低又拦不住失联IP,按IP的实际存活时长来定最靠谱。