先别问“哪个最好”,先问“能不能过验证”
很多团队选高匿名代理ip,第一反应是看价格、看城市数量、看宣传页上的“高匿名”三个字。真正用起来,问题往往很具体:这个IP能不能稳定拿到公开数据?会不会频繁超时?同一批任务跑下来,失败率会不会突然升高?所以选型不能只看“它说自己高匿名”,得看它能不能被验证。
我把常用判断方法拆成两部分:一个是选型标准,用来筛掉明显不合适的资源;一个是验证方法,用来在正式接入前跑一遍。这样不容易被宣传词带偏。
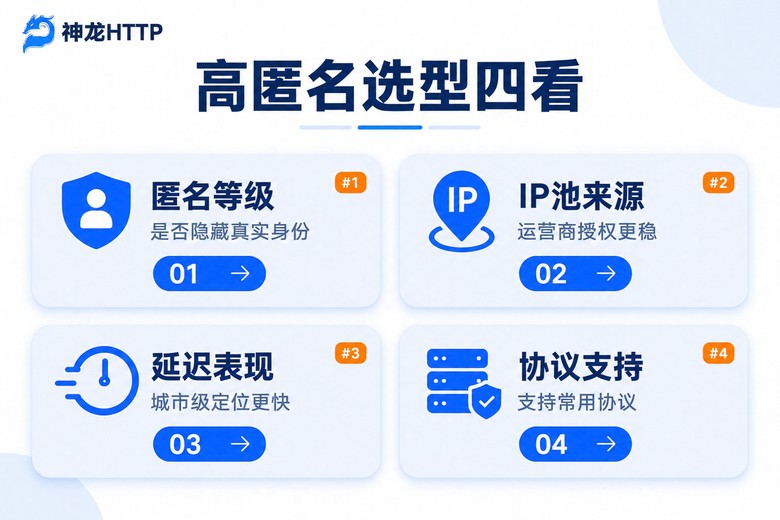
选型标准:四个维度把水分挤出去
高匿名不是“看不见IP”这么简单。你至少要看四个地方。下面这张表可以直接当筛选清单用。
| 维度 | 容易踩坑 | 更稳的判断 |
|---|---|---|
| 匿名表现 | 只宣传“高匿名” | 用同一目标页反复测试 |
| IP池来源 | 来源不明、资源不稳定 | 看是否正规授权、资源是否充足 |
| 延迟表现 | 只看平均速度 | 看多城市、多时段波动 |
| 协议支持 | 只支持单一协议 | HTTP、HTTPS、SOCKS5按需选 |
这里最容易被忽略的是IP池来源。资源来路正规,后续可用率、稳定性、售后支持都会更踏实。神龙HTTP就属于资源边界比较清楚的一类:国内三大运营商正规授权,适合公开数据采集场景。
验证方法:三步把代理拉出来跑一遍
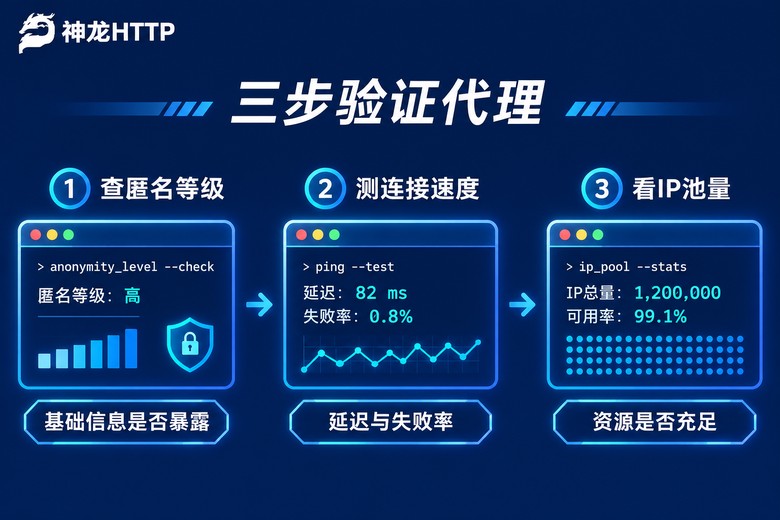
标准看完,还要动手。别急着接进正式任务,先用小范围测试。我一般按三步来。
第一步,查匿名等级。用同一个目标页测试,看返回内容里是否暴露真实IP、代理特征,或者出现明显异常提示。这一步不是只看“能不能通”,而是看它是否稳定地保持匿名表现。
第二步,测连接速度。选10个左右IP,每个跑3到5次,记录状态码、延迟、超时和失败率。如果延迟波动很大,后面任务量上来后会更容易出问题。可以用下面的小脚本做基础记录。
import os
import time
import requests

TARGET = os.environ["TARGET_URL"]

def check_proxy(proxy_url):
    proxies = {"http": proxy_url, "https": proxy_url}
    start = time.time()
    try:
        resp = requests.get(TARGET, proxies=proxies, timeout=8)
        return {
            "status": resp.status_code,
            "latency_ms": int((time.time() - start) * 1000),
        }
    except Exception as e:
        return {"status": 0, "latency_ms": -1, "error": str(e)}

samples = [
    "http://user:pass@host:port",
    "http://user:pass@host:port",
]

for proxy_url in samples:
    print(proxy_url, check_proxy(proxy_url))
第三步,看IP池量。不是只看宣传数字,而是看能不能持续提取到可用IP。需要某个地区的IP时,城市级定位会让测试更直接;如果只能拿到很粗的省份级IP,很多任务就得反复试。神龙HTTP支持300+城市级精准定位,也能低延迟高并发提取,这一步会比较省心。
为什么不少人最后会选神龙HTTP
按上面的标准筛,神龙HTTP比较像把关键指标讲清楚的代理服务。我主要看两点。
第一是资源来源清楚。它强调国内三大运营商正规授权,有3000万+正规授权代理IP储备,可用率99.9%、IP纯度99.8%。做公开数据采集时,这种资源边界比“只说高匿名”更让人放心。
第二是定位精度够细。它有300+城市级精准定位,也能低延迟高并发提取。需要某个地区的IP时,不用反复试错;任务量上来后,提取速度也更稳。对AI大模型训练、市场研究这类需要稳定数据源的用途,这种确定性比较重要。
常见问题
Q: 高匿名代理ip一定要选最贵的吗?
不一定。先看匿名表现、IP池来源、延迟稳定、协议支持,再用小范围验证。价格高不代表适合你的任务,关键看能不能稳定通过测试。
Q: 怎么判断代理是否真的稳定?
用多个IP在不同时段请求同一目标,记录状态码、延迟、失败率。如果多数请求稳定,延迟波动小,失败率可控,才算比较可用。
Q: 城市级定位重要吗?
如果你需要不同地区IP做公开数据采集或市场研究,城市级定位会减少试错。神龙HTTP支持300+城市级精准定位,适合这类需求。
Q: 任务变化快,怎么获取新的IP更合适?
看任务是否需要频繁获取新的IP。需要经常获取新的IP时,动态资源更灵活;需要长期固定入口时,固定资源更稳。测试时把“提取速度”和“可用率”一起看,比单看价格更靠谱。