上周有个做电商价格监测的朋友来问:同一套采集脚本,去年并发开到 100 还挺稳,今年跑到 60 就开始大片超时。他第一反应是"代理变差了"。我让他把失败日志导出来翻了两页,八成都不是代理的锅——并发、重试、换 IP 这三件事各写各的,谁也没管谁。
这篇就把这三件事拧到一起讲,给一套 2026 年还能用的配置思路。不用背参数,你照着自己任务的日志对一遍,就知道该拧哪个旋钮。
并发和重试不是两个配置项,是同一个旋钮
很多人配爬虫是这样的:并发写个 200,重试写个 3 次,两个值隔着屏幕互不认识。结果实际发出的请求量是多少?
真实请求量 ≈ 目标量 ×(1 + 重试率)
重试率一旦爬到 30%,你名义上开 200 并发,实际给目标站点的压力是 260。压力上去,失败率跟着上去,重试更多,几轮下来就是自己把自己打崩。所以调并发的时候,先看当前的重试率是多少,重试率超过 15% 就别再往上加并发了,那是往火堆里浇油。
还有个容易忽略的点:动态 IP 代理这个池子,同一时刻能给你的可用 IP 是有限的。并发开到 200、每 50 次换一条 IP,那一瞬间你需要 4 条 IP 同时在跑;如果提取接口一次只能给你 1 条,多出来的任务就在原地排队等,等出来的超时也会被记到"重试"头上。
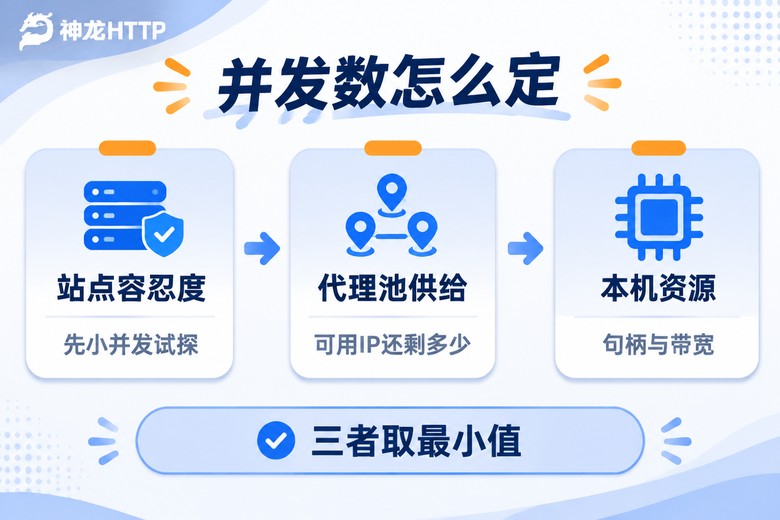
并发数开多大:三个数取最小值
别去网上找"标准并发数",没有。你的并发上限由三个东西共同决定,取最小的那个就是你的天花板。
第一个数是目标站点的容忍度。这个只能试出来。从 20 并发开始,每跑 10 分钟加一档,盯三个指标:平均响应时间、成功率、有没有开始出现 403/429。响应时间翻倍的那一刻,说明你已经踩到拐点了。
| 并发 | 平均响应 | 成功率 | 现象 |
|---|---|---|---|
| 20 | 0.8s | 99% | 稳,但慢 |
| 60 | 1.2s | 96% | 还不错,性价比高 |
| 150 | 3.5s | 78% | 开始大面积超时 |
| 300 | 8s+ | 41% | 站点开始回 403 |
看清楚这张表的走向:从 60 加到 300,并发翻了 5 倍,但成功拿到的页面数反而少了。这就是过拐点之后的负收益,很常见。
第二个数是代理池能同时供给多少条可用 IP。提取接口的并发上限、IP 的有效期、可用率,这三个决定了你手上同时"活着"的 IP 有多少条。一条 IP 你打算每秒打几下,心里得有个数。
第三个数是本机资源。跑异步任务的话,文件句柄数、内存、出口带宽都会卡你。500 并发跑 aiohttp,先把系统的句柄上限调上去,不然报的是 "Too many open files",跟代理没关系。
重试之前,先分清是谁的错
我见过最常见的错误写法,就是 try: ... except: 重试。所有的失败一视同仁地重试三次,结果是该放弃的在那儿死磕,该退让的在那儿硬顶。
正确的做法是先给错误分个类,不同类走不同分支:
| 错误类型 | 该不该重试 | 怎么处理 |
|---|---|---|
| 连接超时 / 代理握手失败 | 重试 | 立刻换一条新 IP |
| 407 代理认证失败 | 重试 | IP 本身废了,换 IP |
| 403 被拦 | 谨慎重试 | 先歇 1-3 秒再换 IP,别连着撞 |
| 429 触发限流 | 退避后重试 | 换 IP 继续打只会更凶,先降速 |
| 404 / 400 | 不重试 | 页面没了或参数错了,重试一万次也一样 |
| 5xx 服务端错误 | 重试 | 指数退避,2-3 次为限 |
尤其说说 429。它的潜台词是"你太快了",这时候你换条 IP 接着全速打,等于换个人继续敲同一扇门,只会从限流升级成封禁。减速,比换 IP 更管用。
import asyncio
import aiohttp

PROXY_API = "提取接口地址"        # 每次调用返回一条新 IP
SEM = asyncio.Semaphore(60)       # 并发闸门,先从 60 起步

async def get_proxy(session):
    async with session.get(PROXY_API, timeout=5) as r:
        return await r.text()

async def fetch(session, url):
    async with SEM:
        proxy = await get_proxy(session)
        for attempt in range(1, 4):
            try:
                async with session.get(
                    url,
                    proxy=proxy,
                    timeout=aiohttp.ClientTimeout(total=15)
                ) as r:
                    if r.status == 200:
                        return await r.text()
                    if r.status in (403, 407):
                        await asyncio.sleep(1.2 * attempt)   # 歇一下再换,别连撞
                        proxy = await get_proxy(session)
                    elif r.status == 429:
                        await asyncio.sleep(5 * attempt)     # 限流就退,不硬顶
                    elif r.status >= 500:
                        await asyncio.sleep(2 ** attempt)    # 指数退避
                    else:
                        return None                          # 4xx 明确错误,放弃
            except (aiohttp.ClientError, asyncio.TimeoutError):
                proxy = await get_proxy(session)             # 网络层失败直接换 IP
        return None
这段代码里有两个细节值得留意。一是 Semaphore(60) 卡在了获取代理之前,所以同时只有 60 个任务在消耗 IP,池子不会被瞬间抽干。二是每一类错误都对应了一个不同的 sleep 时长,这不是玄学,是给对面留出喘息窗口。

什么时候该换一条新 IP
把换 IP 的时机全交给"失败了再换",是很被动的做法。主动一点,设三个触发点:
按请求数轮换。一条 IP 用满 30-50 次就主动换掉,别等它被目标站点记上。频率越低的站点,单条 IP 能扛的次数越多,可以放宽到 100 次。
按时间轮换。短效动态 IP 本身有有效期,60 秒、180 秒都有,别等到它过期了还在往上面发请求,那批请求注定是超时。在本地记一个生成时间,到期前 5 秒就换。
按连续失败次数。同一条 IP 连续失败 2 次,直接判死,不用第三次验证。这个规则能省掉大量无意义的等待。
还有一个例外必须说:带登录态的采集别乱换 IP。会话跟 IP 绑在一起的时候,中途换 IP 会让登录态失效,请求被打回登录页,看起来像"被反爬了",其实是你自己换丢的。这种场景要么用长效静态 IP 固定住,要么在同一个会话里贯穿同一条 IP。
import time

class ProxyRotator:
    """按请求数 + 有效期双重判断,到期或超标就换新 IP"""
    def __init__(self, per_proxy=50, ttl=60):
        self.per_proxy = per_proxy
        self.ttl = ttl
        self.count = 0
        self.born = 0
        self.current = None

    def get(self):
        expired = time.time() - self.born > self.ttl - 5   # 提前 5 秒换
        if self.current is None or self.count >= self.per_proxy or expired:
            self.current = fetch_one_proxy()                 # 走提取接口
            self.count = 0
            self.born = time.time()
        self.count += 1
        return self.current

参数调得对不对,得看监控说话
并发、重试、换 IP 这三组参数,光靠拍脑袋定不下来。你得能看到每条 IP 的响应时间、失败率、平均存活时长,才知道该往前调还是往回收。
这方面神龙HTTP 做得比较省心。它的 IP 池有 3000 万+ 正规授权资源、覆盖 300+ 城市的精准定位,短效动态、长效静态、固定 IP 几条产品线可以按任务混着用,高峰期不至于出现"要换却没 IP 可换"的尴尬。更实用的是个人中心里那套可视化用量统计和实时监控:哪些 IP 在异常、失败集中在哪个时段、用量趋势怎么走,一眼能看出来。API 也兼容主流的爬虫编程语言,文档和示例代码都有,接进上面那套异步框架基本是复制粘贴的活儿。
一套能照着抄的起步值
如果你不想从零试,下面这组参数可以作为起点,跑够 30 分钟再按日志微调:
| 参数 | 起步值 | 什么时候该动 |
|---|---|---|
| 并发数 | 50-60 | 成功率稳定在 95% 以上且响应没变慢,再往上加 20 |
| 单任务重试上限 | 3 次 | 重试率长期超 20%,说明问题在并发或 IP 质量,不在次数 |
| 请求超时 | 15 秒 | 目标站点本身慢,调到 20-25 秒;反之压到 8 秒 |
| 单 IP 使用次数 | 50 次 | 站点敏感度低可以放宽到 100,敏感就往 20 收 |
| 403 后的停顿 | 1.2 秒 | 还在频繁被打回,成倍往上加 |
| 429 后的停顿 | 5 秒起 | 退避时间按尝试次数递增 |
跑起来之后,先看失败原因分布。如果 80% 的失败是"连接超时",问题在 IP 和网络;如果 80% 是 403/429,问题在你的请求节奏。两种情况的解法完全相反,别搞混。

常见问题
Q:并发开得越高,采集速度是不是一定越快?
不是。并发过了拐点,响应时间会成倍拉长,重试率跟着上涨,总吞吐反而下降。判断拐点很简单:加一档并发跑十分钟,如果平均响应时间翻倍了,就退回上一档。
Q:重试次数设成 5 次是不是比 3 次更保险?
大多数情况下没必要。重试第三次还失败的请求,第五次基本也拿不到。与其加次数,不如把这几类错误分开处理:超时和代理错误直接换 IP,429 老实退避,404 干脆放弃。把重试次数堆上去,只会让问题请求占着并发名额。
Q:短效动态 IP 和长效静态 IP 该怎么选?
看任务形态。列表页、详情页这种一条一条互不相干的任务,用短效动态 IP 高频轮换最合适;需要维持登录态、要连续翻页的场景,用长效静态或固定 IP 固定住出口更稳。同一个项目里两者混用也很常见。
Q:跑着跑着成功率突然掉下来,第一步查什么?
先分清是"全部失败的"还是"部分失败的"。全部失败,多半是提取接口出问题或者代理认证挂了;部分失败且集中在特定域名,是目标站点的策略变了,该降速了;失败分散但重试率居高不下,回头看并发数和单 IP 使用次数是不是设得太激进。