先分清:你要的是哪一种转发
经常有人拿着半截配置来问:我明明写好了 proxy_pass,怎么请求还是从本机 IP 出去的?打开配置文件一看,写的是 proxy_pass http://127.0.0.1:8080;——那是把请求交给本机另一个服务,跟"用代理 IP 出去"完全是两码事。
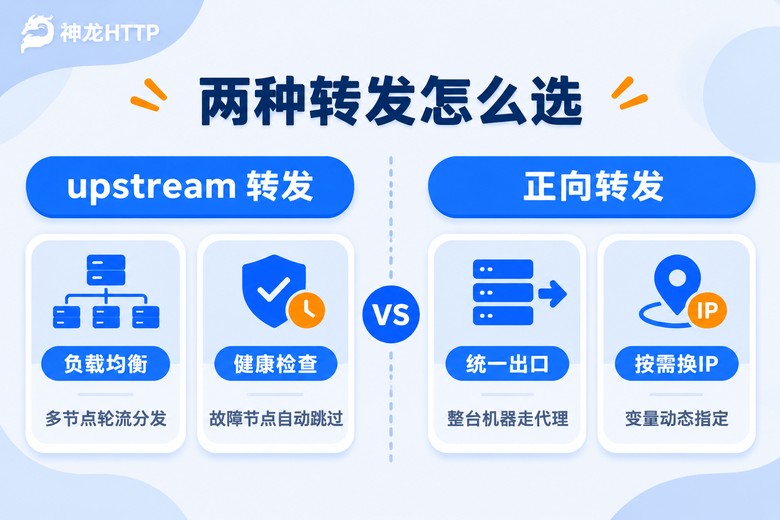
在 nginx 里,"配置代理 IP"其实对应两种结构完全不同的活儿:
第一种,upstream 转发。你在 http 块里用 upstream 把几个节点编成一组,再让 proxy_pass http://组名 把请求分发过去。这里放后端服务器也好、放代理节点也好,本质都是"我这边收请求,转发给下一跳"。
第二种,正向转发。客户端把 nginx 当成一个代理来用,请求先到 nginx,nginx 再决定从哪个出口发出去。这条路要处理的细节更多,涉及到 CONNECT 方法、认证头、DNS 解析缓存。
两条路的配置长得像,但踩的坑完全不一样。下面分开说。
upstream 转发:把几个节点编成一组
这是 nginx 最擅长的部分,语法也最成熟。典型写法是这样:
upstream api_pool {
    least_conn;
    server 10.0.0.11:8080 weight=3 max_fails=2 fail_timeout=15s;
    server 10.0.0.12:8080 weight=1 max_fails=2 fail_timeout=15s;
    keepalive 64;
}

server {
    listen 80;
    server_name api.example.com;

    location / {
        proxy_pass http://api_pool;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;

        proxy_connect_timeout 3s;
        proxy_read_timeout 30s;
        proxy_next_upstream error timeout http_502;
    }
}几个参数值得单独拎出来说。max_fails=2 fail_timeout=15s 的意思是:15 秒内连挂 2 次,这个节点先被摘掉 15 秒,期间请求不会往它身上打。proxy_next_upstream 决定了什么情况下自动换下一个节点,默认只认 error 和 timeout,加上 http_502 之后,上游返回 502 也会重试——采集场景里这个很有用,一个代理节点挂了不至于整批请求全废。
keepalive 64 是给 nginx 到上游保留 64 条空闲长连接。但只写这一行没用,必须同时配 proxy_http_version 1.1; 和 proxy_set_header Connection "";。少了这两行,HTTP/1.0 加上 Connection: close,每条请求都要重新握手,压测时你会看到上游连接数疯涨、延迟多出几十毫秒。
另外把 proxy_connect_timeout 从默认的 60 秒改小。默认值意味着上游地址不可达时,你的 worker 要干等一分钟才报错,并发一高就把连接池占满了。3 到 5 秒足够判断。
正向转发:让 nginx 把请求交给代理服务器
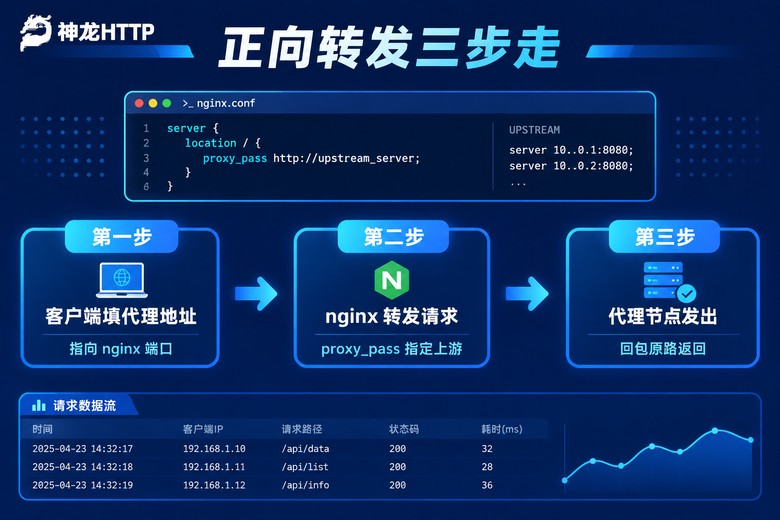
想让整个服务统一从某个出口发出请求,最直接的做法是把代理服务器的地址写进 proxy_pass:
server {
    listen 8888;
    resolver 223.5.5.5 valid=30s ipv6=off;

    location / {
        proxy_pass http://user:pass@10.10.1.21:8000;
        proxy_http_version 1.1;
        proxy_set_header Host $host;
        proxy_set_header Connection "";
        proxy_connect_timeout 5s;
        proxy_read_timeout 20s;
    }
}
这里 proxy_pass 后面跟的已经不是后端服务,而是一台代理服务器。请求行到它那儿之后,由它替你去取数据。
账号密码不建议直接拼在 URL 里,配置文件一旦进了 git 就麻烦了。更干净的做法是用认证头:
proxy_set_header Proxy-Authorization "Basic dXNlcjpwYXNz";后面那串是 用户名:密码 做 base64 的结果。生产环境把这段单独放一个 include auth.conf;,权限设成 600,别混在主配置里。
还有一种情况:客户端希望直接把 nginx 当代理用,在系统或代码里填 http://你的服务器:3128。这时候 nginx 必须能处理 CONNECT 方法(HTTPS 请求靠它建隧道),而官方版本默认不支持,得编译第三方模块 ngx_http_proxy_connect_module。装好之后配置大概长这样:
server {
    listen 3128;
    resolver 223.5.5.5 valid=60s;

    proxy_connect;
    proxy_connect_allow 443 563;
    proxy_connect_connect_timeout 10s;
    proxy_connect_data_timeout 20s;

    location / {
        proxy_pass $scheme://$host$request_uri;
        proxy_set_header Host $host;
    }
}
敲 nginx -V 2>&1 | grep proxy_connect 能看到模块名,说明编译进去了。看不到就说明没装,写了这段配置启动会直接报 unknown directive "proxy_connect"。
用变量动态换出口
固定写死一个代理地址,只能解决"统一出口",解决不了"这次想从另一个地区拿数据"。真正常用的写法是配合 map 按参数挑节点:
map $arg_region $proxy_node {
    default    "http://user:pass@10.10.1.21:8000";
    "beijing"  "http://user:pass@10.10.1.22:8000";
    "shanghai" "http://user:pass@10.10.1.23:8000";
    "chengdu"  "http://user:pass@10.10.1.24:8000";
}

server {
    listen 8888;
    resolver 223.5.5.5 valid=30s ipv6=off;

    location / {
        proxy_pass $proxy_node;
        proxy_set_header Host $host;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
    }
}
请求带上 ?region=beijing,nginx 就从北京那台节点出去。map 块必须写在 http 块里,不能塞进 server 里面去。
踩坑提醒:只要 proxy_pass 里出现了变量,nginx 就不会去找同名的 upstream,也不会用系统的 DNS 解析,必须自己配 resolver,否则启动直接报 no resolver defined to resolve。而且 valid=30s 决定了它多久重新查一次域名,默认时间偏长;如果你用的代理服务是域名形式、背后 IP 会漂移,这个值记得压到 30 秒以内,不然你会遇到"后台显示 IP 已经换了,nginx 还连着老地址"的怪事。
还有一点:带变量的 proxy_pass 不会自动帮你拼接 URI 的剩余部分。想保留完整路径,就写成 proxy_pass $proxy_node$request_uri;,否则 location 匹配之后的那段路径会丢。
四个最容易翻车的参数
配置能启动,不等于跑得稳。下面这四处是排查时出现频率最高的。
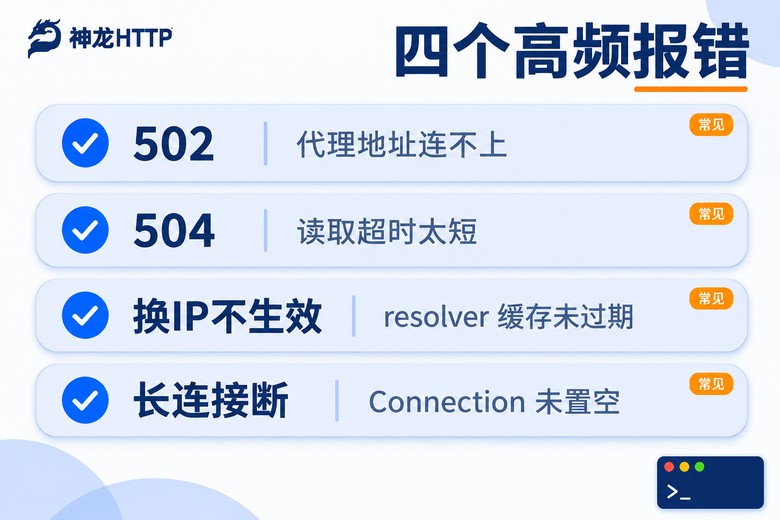
502 和 504 是两回事。502 表示 nginx 根本没连上代理地址——检查 IP、端口、白名单。504 表示连上了但等不到回包——多半是 proxy_read_timeout 设得太短,或者目标那边响应本身慢。别一看到报错就把超时调到 300 秒,先看清楚是哪一类。
长连接没生效。开了 keepalive 但没配 proxy_http_version 1.1 + Connection "",等于白开。用 ss -tan | grep 8000 | wc -l 数一下到上游的连接数,如果请求涨了连接数跟着涨,说明确实没复用。
DNS 缓存。前面说过,resolver 的 valid 太长会让新 IP 迟迟不生效。反过来,设得太短(比如 1s)会给 DNS 带来大量查询,30 到 60 秒是个比较稳的区间。
日志里看不出用了哪个节点。默认 access_log 只记客户端 IP,上游信息全丢了。加一个自定义格式,排查效率立刻不一样:
log_format proxy_debug '$remote_addr "$request" '
                       'up=$upstream_addr status=$upstream_status '
                       'ct=$upstream_connect_time rt=$upstream_response_time';

access_log /var/log/nginx/proxy_debug.log proxy_debug;
改完之后重启,日志里会直接出现 up=10.10.1.22:8000 status=200 ct=0.032 rt=0.418 这样的记录。哪个节点慢、哪个节点在报错,一眼就能对上号,不用再靠猜。
采集场景里的实际组合
把上面这些拼起来,一套常见的采集出口配置是这样的:主站做业务分发用 upstream,采集任务集中从另一个端口的 server 出去,走代理节点并带上重试和超时保护。这时候 nginx 相当于一个流量调度台,代码里只认本地地址,换地区、换出口都在配置这一层解决,业务代码一行不用动。
剩下的关键是代理 IP 本身稳不稳。我们团队现在用的是神龙HTTP,几个点比较实用:3000万+正规授权代理IP储备,国内三大运营商授权,HTTP/HTTPS/SOCKS5 都支持,可用率标称 99.9%,IP 纯度 99.8%,跑长时间采集任务不会隔一阵就掉一批。
城市维度上支持 300+ 城市级精准定位,配合前面那个 map 的写法刚好对得上——想拿哪个地区的出口,加一行配置的事。短效动态、长效静态、固定IP 三条产品线各管一段场景,短效适合大范围轮换,长效静态适合需要保持会话连续的请求。
另外个人中心里有可视化用量统计和实时监控,能看出来哪段时间提取量异常、消耗在哪个环节。调 nginx 参数的时候这个挺有用,你能直接对比"改了 resolver valid 之后,IP 复用率有没有变化"。API 兼容主流爬虫语言,也有现成的示例代码,接进来基本不用折腾。真遇到配置层面拿不准的问题,7×24 的技术支持也能问。
常见问题
Q:proxy_pass 写了代理地址,为什么一直报 502?
按顺序查三件事。先在本机执行 curl -x http://代理地址:端口 https://httpbin.org/ip,能不能通——不通说明是代理侧的问题,可能是密码错、IP 没加白名单、或者套餐到期。能通但 nginx 报 502,再看 proxy_pass 里的用户名密码有没有特殊字符没转义。最后确认 nginx 所在机器能出网,有些内网环境只放行了 80/443。
Q:后台显示换了 IP,nginx 为什么还连老地址?
典型的 DNS 缓存。检查 proxy_pass 是否用了变量,用了就必须有 resolver,并且把 valid 调到 30 秒左右。另外执行 nginx -s reload 之后旧连接不会立刻断,worker 是平滑退出的,等几十秒再测更准确。
Q:upstream 里面能不能直接放代理 IP?
能,语法上完全合法,相当于在几个上游代理之间轮询。但要注意 upstream 内部的健康检查粒度比较粗,只是"连不上就摘掉",不判断返回内容。如果你的场景对成功率敏感,建议 upstream 做节点兜底、map 做按地区精确指定,两套配合用,比只靠一套更稳。
Q:只转发 HTTP 请求,还需要装 CONNECT 模块吗?
不需要。纯 HTTP 场景用 proxy_pass 指向代理地址就够了。只有在客户端把 nginx 当系统级代理、又要访问 HTTPS 站点时,才必须靠 CONNECT 建隧道,那时候才需要 ngx_http_proxy_connect_module。判断方法很简单:客户端填完代理后,HTTP 页面能开、HTTPS 页面卡住不动,基本就是缺这个模块。