裸跑的爬虫,为什么撑不过一个下午
去年帮一个做电商价格监测的朋友救火。他的爬虫单机裸跑,前两百个请求一切正常,跑到第三百多个,目标站开始弹验证码,再往后直接403。他第一反应是代码出了bug,排查了一整晚,最后发现人家的风控没坏,是他的出口IP被盯上了。
道理不难懂:同一个IP,几分钟里打出去几百个节奏一致的请求,任何一台正常的服务器都会起疑心。解决办法也不是什么黑科技——让每个请求从不同的IP出去,而且这些IP必须是活的。把这件事自动化,你就得到了一个代理IP池。
很多人一听"搭池子"就觉得要写多复杂的系统。其实到了2026年,IP获取这一层早就有专业服务替你做好了,你要做的只是把接入、校验、调度这三件事串起来。下面我从零带你跑通,全程用最朴素的Python代码。
先看骨架:一个池子由哪几块组成
动手之前花两分钟看下结构,后面写代码就不会迷路。一个能用的代理池,核心就三块:
接入模块:负责从代理服务商的API定时拉取新IP,塞进池子。IP是有寿命的,尤其是短效动态IP,不持续补充很快见底。
校验模块:拿到的IP不能直接信,得逐个测一遍——能不能连上、响应多少秒、返回的内容对不对。这一步决定了池子的口碑。
调度模块:爬虫来要IP的时候,从池子里发一个出去;用完反馈结果,好IP回收再用,坏IP踢出局。
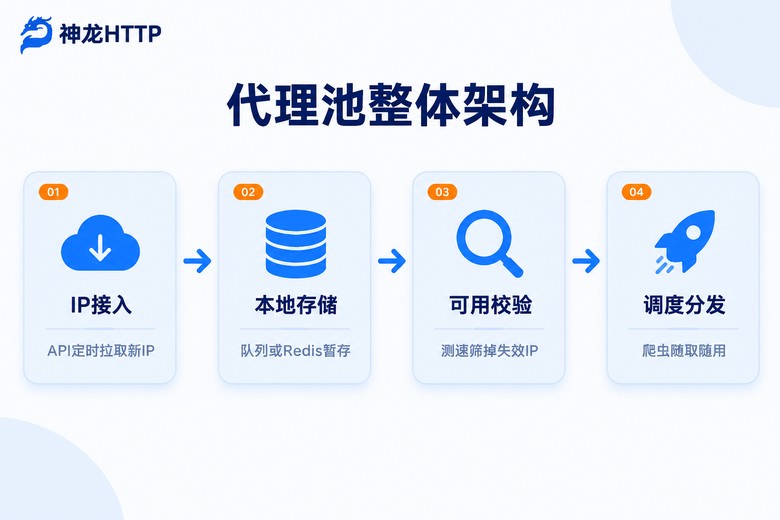
存储这块不用纠结,练手阶段一个Python队列完全够用;等请求量上去了,再平滑换成Redis也不迟。下面按顺序把三块代码写出来。
第一步:把IP接进来
先泼一盆冷水:网上那些免费IP列表,我劝你只拿来练手。我实测过几个来源,一百个里能用的常常不到十个,而且大多活不过十分钟,校验和维护的成本比买IP还高。正经做项目,直接用付费服务是性价比最高的路——比如神龙HTTP,在后台生成一条API提取链接,每次调用返回一批新鲜IP,接入代码十行就能写完。
import requests

API_URL = "把你在服务商后台生成的提取链接粘到这里"

def fetch_ips(num=20):
    """拉一批新IP,返回 ["ip:端口", ...] 形式的列表"""
    resp = requests.get(API_URL, params={"num": num}, timeout=5)
    # 多数服务返回纯文本,每行一个 ip:端口
    return [line.strip() for line in resp.text.splitlines() if line.strip()]

if __name__ == "__main__":
    ips = fetch_ips()
    print(f"拿到 {len(ips)} 个IP,第一个是 {ips[0]}")
两个细节提醒一下:一是提取接口通常有频率限制,别写个死循环猛刷,按自己的请求量算好补充节奏;二是返回格式以服务商文档为准,有的是JSON有的是纯文本,改一行解析就行。
第二步:写校验器,把坏IP挡在门外
服务商给的可用率再高,也架不住网络波动,所以校验这步不能省。思路很简单:拿每个IP去请求一次你真正要爬的目标站,几秒内返回200就算合格,顺便记下耗时——这个数字后面排优先级要用。
import time
import concurrent.futures as cf

TEST_URL = "https://你的目标站点.com"  # 用真实目标站测,比通用测速地址更准

def check_one(proxy):
    """测单个IP,成功返回耗时(秒),失败返回 None"""
    proxies = {"http": f"http://{proxy}", "https": f"http://{proxy}"}
    start = time.time()
    try:
        r = requests.get(TEST_URL, proxies=proxies, timeout=3)
        if r.status_code == 200:
            return round(time.time() - start, 2)
    except Exception:
        pass
    return None

def check_all(ip_list, workers=20):
    """并发校验,返回 {ip: 耗时} 字典,只含合格IP"""
    result = {}
    with cf.ThreadPoolExecutor(max_workers=workers) as pool:
        for proxy, cost in zip(ip_list, pool.map(check_one, ip_list)):
            if cost is not None:
                result[proxy] = cost
    return result
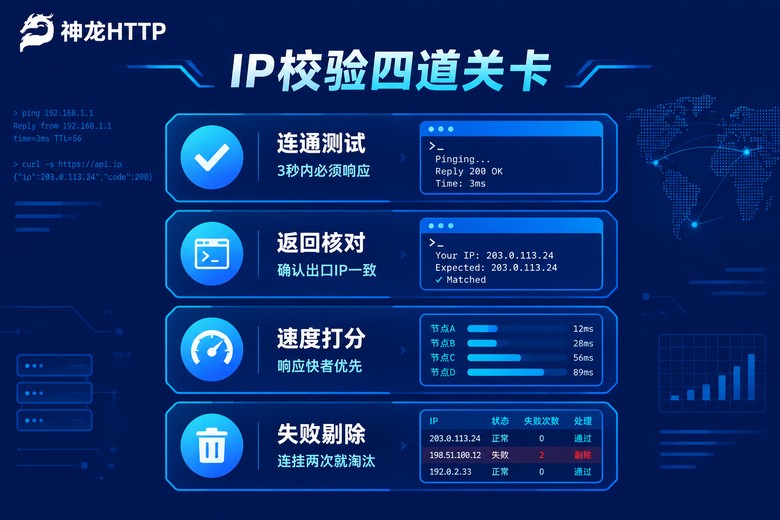
这里有个新手常踩的坑:拿大平台首页之类的通用网址测活,结果目标站那边照样把你拦下来。校验地址一定要用你实际要爬的那个站,因为"可用"从来都是相对目标站说的。并发数20是个不错的起点,开太高容易把自己家带宽打满,测出来的耗时也不准。
第三步:池子跑起来,爬虫这样用它
三个零件都齐了,现在组装。下面这个精简版IP池用队列存IP,新IP按响应速度从快到慢入池;爬虫用完还能反馈结果,好IP回池接着用,连挂两次的自动淘汰:
import queue
import threading

class IPPool:
    def __init__(self, min_size=10):
        self.goods = queue.Queue()
        self.fail_count = {}
        self.min_size = min_size
        self.lock = threading.Lock()

    def refill(self):
        """拉新IP -> 校验 -> 按响应速度从快到慢入池"""
        raw = fetch_ips()
        scored = check_all(raw)
        for proxy, _ in sorted(scored.items(), key=lambda x: x[1]):
            self.goods.put(proxy)

    def get(self):
        if self.goods.qsize() < self.min_size:
            threading.Thread(target=self.refill).start()  # 存量不足,后台补货
        return self.goods.get(timeout=15)

    def feedback(self, proxy, ok):
        with self.lock:
            if ok:
                self.fail_count.pop(proxy, None)
                self.goods.put(proxy)   # 还活着,回池子接着用
            else:
                self.fail_count[proxy] = self.fail_count.get(proxy, 0) + 1
                if self.fail_count[proxy] >= 2:  # 连挂两次,不再回池
                    self.fail_count.pop(proxy, None)

pool = IPPool()
pool.refill()  # 启动时先灌满一池
爬虫侧的用法,核心是"取IP—请求—反馈"这个闭环:
def crawl(url):
    for attempt in range(3):
        proxy = pool.get()
        try:
            r = requests.get(url,
                             proxies={"http": f"http://{proxy}",
                                      "https": f"http://{proxy}"},
                             timeout=5)
            pool.feedback(proxy, r.status_code == 200)
            if r.status_code == 200:
                return r.text
        except Exception:
            pool.feedback(proxy, False)
    return None
到这一步,一个能扛事的代理池就跑通了。把crawl函数套进你的采集循环,单机稳定跑上几万次请求不再是难事。
跑顺之后:四个让池子寿命翻倍的细节
骨架有了,想让它长期稳定服役,还有几件事值得做:
1. 定时补货,别等见底。短效动态IP普遍活得不久,等池子空了再去拉,爬虫就得干等。我的习惯是设个定时任务,存量低于阈值就自动补充,永远留三分之一的余量。
2. 给IP记档案。除了失败次数,把每个IP的历史成功率和平均耗时也记下来。跑上一两周,你会得到一份"优等生名单",优先调度它们,整体成功率还能再抬一个台阶。
3. 请求端也要收敛。池子再好,也救不了每秒几十次的猛冲。加上随机延时、补全User-Agent这些基本功,IP的消耗速度会慢很多,账单也好看很多。
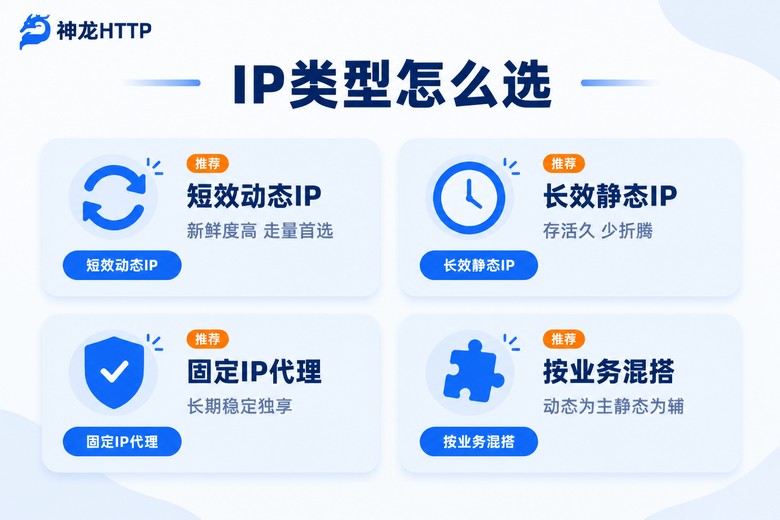
4. 按任务选对IP类型。不是所有IP都一个用法,选错类型又贵又容易出问题:
| 类型 | 特点 | 适合的任务 |
|---|---|---|
| 短效动态IP | 生存期短、新鲜度高 | 大批量公开数据采集 |
| 长效静态IP | 存活久、少折腾 | 需要保持会话的流程 |
| 固定IP代理 | 长期不变、独享出口 | 对稳定性敏感的业务 |
关于服务商,说点实在的
池子架构可以自己写,但IP货源建议交给专业的人。我目前在用的是神龙HTTP,主要看中两点:一是家底厚,3000万+正规授权代理IP储备,全部来自国内三大运营商正规授权,官方口径的可用率99.9%,实测下来很少抽到死IP,池子的补货压力小了一大截;二是对新手友好,API兼容主流爬虫编程语言,文档和示例代码给得齐全,像上面fetch_ips那种函数,照着示例改改就能跑。
再提一句它的个人中心:里面有可视化的用量统计和实时监控,哪天成功率突然掉了,进去看一眼就知道是IP的问题还是自己代码的问题,排查效率高不少。技术团队7×24小时在线,半夜池子出状况也有人搭把手。
常见问题
Q: 免费代理IP真的不能用吗?
练手完全没问题,写校验器、跑通流程用免费IP最合适。但上生产不建议:可用率低且极不稳定,来源不明还有安全风险,万一响应内容被动了手脚,得不偿失。正经项目,一天几块钱的服务费,比排查问题耗掉的时间成本低太多了。
Q: 池子里要维持多少个IP才够用?
看两个数:目标站的风控强度和你的请求频率。轻量采集,几十个可用IP轮着用就够了;高频采集建议常年保持几百个在池,并按前面说的留余量、勤补货。与其堆数量,不如把校验和反馈闭环做扎实——两百个高质量IP,比两千个没筛过的好用得多。
Q: 校验多久跑一次合适?
短效动态IP建议"用前即检",或者几十秒一轮,因为它们失效得快;长效静态IP可以放宽到几分钟一次。判断标准很简单:如果爬虫经常拿到超时的IP,说明校验节奏太懒了,加密一轮就行。
Q: 用了新IP还是被拦,是IP质量不行吗?
不一定。先检查三件事:请求频率是不是太高、请求头是不是太裸(默认User-Agent一眼假)、是不是带着上一站的Cookie直冲。很多"被封"其实是行为特征太明显,跟IP没关系。正确顺序是:先降速,再补请求头,最后才怀疑IP质量。