做数据采集的人大概都有过这种体验:早上提取了一千个IP,下午又去提取一千个,月底账单一拉,用量翻着倍地涨。仔细一查才发现,大部分IP只用了两三次就被扔掉了,其中不少压根没坏,只是当时响应慢了一点。代理IP是按量计费的资源,会不会循环利用,直接决定同样的预算能多跑多少任务。这篇文章就把IP池管理和复用机制这套东西拆开讲清楚,从思路到代码都有。
一、别把"暂时不好用"当成"彻底坏了"
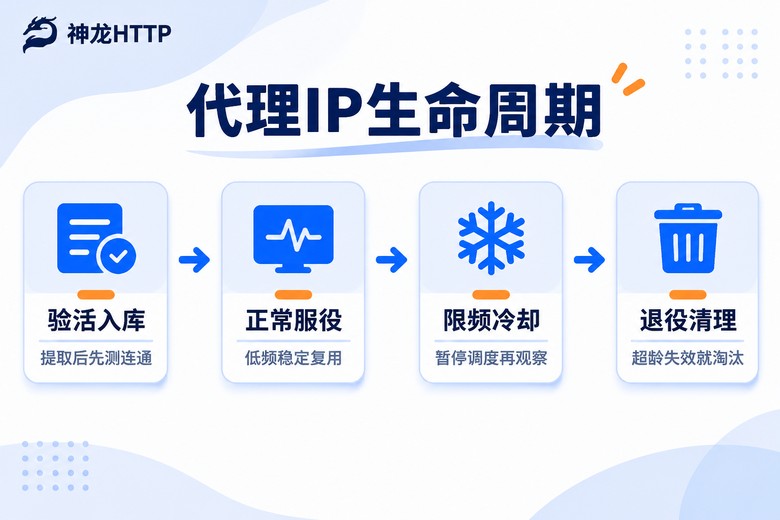
一个代理IP从提取到失效,中间会经历好几个阶段。很多人只认两头——能用的和不能用的,中间状态全被当成垃圾扔掉。实际上,一个IP被目标网站限频之后,通常歇上几分钟到几十分钟就能缓过来;响应变慢,也可能只是那个时间段线路拥挤,过一阵自己就好了。
把IP的状态拆细一点看,大概是这样:
| 状态 | 典型表现 | 该做的处理 |
|---|---|---|
| 健康 | 响应快,成功率高 | 正常调度使用 |
| 疲劳 | 响应变慢,偶发超时 | 降频使用,少派任务 |
| 冷却 | 连续失败,触发限频 | 暂停调度,进冷却队列 |
| 失效 | 长时间无法连通 | 移出IP池,不再占用名额 |
中间两个状态管起来,一个IP的寿命能拉长不少。按我们的经验,做好冷却和分级之后,同一批IP的有效使用次数翻一倍以上是很常见的。
二、IP池的三个基本功:入库、分级、冷却
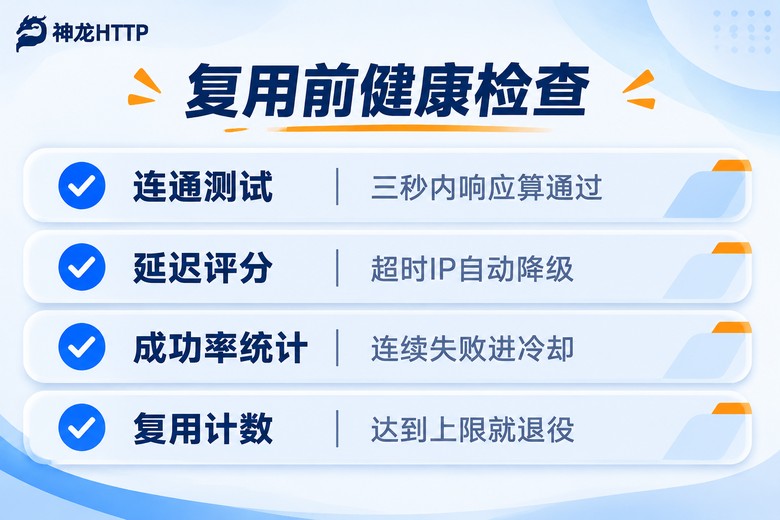
入库先验活。新提取的IP不要直接进主池,先发一个轻量请求测一下,三秒内有响应的才入库。别小看这一步,服务商给的IP可用率再高,也会有零星几个在传输环节出问题,提前筛掉一个,比任务跑到一半失败重来划算得多。
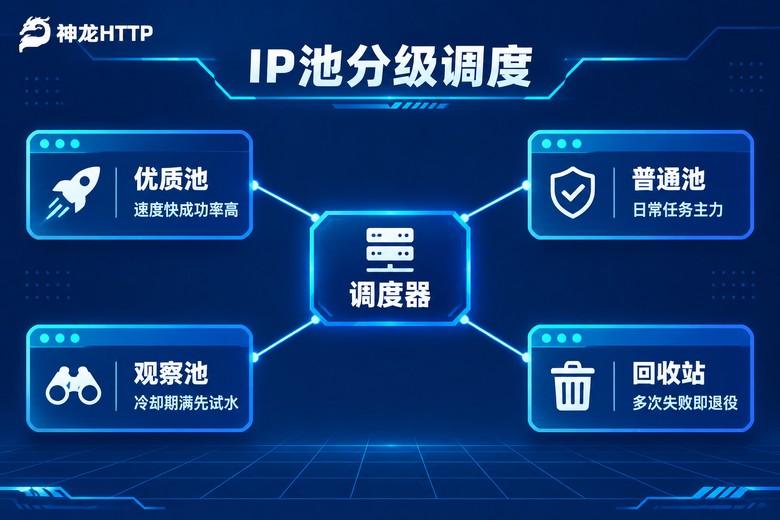
分级管理。给每个IP记三本账:平均响应时间、最近成功率、累计使用次数。按分数把池子分成三层,各干各的活:
| 池子 | 准入标准 | 派什么活 |
|---|---|---|
| 优质池 | 响应1秒内,成功率98%以上 | 核心任务优先用 |
| 普通池 | 响应3秒内,成功率90%以上 | 日常任务主力 |
| 观察池 | 刚出冷却,或数据还不够 | 低重要性任务试水 |
冷却队列。IP触发限频后别急着扔,挪进冷却队列,按目标网站的限频周期设定休息时长。比如某站点的限制一般是十分钟一轮回,那就设十二分钟,到点自动回观察池,跑一次验证再决定去留。这样处理,十次里有七八次能把IP捞回来接着用。
三、复用机制的三个关键参数
参数一:冷却时长。设短了,IP没缓过来,拿回来还是失败;设长了,白白浪费IP的可用窗口。建议从目标网站限频周期的1.2倍起步,跑几天看观察池的回收率,再慢慢微调。
参数二:单IP复用上限。再健康的IP也不建议无限复用,用得越久行为特征越明显。短效动态IP按服务商给的有效时长来定,比如有效期五分钟的IP,在有效期内复用两三次就够了;长效静态IP可以按累计次数设上限,比如两百次强制退役。
参数三:健康检查频率。要定时抽查池内IP,而不是等任务失败了才发现问题。查得太勤浪费请求,查得太疏池子数据失真。任务高峰期五分钟一轮,空闲期拉长到半小时,是比较省的节奏。
下面是一段简化过的池管理逻辑,把上面这套思路跑通大概就长这样:
import time

class IPPool:
    def __init__(self):
        self.active = {}      # ip: {"score": 分数, "used": 已用次数}
        self.cooling = {}     # ip: 解冻时间戳
        self.max_used = 200   # 单IP复用上限
        self.cooldown = 720   # 冷却时长(秒)

    def get(self):
        now = time.time()
        # 冷却到期的IP降级放回,先观察
        for ip, ts in list(self.cooling.items()):
            if now >= ts:
                self.active[ip]["score"] = 70
                self.cooling.pop(ip)
        # 从分数最高的IP开始挑
        usable = [ip for ip, d in self.active.items()
                  if d["used"] < self.max_used]
        if not usable:
            return None
        usable.sort(key=lambda x: self.active[x]["score"], reverse=True)
        ip = usable[0]
        self.active[ip]["used"] += 1
        return ip

    def report(self, ip, ok):
        d = self.active[ip]
        d["score"] = min(100, d["score"] + 5) if ok else d["score"] - 20
        if not ok and d["score"] < 40:
            # 表现持续差,进冷却歇一会儿
            self.cooling[ip] = time.time() + self.cooldown

    def retire(self, ip):
        self.active.pop(ip, None)
        self.cooling.pop(ip, None)
这段代码只有几十行,胜在骨架清楚:取IP按分数挑,用完回报结果,分数掉到底就进冷却,次数用满就退役。实际项目里再往里加地区标签、并发锁这些,都是在骨架上做加法。
四、这几种情况别硬复用,及时补新IP
复用是省钱手段,不是教条。下面几种情况,取新IP比硬撑更划算:
任务需要换个地区的IP。比如上一轮任务走的是南方的出口,这一轮要北方的,直接从池子里按地区标签取新IP,别让旧IP跨区硬顶,两头不讨好。
验证突然变多。同一个IP连续碰到验证页,说明目标站已经盯上它了,这时候复用只会越跑越慢,让它进长冷却,或者直接退役。
IP临近有效期。短效动态IP到期前最后一两分钟,别再派新任务给它,跑到一半断了重试,比省下的那点量亏得多。
说到底,池子能不能转起来,前提是补给要稳。我们实际对比下来,神龙HTTP的短效动态IP比较适合这种高频轮换的用法——3000万+正规授权的代理IP储备,可用率99.9%,按需提取基本不断档;API写法兼容主流爬虫编程语言,把提取接口接进上面那段池管理代码,十几行就能跑起来。它家个人中心里还有可视化用量统计和实时监控,每天多少IP进池、多少进冷却,看一眼曲线就知道参数设得合不合理。如果部分任务对出口稳定度要求高,可以把他们家的长效静态IP单独留一批,专门伺候需要长时间在线的活。
常见问题
Q: 冷却时间到底设多长合适?
没有标准答案,从目标网站限频周期的1.2倍起步。跑一周,统计观察池里IP的"复活率"——冷却结束回池后第一次验证的通过率。低于八成说明冷却不够,往后加;高于九成五还有富余,可以适当缩短,把IP的可用窗口用足。
Q: IP池规模要多大才够用?
按并发量倒推。假设同时跑50个任务,每个任务平均一分钟换一次IP,单IP有效期内复用3次,那每小时大概需要1000个新鲜IP。池子常备量保持在峰值需求的两倍,再给冷却队列留出容量,基本就稳了。
Q: 复用的IP成功率明显下降怎么办?
先看降级曲线。如果是缓慢下滑,把复用上限调低两成,同时收紧优质池的准入分数;如果是断崖式下跌,多半是目标站收紧了风控,这时候别急着调参数,先补一批新IP顶上,再慢慢排查原因。
Q: 自己搭池子和直接用服务商现成的,怎么选?
两者不冲突。服务商的池子解决"补给",自己的池子解决"调度"。像神龙HTTP这类服务商本身有可用率监控和纯度过滤(IP纯度99.8%),你完全可以只做本文第二、三节里的分级和冷却,验活和补充交给API提取,省下的精力用来调自己的调度参数,性价比最高。