先弄明白:你掏钱买的到底是"通道"还是"流量"
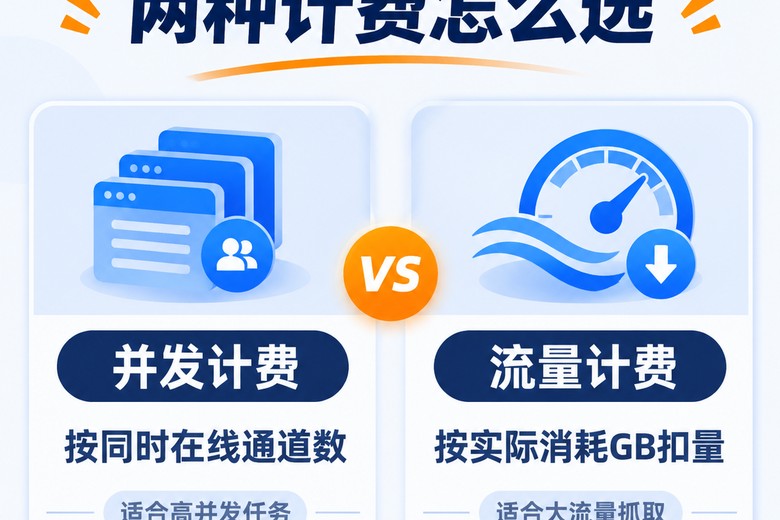
接触过不少做数据采集的团队,第一次买代理IP池时最容易犯的错,是把报价单上的数字当成"能跑多少任务"。其实市面上的计费口径基本就两种,你买的东西不一样,钱花出去的节奏也完全不一样。
第一种按并发算,卖的是"同时能开多少条通道"。你买了 50 并发,就等于同一秒里最多有 50 个请求在走代理,跑完一个换一个,只要不超过这个数,一天跑多少页它不管你。第二种按流量算,卖的是 GB 数,不管你同时开几条通道,扣的是实际跑过去的数据量,跑得多扣得快。
这两种没有谁更划算,只有谁更贴合你的活儿。搞不清楚就下单,最后大概率是钱花了、任务还没跑完。所以下面的顺序是:先看任务长什么样,再算自己需要多少并发或多少流量,最后才去看套餐。
并发怎么估?用 QPS 乘响应时间,别拍脑袋
并发这个数字是可以算出来的,不用凭感觉。拿采集商品详情页举例,你希望一小时跑完 18 万页,平均到每秒就是 50 个请求,也就是 QPS 等于 50。代理的响应时间假设是 1.5 秒(含建连和回包),那么同一时刻需要同时在跑的请求数 ≈ 50 × 1.5 = 75。
算出来 75 就买 75 吗?不建议。真实环境里有重试、有慢节点、有目标站点偶尔的抖动,留 20%~30% 的余量比较稳,75 往上取到 95 或 100 更合适。反过来,如果你的任务对时效没要求,比如一个晚上跑完就行,那把 QPS 压到 10,并发需求立刻降到 15 左右,成本差好几倍。
这里有个细节值得说:并发不是越多越好。目标站点对单IP的请求频率是有感知的,你把并发开得很大,反而容易触发限制,然后大量请求失败、重试、再失败,实际有效吞吐还不如老老实实开到 50。所以估算出来的数字,先按七折试跑两个小时,看成功率再决定要不要加。
流量怎么估?单页体积乘页数,再打个余量
流量这条线更好算,也更适合那些"页数多、单页小"的任务。一个普通详情页的 HTML 大概 80~150KB,取中间值 120KB。假设你一天要跑 20 万页,那就是 120KB × 200000 ≈ 24GB。这还没算上失败重试和跳转的中间页,按经验乘个 1.3,一天差不多 31GB。
要是你还要抓图片或者接口返回的 JSON 体比较大,这个数字可能翻好几倍,一定要按真实样本量过一遍。最简单的验证方法是:挑 200 个目标页,用代理实际跑一遍,看工具里统计的流量增长了多少,再乘以你的总页数,误差会比空想小得多。
| 对比项 | 按并发计费 | 按流量计费 |
|---|---|---|
| 计费单位 | 同时在线通道数 / 月或天 | 实际消耗 GB |
| 成本随什么涨 | 随峰值压力涨 | 随总页数和单页体积涨 |
| 更适合的任务 | 时效紧、QPS 稳定的采集 | 页数多但单页小、跑多久都行的采集 |
| 容易踩的坑 | 并发买多了闲置,买少了排队 | 单页体积估小,跑到一半没量了 |
| 成本可预测性 | 高,跑完这个月就是这些钱 | 中,取决于实际消耗 |
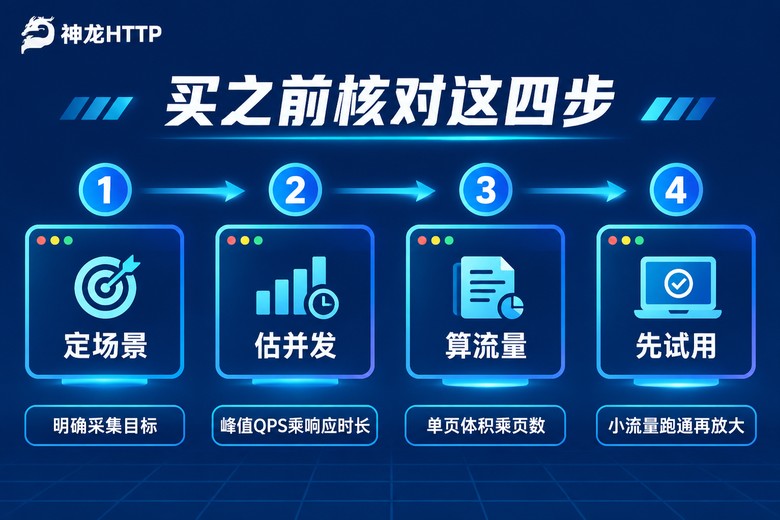
下单前的核对清单,这四步走完再付款
数字算完只是第一步,真正决定体验的是池子本身的质量和服务细节。下面这四步,我一般建议按顺序走一遍,整个流程两三个小时能跑完,但能省掉后面一堆麻烦。
第一步,把场景写清楚。是抓公开的商品信息,还是给模型训练做语料清洗?目标站点在哪个地区?每天大概多少页?这三点写下来,服务商那边才能给你合适的类型建议,你自己也不会被各种名词绕晕。
第二步,对一下并发和流量的数字。把上面算出来的并发峰值、日流量报给对方,问清楚计费是从什么时候开始算、失败请求扣不扣量。这个问题很关键,有的池子失败也算消耗,你的实际成本会高出不少。
第三步,确认池子的底子。包括IP资源规模和覆盖城市、可用率与纯度的公开口径、支持 HTTP / HTTPS / SOCKS5 哪几种协议、提取方式是否支持 API 和按需换IP。做公开数据采集的,城市级定位能力值得多问一句,因为很多站点的内容是按地区返回的。
第四步,小量试跑。别一上来就买大套餐,先拿最小规格跑一天,看成功率、看平均响应、看IP失效后自动重试的表现。跑通了再放大,这个习惯能帮你避开绝大多数"买完才发现不合适"的尴尬。
神龙HTTP在这件事上能帮到什么
如果上面这套算下来,你发现自己既有高峰时段的高并发需求,又有平时大量的页面抓取,那单一计费模式往往不够用,这时候找一家产品线齐的服务商会省事很多。神龙HTTP这边有短效动态IP、长效静态IP和固定IP代理三条线,短效动态适合那种"每个请求都要换一个IP"的抓取,长效静态和固定IP则适合需要保持同一出口的登录态场景,可以按任务分开配。
资源底子这块,官方口径是 3000万+正规授权代理IP储备,国内三大运营商正规授权,可用率 99.9%、IP纯度 99.8%,支持 300+ 城市级精准定位。做按地区返回内容的采集时,城市级定位这个能力直接决定你抓到的数据对不对得上,值得重点用一用。
另外提一个容易被忽略的点:个人中心里有可视化的用量统计和实时监控,能看趋势、能识别异常。这意味着你不需要自己再写一套监控脚本去盯着消耗,跑起来之后每天点开看一眼,哪个时段流量突然飙升、哪个任务成功率掉了,一目了然。对按量计费的场景来说,这个功能本身就等于帮你控成本。
接进来其实就几行代码
技术侧不用担心复杂。神龙HTTP 的 API 兼容主流爬虫语言,文档里有示例代码,拿 Python 来说,先调接口取一批IP,再塞进 requests 里就能跑:
import requests

# 1. 从API提取一批IP(返回格式按文档选择,这里取文本行)
api = "https://你的提取链接"
resp = requests.get(api, timeout=10)
ip_list = [line.strip() for line in resp.text.splitlines() if line.strip()]

# 2. 拿第一个IP试跑一个目标页
proxy = ip_list[0]
proxies = {"http": f"http://{proxy}", "https": f"http://{proxy}"}

r = requests.get("https://目标站点/某个公开页面",
                 proxies=proxies, timeout=8)
print(r.status_code, len(r.content))  # 200 和字节数,用来核对流量估算

# 3. 失败就换池子里的下一个IP重新请求
for p in ip_list[1:]:
    try:
        r = requests.get("https://目标站点/某个公开页面",
                         proxies={"http": f"http://{p}", "https": f"http://{p}"},
                         timeout=8)
        if r.status_code == 200:
            break
    except Exception:
        continue
这段代码跑完,你至少能拿到两个真实数字:单页的实际返回体积,以及单个IP的成功率。把返回体积乘上你的总页数,就是你该买的流量;把成功率乘上你需要的QPS,就是该买的并发余量。用真实数据回填前面的估算,比任何测算表都可靠。
常见问题
Q:我既不确定并发也不确定流量,第一次买多少合适?
先买最小规格跑一天。用一个明确的小目标去测,比如"今天跑完 2 万页商品详情",跑完看两个数字:消耗了多少流量、峰值时段用到了多少通道。这两天的实测结果,就是你后面放大采购的依据,比销售推荐的套餐靠谱得多。
Q:按并发买,是不是一天跑多少页都行?
理论上是,只要你不超过购买的同时在线数。但实际的瓶颈常常在目标站点那边,请求太密会被限制,所以别把并发开满。更稳的做法是把并发控制在估算值附近,配合失败重试和适当的间隔,成功率上去了,有效产出反而更高。
Q:IP质量怎么看?光看可用率够吗?
不够。可用率是整体口径,你还要看自己的目标站点在你这批IP上的实际成功率。方法很简单,拿 50 个IP去打同一个页面,统计返回 200 的比例,再换一个时段重复一次。如果白天和晚上的差距特别大,说明池子的稳定性在你的使用时段有问题,该换个类型试试。
Q:跑一段之后发现流量估少了,能中途加吗?
正规服务商的用量是按实际消耗走的,快用完时加购就行,但前提是你得提前看到。这就是为什么建议先把可视化用量统计用起来,把每天的消耗趋势当成固定动作看一眼,剩三成的时候就去补,别等断了自己才发现。