做数据采集这行,最怕的不是被封,而是你压根不知道池子里那批IP什么时候集体罢工了。前阵子有个做商品比价的朋友找我,说他脚本跑得好好的,某天上午突然成功率掉到六成,日志里全是超时。翻了两小时才发现,是他那批短效IP的存活周期到了,但轮换逻辑还傻乎乎地按"每请求换一次"在调度,等于一直在拿过期号码打电话。
这事儿说明一个道理:IP池能不能干活,一半看IP质量,一半看你怎么调度它。轮换策略写歪了,再好的池子也白搭;没有可用率监控,出了问题只能靠猜。下面我按实际配置的顺序,把这两件事拆开讲一遍。
池子里的IP为什么会"变废"
先搞明白对手是谁。代理IP失效无非几种情况:短效IP到点自动回收、目标站点把某个IP段整体拉黑、机房出口临时抖动、单IP被限速到几乎不可用。这几种问题的共同点是——它们不会提前打招呼。
所以轮换的本质不是"换得勤",而是"在正确的时机换"。你得让调度器知道当前这个IP还能不能打,什么时候该退场。
另外提醒一句:如果你的池子里混着大量重复IP,轮换等于在原地转圈。检测办法很简单,每次提取后对IP列表做个去重,看看唯一IP数占提取总数的比例。正常情况下这个数字应该接近 100%。
三种轮换思路,选一个适合你的
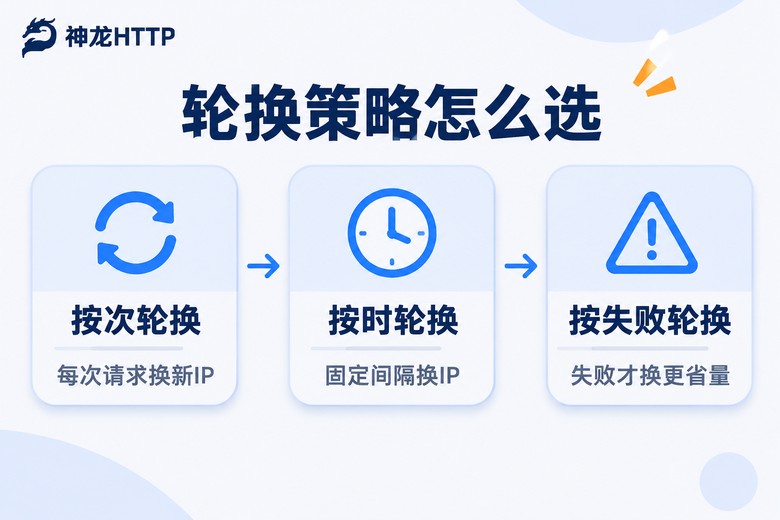
市面上常见的轮换方式其实就三大类,我做过一轮对比,直接上表格更清楚:
| 轮换方式 | 调度逻辑 | 适合的场景 | 主要问题 |
|---|---|---|---|
| 按次轮换 | 每个请求换一个IP | 单次抓取量小、目标站反爬严格 | IP消耗快,连接建立开销大 |
| 按时轮换 | 固定间隔(如60秒)换一次 | 持续抓取、需要保持会话连续性 | 间隔设死容易"换早了"或"换晚了" |
| 按失败轮换 | 请求失败或超时才换 | 追求IP利用率的成本敏感型任务 | 失败当下已经损失了请求,要有兜底重试 |
实际项目里我基本都用混合方案:按失败为主,按时为辅。也就是一个IP连续失败两次就立刻踢出去,同时给每个IP设一个最长使用时长,到了就主动轮换,防止它被慢速限速却一直"假活着"。
有个坑要避开:失败次数不能一刀切。连接超时和返回 403 是两回事,前者可能是网络抖动,后者基本是被识别了。建议对状态码做区分——4xx 类直接判死,超时类给一次重试机会。
写一个能用的轮换调度器
逻辑不复杂,核心是三块:IP队列、失败计数、冷却回收。下面这段是简化版,拿去改改就能接进自己的项目:
import time
import random

class IPPool:
    def __init__(self, fetcher, pool_size=30):
        self.fetcher = fetcher          # 负责调用接口获取新IP
        self.pool_size = pool_size
        self.pool = []                  # 可用IP列表
        self.fail_count = {}            # IP -> 连续失败次数
        self.cooldown = {}              # IP -> 冷却到期时间戳
        self.max_life = 240             # 单IP最长使用秒数
        self.created_at = {}
        self.refill()

    def refill(self):
        need = self.pool_size - len(self.pool)
        if need <= 0:
            return
        fresh = self.fetcher(need)
        for ip in fresh:
            if ip not in self.cooldown:
                self.pool.append(ip)
                self.created_at[ip] = time.time()
                self.fail_count[ip] = 0

    def get(self):
        self.refill()
        now = time.time()
        # 先淘汰超龄IP
        alive = [ip for ip in self.pool
                 if now - self.created_at.get(ip, 0) < self.max_life]
        self.pool = alive or self.pool
        return random.choice(self.pool) if self.pool else None

    def report(self, ip, ok):
        if ok:
            self.fail_count[ip] = 0
            return
        self.fail_count[ip] = self.fail_count.get(ip, 0) + 1
        if self.fail_count[ip] >= 2:          # 连败两次直接出池
            if ip in self.pool:
                self.pool.remove(ip)
            self.cooldown[ip] = time.time() + 300   # 冷却5分钟
几个参数值得调:max_life 别设得比IP本身的存活周期长,短效IP通常1到5分钟,你设240秒没问题,设半小时就是浪费;cooldown 是给被判死的IP留个观察期,DDoS 误判或者临时抖动的情况下,五分钟后再放回来往往就正常了。
另外池子大小别一刀切固定值。并发10的任务配30个IP够用,并发200的还配30个就是找死。经验值是池子容量 ≈ 峰值并发的 2 到 3 倍。
可用率到底怎么算、怎么盯
很多人说"我的可用率99%",问下去发现是拿接口返回的IP数量除以请求数量——这不叫可用率,这叫提取成功率。真正的可用率至少要看四层:
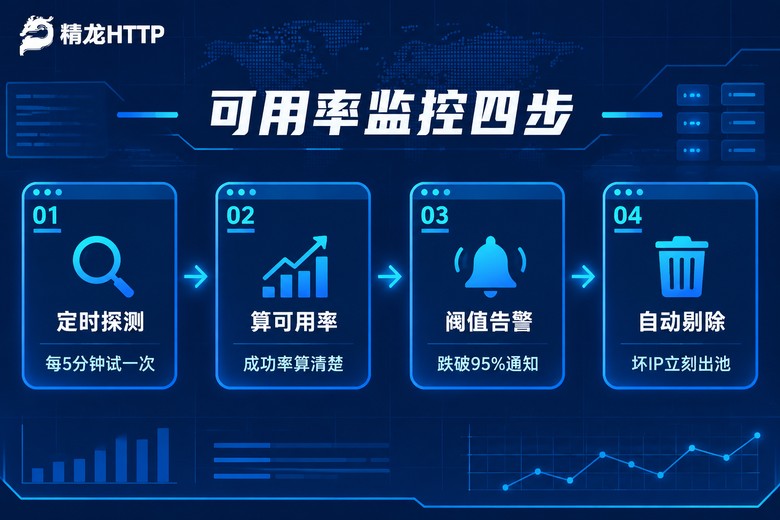
第一层,有效响应率。拿池子里的IP去请求一个固定的小页面(比如目标站的首页),能正常拿到 200 就算通过。这个探测要定时做,5分钟一轮不嫌多,池子大的话可以抽样。
第二层,业务成功率。探测通不代表业务能跑。有些站对首页不设防,对列表页卡得死。所以真实任务的失败率要单独统计,两个数字差得多,说明问题出在业务层而不是IP层。
第三层,延迟分布。只看平均值会骗人。10个IP里9个50毫秒、1个15秒,平均值也才1.5秒。建议看 P95,超过阈值就说明有一部分IP在拖后腿。
第四层,IP重复率。同一批提取里重复IP占比过高,说明池子在缩水,需要扩大提取频率或换更高纯度的资源。
监控要落到告警上,不然等于没做
统计数据躺在日志里没人看,等于白干。我一般的做法是设三个阈值:
1)整体可用率跌破 95% 触发一级提醒,通常是资源池需要补充或者目标站点风控升级了;
2)单个IP连续失败达到 2 次 自动出池冷却,这个不需要通知,写进调度器就行;
3)P95 延迟比基线上升 50% 以上,说明线路质量在变差,该考虑换地区或者换供应商了。
告警的渠道不用搞得很花哨,企业微信机器人、邮件都行。关键是别让告警天天响,否则三天之后所有人都会自动忽略它。阈值调准比告警渠道重要十倍。
还有一个细节容易被忽略:把每天的可用率和提取量做成趋势图,放在一个页面上。很多时候问题不是"突然坏了",而是"连续三天一点点往下掉",趋势图能提前一周告诉你该动了。
资源这块,选对池子能省一半的事
前面讲的都是调度侧的功夫,但坦白讲,如果底层的IP资源纯度不够,你再怎么写策略也是事倍功半。我自己常用的做法是:短效动态IP跑高频采集,长效静态IP跑需要保持登录态的连续任务,两套并行。
这块用神龙HTTP的话比较省心。它家有 3000万+ 正规授权代理IP储备,IP纯度标称 99.8%,三大运营商正规授权这点对需要稳定线路的采集任务挺关键。产品线上短效动态、长效静态、固定IP代理是齐的,支持 HTTP/HTTPS/SOCKS5,API 兼容主流爬虫语言,接进上面那个调度器基本不用改结构。
另外一个我觉得实用的是个人中心的可视化用量统计和实时监控,能看出异常的消耗曲线和使用趋势。前面说的"连续三天慢慢往下掉"这种情况,在用量面板上比在日志里翻要直观得多。
常见问题
Q:轮换越频繁是不是越安全?
不是。换得太勤,一是IP消耗量上去了,二是每次新建连接本身有开销,总耗时反而变长。更关键的是,高频轮换会掩盖掉真正的问题——比如某个地区的IP集体不可用,你轮换得快就只看到失败率高,却定位不到是哪个环节出的毛病。建议按失败为主、按时为辅,别盲目追求"每请求一换"。
Q:可用率已经 99% 了,还需要盯监控吗?
需要,但重心要换。99% 的时候你盯的不该是总数,而是分布——剩下那 1% 是不是集中在某个城市、某个时段、某个目标站上。集中出现就说明有规律,能提前规避;分散出现才是正常波动。监控的目的是找规律,不是单纯看数字好不好看。
Q:池子里的IP突然大面积失效,第一时间查什么?
按这个顺序:先看IP是不是到了存活周期(短效IP过期最常见),再看目标站点是不是改了风控规则(比如加了验证码或者提高了请求头校验),最后看自己的请求频率是不是短时间冲太高。前两步五分钟能排掉,第三步翻一下自己的访问日志就有答案。
Q:静态IP和动态IP该怎么搭配?
看任务类型。需要保持会话连续、登录态的(比如需要维持 cookie 的连续翻页),用长效静态IP;纯公开数据的一次性抓取,短效动态IP成本更低。我的习惯是静态占两成、动态占八成,静态那两成专门跑关键链路,出问题的时候好定位。