很多人在做数据采集的时候,都会遇到一个挺尴尬的情况:代理明明连上了,请求也通了,可目标站点还是能一眼看出你在用代理,甚至直接把你的真实出口地址给识别出来。问题出在哪?大多时候不是代理不能用,而是匿名度不够。
这篇就讲讲怎么自己动手查代理IP的匿名度。不需要多高深的工具,一台机器、几行代码、几次请求,就能把透明、普通匿名、高匿这三种情况区分清楚。下面按"先搞懂等级 → 再找泄漏点 → 最后写成脚本定期跑"的顺序,一步步来。
先分清三档:透明、普通匿名、高匿到底差在哪
别急着写代码,先理解这三档的本质区别,后面看结果才不会误判。
透明代理,说白了就是"帮你转发了,但也把底给交代了"。请求经过它之后,目标站点不仅知道你来自代理,还能看到你原本的真实地址。常见的表现是请求头里多出 X-Forwarded-For、X-Real-IP 这类字段,并且回显的IP里同时出现了代理地址和你的原始地址,两者并存。
普通匿名代理,也就是大家常说的"匿名代理",它把真实地址藏住了,但会留下"我是代理"的痕迹。例如请求头里出现 Via、Proxy-Connection 这些字段,或者返回的连接信息里能看出经过了中间层。目标站点知道你在用代理,只是不知道你是谁。
高匿代理,也就是高匿名代理,理想状态是伪装成一次普通的直连访问。请求头干净、不透露代理痕迹、回显的地址就是代理出口本身,看不出中间有谁。做公开数据采集时,这一档通常是最省心的。
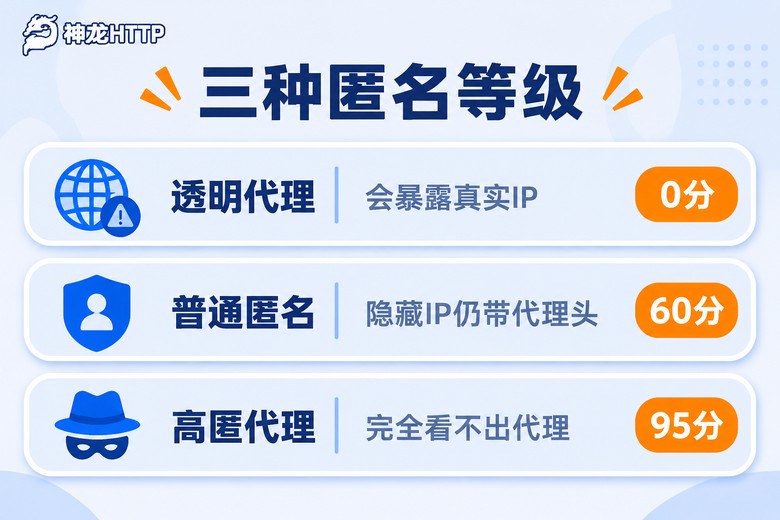
用一张表把三者的差别固定下来,方便你检测时对号入座:
| 等级 | 真实地址是否暴露 | 是否暴露"用了代理" | 典型特征 |
|---|---|---|---|
| 透明代理 | 暴露 | 暴露 | X-Forwarded-For 里带真实IP |
| 普通匿名 | 不暴露 | 暴露 | 有 Via / Proxy-Connection 字段 |
| 高匿代理 | 不暴露 | 不暴露 | 请求头干净,回显即出口IP |
第一处泄漏点:回显的出口地址是不是"双IP"
最简单的检测方式,就是找一个会把请求头原样回显的测试接口,让它把你这次请求的所有信息吐出来。重点看两件事:返回的 origin 字段里是不是只有一个IP,以及这个IP和你配置的代理地址是不是同一个。
如果是透明代理,经常会出现类似 "1.2.3.4, 5.6.7.8" 这样两个地址用逗号连着的情况——前面是你的真实地址,后面是代理出口。看到这种双IP,基本可以直接判定匿名度不合格。
用 Python 跑一次看看:
import requests

proxies = {
    "http": "http://用户名:密码@代理地址:端口",
    "https": "http://用户名:密码@代理地址:端口",
}

r = requests.get("https://httpbin.org/ip", proxies=proxies, timeout=10)
print("回显内容:", r.text)
跑完盯住返回的那一行。只有一个IP、且等于你拿到的代理地址,说明出口伪装得不错;出现逗号分隔的多个地址,就是透明代理的典型信号。这一步做下来,其实已经能排掉一大半不合格的IP了。
第二处泄漏点:请求头里有没有"转发痕迹"
光看IP还不够,有些代理地址藏得很好,但请求头出卖了它。这时候就要把整份请求头打印出来逐行看。
把上面的接口换成 https://httpbin.org/headers,把返回的 headers 全部打印,然后找这几类关键字:
X-Forwarded-For —— 出现它,而且值里带的是一个非代理地址,说明你的原始位置被记录了。X-Real-IP —— 同理。Via —— 有条目通常意味着经过了中间转发层,属于普通匿名的典型标志。Proxy-Connection —— 同样属于代理痕迹。
一个实用的小技巧:先用直连跑一遍同样的接口,把干净的请求头存成一份"基线";再用代理跑一遍,两相对比,多出来的字段一眼就能看出问题。这比凭感觉判断靠谱多了。
headers_proxy = requests.get(
    "https://httpbin.org/headers", proxies=proxies, timeout=10
).json()["headers"]

suspect = ["X-Forwarded-For", "X-Real-IP", "Via", "Proxy-Connection"]
hits = [k for k in headers_proxy if k in suspect]
print("可疑字段:", hits or "未发现,匿名度良好")
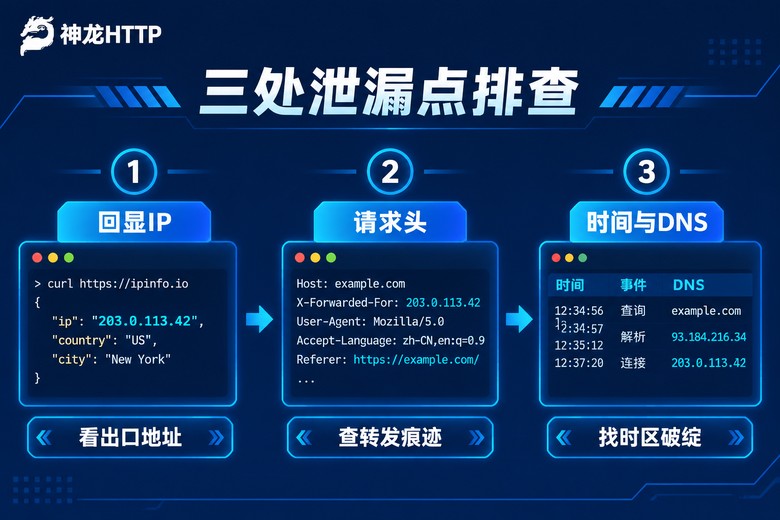
第三处泄漏点:时间、时区与解析信息也会说话
前两处都干净,也别急着下结论。有些代理IP虽然请求头清爽,但细节上露了马脚。
看时间。把返回里带时区或本地时间的字段拿出来,和你声称的访问地区对一下。比如你用的是某城市的IP,可服务端时间明显偏到另一片时区,这就是个可疑信号。做市场研究、按地区抓取内容时,这一条尤其要注意。
看稳定性。同一个IP连续请求二三十次,统计一下响应延迟的波动。延迟忽高忽低、偶尔超时重连,说明这条线路的质量不稳,虽然它未必"不匿名",但实际采集体验会很难受。
看一致性。多换几个不同的回显接口交叉验证。有的站点回显口径不一样,只测一个接口容易被误导。两三个来源的结果一致,结论才站得住。
把检测写成脚本,定期跑一遍
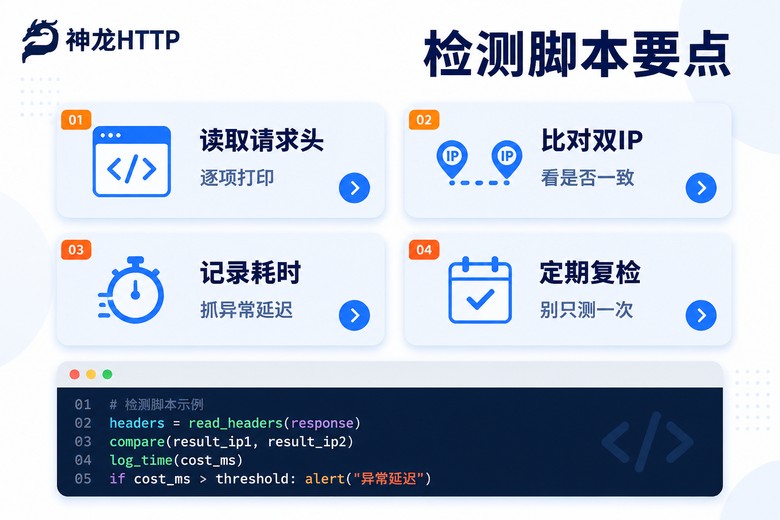
手测一次两次够用,但如果代理是长期在用的,最好把它变成一个能定期执行的小脚本。思路很简单:进入检测 → 校验回显IP是否为单值 → 扫描请求头可疑字段 → 记录耗时 → 输出结论,五步串成一条流水线。
def check_anonymity(proxy_url, timeout=10):
    proxies = {"http": proxy_url, "https": proxy_url}
    result = {"ip": "", "level": "", "note": ""}
    try:
        info = requests.get(
            "https://httpbin.org/headers", proxies=proxies, timeout=timeout
        ).json()

        origin = info.get("origin", "")
        hdrs = info.get("headers", {})
        result["ip"] = origin

        dirty = [k for k in hdrs if k in
                 ("X-Forwarded-For", "X-Real-IP", "Via", "Proxy-Connection")]

        if "," in origin or dirty:
            result["level"] = "透明/普通匿名"
            result["note"] = "泄漏字段:" + (", ".join(dirty) or "双IP回显")
        else:
            result["level"] = "高匿"
            result["note"] = "未见泄漏痕迹"
    except Exception as e:
        result["level"] = "检测失败"
        result["note"] = str(e)
    return result

print(check_anonymity("http://用户名:密码@代理地址:端口"))
几个容易踩的坑顺手提一下:别只测一次,短效动态IP每次出口都可能变,至少抽测两到三次;别忽略超时,超时不等于不匿名,可能是线路抖动;别把失败当结论,脚本要能区分"检测失败"和"匿名度不合格"这两种状态,否则你会误杀一批好IP。
选IP时顺手把匿名度一起考虑进去
检测做多了会发现一个规律:匿名度这件事,本质上不是"测出来的",而是"选出来的"。源头不干净的IP,再怎么测也测不出高匿;而正规来源的IP,检测通常只是确认一下。
神龙HTTP 这边的代理资源是国内三大运营商正规授权,3000万+的IP储备,IP纯度做到99.8%,可用率99.9%,支持HTTP/HTTPS/SOCKS5 三种协议,短效动态、长效静态、固定IP都有。实际用下来比较省事的点是:300+城市级精准定位,需要哪个地区的出口直接指定,配合脚本里的时区、地区校验逻辑,前后能对得上,不会出现"IP在A地、时间在B地"这种自相矛盾的情况。
另外个人中心里有可视化的用量统计和实时监控,能看使用趋势,也能及时发现异常调用。对做公开数据采集、AI大模型训练这类需要持续跑量的场景,这比一条条手工测要高效得多。API 也兼容主流爬虫语言,文档和示例代码都有,集成进去不费劲。
常见问题
Q:只用一个回显接口测出来的结论可信吗?
不太可靠。不同站点的回显口径不完全一样,有的只给IP,有的给完整请求头。建议至少用两到三个来源交叉比对,结果一致再下结论。只测一个接口,很容易把普通匿名误判成高匿。
Q:请求头里没有泄漏字段,就一定是高匿代理吗?
不一定。请求头干净只是必要条件之一。还要看回显的出口IP是不是单值、前后是否一致、时间时区和声称地区是否吻合。三项都过了,基本可以算高匿;只有一项干净,只能说"看起来不错"。
Q:每次检测结果都不一样,是IP有问题吗?
先看用的是不是短效动态IP。这类IP每次提取出口可能变化,回显地址自然不同,属于正常现象。建议在短时间内连续抽测两三次,看整体是否稳定,而不是死盯某一次的结果。
Q:检测显示"失败"是不是就等于这条IP不能用?
两者要分开看。失败可能是网络抖动、超时或认证错误,不代表匿名度不合格。脚本里最好把"连接失败"和"匿名度不足"做成两个独立状态,否则容易把好IP误判掉,白白浪费资源。