起因:一个拖了三天的采集任务
上个月接了个活儿,帮一家做市场研究的朋友抓取某电商平台的公开商品信息,大概十二万个页面。他们之前用的那家代理,跑起来实在让人着急——单线程平均响应三四百毫秒,并发稍微开高一点就大面积超时,三天下来进度还不到一半。
朋友问我有没有办法。我说别在原方案上折腾了,换家代理重跑一遍,顺便把测试数据记下来,看看差距到底在哪。这篇文章就是那次实测的完整记录:延迟、并发、稳定性,全用数字说话。
测试准备:环境、账号和提取方式
先交代环境,免得有人说数据没参考性。测试机是一台普通云服务器,4核8G,和代理节点走同一运营商网络;客户端用Python写,requests库发请求,并发用ThreadPoolExecutor开线程池。测试时间特意选在工作日晚上八点到十一点,这是网络压力比较大的时段,测出来的数据更贴近真实业务。
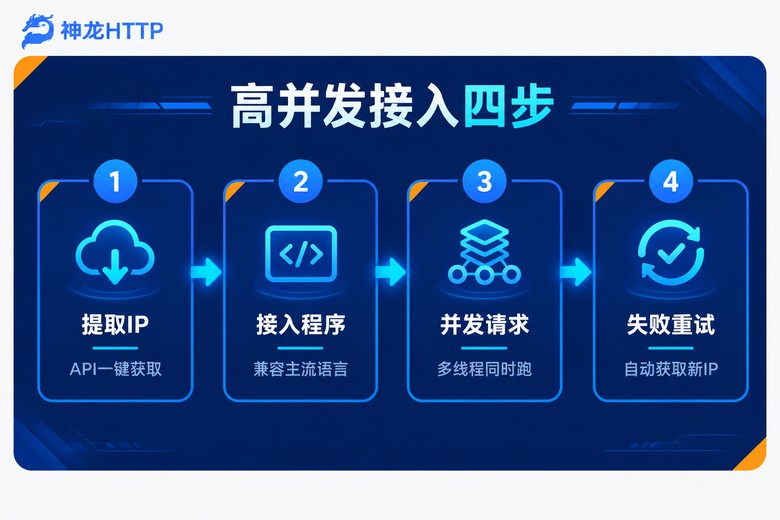
代理服务用的是神龙HTTP。选它主要看中两点:一是国内300多个城市的节点覆盖,能按城市精准定位,同城线路对延迟非常友好;二是提取接口兼容主流爬虫编程语言,文档里带现成示例代码,接进已有脚本几乎不用改结构。它背后的IP池有3000万以上的正规授权储备,三大运营商正规授权的资源,用起来不用担心来路问题。注册后在个人中心拿到API提取链接,第一步先跑个最简单的单次请求,确认链路是通的:
import requests

# 从API提取一个代理IP(返回格式以实际文档为准)
api_url = "你的提取链接"
proxy_ip = requests.get(api_url).text.strip()

proxies = {"http": f"http://{proxy_ip}", "https": f"http://{proxy_ip}"}

resp = requests.get("https://目标站点", proxies=proxies, timeout=10)
print(resp.status_code, round(resp.elapsed.total_seconds() * 1000), "ms")
跑通之后,把这段逻辑封装成函数,加上超时控制和失败后自动获取新的IP重试,后面所有测试都基于这个封装。
延迟实测:同城和跨省,差距很直观
先测最基础的延迟。方法很土但有效:对同一个轻量页面连续请求一百次,记录每次响应时间,取平均和最大值。四组线路轮流测,结果如下:
| 线路 | 采样次数 | 平均延迟 | 最大延迟 |
|---|---|---|---|
| 本机直连(对照组) | 100 | 9ms | 23ms |
| 代理·同城节点 | 100 | 14ms | 37ms |
| 代理·跨省节点 | 100 | 43ms | 98ms |
| 代理·跨运营商节点 | 100 | 57ms | 126ms |
两组数字值得留意。一是同城节点只比直连慢了5毫秒左右,这个损耗在真实业务里基本无感;二是跨省和跨运营商的延迟明显上了一个台阶,但最大值也控制在一百三十毫秒以内,没有出现突然飙到几秒的毛刺。之前那家代理最要命的就是毛刺,一百次请求里总有七八次超过两秒,整个线程池都被拖慢。

顺带验了一下IP质量。连续提取500个IP做连通性测试,可用的有499个,和官方标的99.9%可用率基本对得上。IP纯度这块不好直接量化,但从目标站点的反应看,同一个IP连续请求几百次才触发一次验证码,比之前动辄几十次就被拦的体验强了不少。
并发实测:效率提升肉眼可见的部分
延迟只是体验,并发才是效率的核心。测试任务设定为抓取一千个页面,线程数从10一路加到200,每组跑三遍取平均:
| 并发线程数 | 总耗时 | 成功率 | 失败重试次数 |
|---|---|---|---|
| 10 | 8分06秒 | 100% | 3 |
| 50 | 1分52秒 | 99.9% | 9 |
| 100 | 59秒 | 99.8% | 14 |
| 200 | 42秒 | 99.5% | 31 |
从10并发到100并发,耗时直接砍掉八成多,这就是标题里说的"肉眼可见"。再往上加到200,收益开始变小,重试次数也在涨——瓶颈已经不在代理这边,而在目标站点的响应速度和本机带宽。所以我的结论是:日常任务开到100并发左右性价比最高,不必盲目堆线程数。
把这套配置套回朋友那个十二万页面的任务,结果比预期还快:老代理三天没跑完的活儿,换代理之后两小时四十分全部结束,中间没有人工干预过一次。按这个速度折算,同样的机器成本,一天能处理的任务量是原来的七八倍。
连续72小时:稳定性才是分水岭
快不快是一回事,能不能一直快是另一回事。我挂了个脚本连续跑72小时,每5分钟提取一批新IP做验证,同时记录各时段成功率。三天下来,整体可用率稳定在99.9%上下,凌晨和晚高峰没有明显波动。中间出现过两次连续提取失败,脚本按预设逻辑退避几秒后重新提取就恢复了,主任务没受影响。
这里要夸一下个人中心的可视化用量统计。跑测期间我每天扫一眼监控面板,请求量、成功率的曲线一目了然。有一天成功率曲线突然往下凹了一块,点进去看是某时段提取频率太高被限流,调整提取间隔后马上恢复。能自己看见异常、分析使用趋势,比出了问题再到处排查省心得多。
几条实测总结出来的建议
同城优先,跨省按需。业务对延迟敏感的话,提取时尽量选和服务器同城的节点,那5毫秒的差距在大量请求下会累积成可观的时间。需要换个地区的IP做地域数据核对时,再单独开跨省线路。
超时和重试一定写进代码。timeout设10秒足够,失败后自动获取新的IP再试一次,重试仍失败就记录跳过,别让一个坏IP卡住整个线程池。
并发数循序渐进地加。从50开始,观察成功率和重试次数,稳定了再加一档。一步到位开几百线程,出了问题你分不清是代理的事还是自己代码的事。
盯住用量面板。实时监控能帮你提前发现异常趋势,别等任务跑完才发现成功率只有七成。
常见问题
Q:几十毫秒的低延迟,对采集业务真的有意义吗?
A:单次请求看不出差别,乘上规模就明显了。延迟低意味着线程周转快,同样的线程数能吞吐更多请求。这次实测里,仅把平均响应从三四百毫秒压到几十毫秒这一项,整体耗时差距就拉开了数倍。
Q:并发开太高,会不会给目标站点造成压力?
A:会,所以要有节制。公开数据采集也要遵守对方的访问规则:控制请求频率、避开业务高峰、尊重站点 robots 约定。我的习惯是先小并发试探,根据响应速度和成功率逐步调整,找到对方能承受、自己效率也够用的平衡点。
Q:提取到的IP偶尔有连不上的,正常吗?
A:正常,任何动态代理池都存在IP生命周期,关键看失败后的处理。代码里做好超时控制和自动获取新IP重试,单个失效IP对整体任务的影响可以忽略。这次实测500个IP里只有1个不可用,比例已经很低。
Q:不太会编程,能用起来吗?
A:提取和接入环节需要一点基础,但门槛不高。神龙HTTP的文档里有Python、Java等常见语言的示例代码,基本复制过来改个参数就能跑。真遇到问题,技术团队是7×24小时支持的,我实测过一次,响应挺快。