晚上十点,数据组的任务看板又红了。不是网站改版,也不是脚本崩了,是代理池里能用的IP不够,队列越堆越长。负责采集的小刘一开始以为“买独享代理就完事”,结果套餐写着100并发,实际跑起来一半请求在排队。后来复盘才发现,独享代理IP怎么选,真不是只看“独享”两个字,得先把并发量和IP池规模这两笔账算清楚。
独享代理IP,独享的往往只是IP本身
先别急着看价格。很多服务商说的独享,指的是这个IP只分配给你,不和其他用户混用;但带宽、并发通道、目标站点限流,未必一起独享。也就是说,你拿到的是一个相对干净的IP,不等于拿到了无限并发。
问销售时别只问“是不是独享”,要追问三件事:
- 并发是独享还是共享?高峰期会不会被别人挤占?
- 请求超时、连接失败算不算消耗?扣不扣量?
- 同一个IP连续用多久会被目标站限制?后台能不能看到失败明细?
独享IP更适合需要稳定身份的任务,比如长期观察一个公开价格页、固定栏目内容更新。反过来,短时间跑大量公开资讯采集,未必要死磕独享,先看并发和池子能不能匹配任务更实际。
并发量别照抄套餐,用任务倒推更靠谱
并发量可以理解成“同一秒里,有多少个请求正在路上”。估算公式不复杂:所需并发 ≈ 每秒请求数 × 单个请求平均耗时。举个例子,你要每分钟抓1200个页面,平均每秒20个请求;每个请求往返0.8秒,那理论并发至少16。如果目标站响应慢到2秒,并发就要40。
再留余量。真实网络会抖,目标站会限速,脚本重试也占并发。我的习惯是在理论值上再加30%。16就按21-24准备,40就按52-55准备。不要等任务跑崩了才想起来加钱。
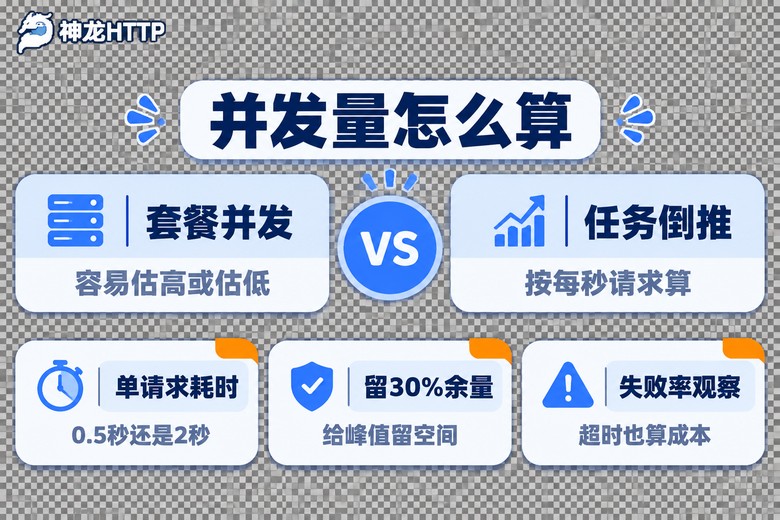
这里最容易踩的坑,是把“套餐并发”当成“业务并发”。套餐写100并发,如果你的单请求耗时3秒,理论每秒只能完成33个请求;如果目标站每个IP每秒只放5个请求,那并发开再大也只是排队。还有一种情况:脚本设置了失败重试,一次超时变成三次请求,实际并发翻倍,池子消耗也跟着涨。
上线前可以先跑一个小测试,把平均耗时和失败率摸出来:
import time
import requests
from concurrent.futures import ThreadPoolExecutor

# 代理列表从后台导出,测试页换成你要采集的公开页面
PROXIES = ["http://用户:密码@代理地址:端口"]
TARGET = "https://你的测试页面"

def fetch(proxy):
    start = time.time()
    try:
        r = requests.get(
            TARGET,
            proxies={"http": proxy, "https": proxy},
            timeout=5
        )
        return time.time() - start, r.status_code
    except Exception:
        return time.time() - start, 0

with ThreadPoolExecutor(max_workers=20) as pool:
    results = list(pool.map(fetch, PROXIES))

ok = [x for x in results if x[1] == 200]
avg = sum(x[0] for x in ok) / max(len(ok), 1)
print("成功数", len(ok), "平均耗时", round(avg, 2), "秒")
print("建议并发参考", round(20 * avg * 1.3))
这段代码不复杂,重点看三个数:成功数、平均耗时、建议并发参考。跑20个并发,如果平均耗时是1.2秒,建议并发大约31;如果平均耗时飙到4秒,说明目标站已经吃力,先降速比加并发更管用。
IP池规模:先算每天要获取多少新IP
IP池规模不是越大越好,而是看“够不够轮换”。评估思路可以写成:每天需要的IP数 ≈ 每天总请求量 ÷ 单个IP一天的安全请求量。安全请求量没有统一值,要看目标站脾气。小型公开资讯站可能一个IP跑500次都没事,本地生活类页面可能100次就开始弹验证。
拿一个实际场景算:一天20万页,单IP每天跑200次就被限,那至少1000个IP打底;如果单IP只能跑50次,就要4000个。再按20%-30%冗余准备,1000个的盘子实际按1300个来估,4000个的盘子按5000个来估。别按理论值卡死,池子一紧,任务就开始堵。
| 任务类型 | 日请求量 | 单IP安全量 | 估算IP数 | 额外关注 |
|---|---|---|---|---|
| 商品价格页观察 | 20万 | 200次 | 1000个 | 城市定位、稳定性 |
| 公开资讯采集 | 5万 | 500次 | 100个 | 时效、失败重试 |
| 门店信息核对 | 8万 | 100次 | 800个 | 城市覆盖、纯度 |
| 搜索结果页观察 | 30万 | 50次 | 6000个 | 可用率、耗时波动 |
城市覆盖也要看。你采的是本地生活、门店价、区域招聘,IP落到哪个城市会影响返回内容。神龙HTTP有300+城市级精准定位,这种场景可以先按城市拆任务,再看每个城市需要多少IP,而不是拿一个大池子乱撞。但别把城市多当成池子大,城市覆盖和IP总量是两件事,前者解决“对不对”,后者解决“够不够”。
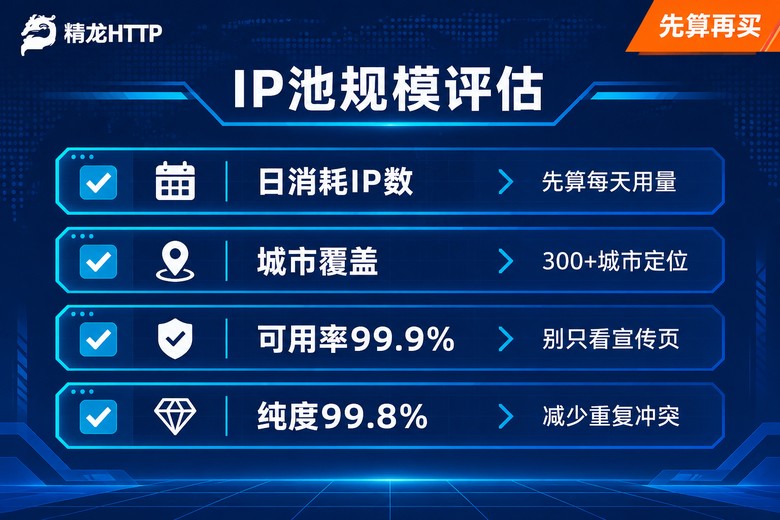
还有两个指标别忽略:可用率和纯度。可用率99.9%听着高,但如果你的脚本不做失败重试,实际跑起来还是会卡;IP纯度99.8%意味着重复、污染少,能减少“拿到IP却用不了”的浪费。评估池子时,最好把“能提取多少”和“提取出来能不能用”分开看,后者往往更影响任务完成时间。
把并发和池子放在一张表里试,别直接签长单
我一般让团队做“小账本”试跑:拿10%的任务量,跑2小时,记录成功率、平均耗时、超时率、单个IP连续使用次数。比如日任务20万页,先拿2万页试,分三个时间段跑,早中晚各一轮。这样能看出目标站的高峰和低谷,也能看出代理池在压力下的真实表现。
试跑时重点看这几项:
- 高峰并发有没有掉:套餐写50并发,实际高峰只跑到30,说明通道或池子有瓶颈。
- 失败后获取新的IP要多久:接口响应慢,脚本重试就会拖垮整体节奏。
- 同一城市能不能稳定拿到:做区域数据时,城市乱跳比IP少更麻烦。
- 后台能不能看到用量趋势:没有明细,出了问题只能靠猜。
如果不想自己从零拼池子,神龙HTTP的3000万+正规授权代理IP储备和300+城市级精准定位,可以先解决“池子够不够、城市对不对”这两个基础问题。用真实任务跑一轮小流量试跑,比在报价单上反复比较更有效。
常见问题
Q:独享代理IP是不是并发就一定比共享高?
不一定。独享说的是IP不混用,并发还受套餐通道、带宽、目标站限流影响。签约前问清楚并发是独享还是共享,别只看“独享”两个字。
Q:IP池规模是不是越大越好?
看任务。每天请求量不大、目标站限流松,小池子够轮换就行;大规模公开数据采集才需要更大池子和城市覆盖。先算每天要获取多少新IP,再留20%-30%冗余,别为用不上的规模买单。
Q:并发量估算有没有简单公式?
所需并发 ≈ 每秒请求数 × 单请求平均耗时,再上浮30%左右。比如每秒20个请求、单请求0.8秒,理论并发16,实际按21-24准备更稳。上线后用失败率和平均耗时校正,不要一次把并发拉满。
Q:神龙HTTP适合什么场景?
公开数据采集、市场研究这类需要稳定获取IP的场景比较合适。它有3000万+正规授权代理IP储备和300+城市级精准定位,适合先按并发和池子规模做小流量试跑,再决定用哪种产品形态。