同一个脚本,两种结果,差在哪儿
上周有个做公开数据采集的朋友问我,说他那套抓商品价格的脚本,上个月跑得挺稳,这个月 10 次有 6 次要重试。我看了一眼他的配置——动态IP是有的,但只挂了一个固定不变的提取通道,一天换一次。
问题不在"有没有动态IP",而在于他用的那种动态IP,轮换方式和他的采集节奏根本不匹配。目标站点大概每 20 分钟就会对同一来源的访问做一次频次判断,他一天才换一次,中间二十多个小时全靠同一个出口硬撑,当然吃力。
所以聊"动态ip代理有哪些类型",光说"动态"两个字没有意义。真正要拆开看的是两件事:IP 多久换一次、是谁在换(轮换方式),以及这些IP本身是从哪儿来的(资源来源)。这两条轴一交叉,选型就清楚了。
按轮换方式分:三种动态IP,脾气完全不一样
先把最常被混着说的三种模式分开讲。名字各家叫法不同,但本质就这三类。
第一种,每次请求轮换。你发一个请求,出口就是一个新 IP;再发一个,又是另一个。你在客户端完全不用管换IP这件事,配置里写一个入口地址就行,剩下的由服务端在背后调度。这种模式的好处是省心,缺点是你对"当前是哪个IP"没有控制权,遇到需要连续会话的场景(比如要带着 cookie 走完一个下单流程)就会断掉。
第二种,定时轮换。IP 有一个存活周期,比如 1 分钟、5 分钟、30 分钟,时间一到自动换。这种模式适合需要一点点连续性的任务:同一批页面在周期内用同一个 IP 抓完,周期结束换新的。我一般建议把周期设成目标站点频次阈值的 1.5 倍左右,比如对面 10 分钟一判断,你设 15 分钟,留出余量。
第三种,手动提取。你在控制台或者通过 API 主动"要一批",拿到手自己分配,用完再要。这种模式的掌控感最强,也最考验你的调度代码——你得自己维护一个池子,标记哪些快过期了、哪些已经被目标站点拒绝了。
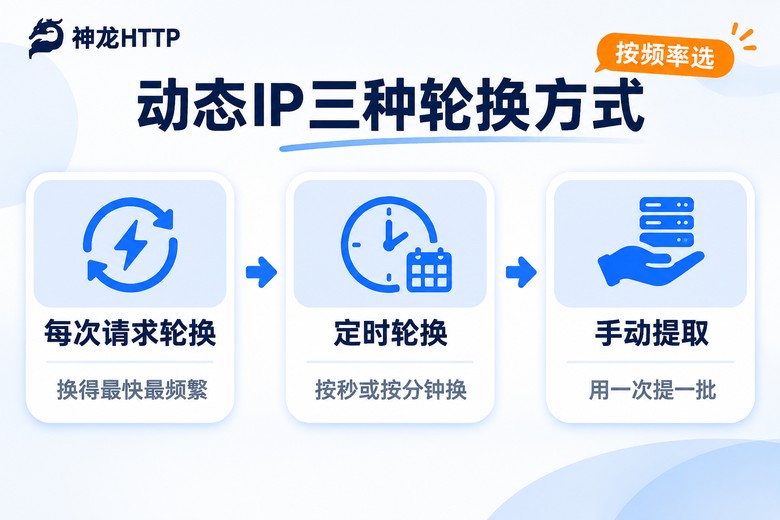
三种模式没有优劣,只有匹不匹配。小批量、请求间彼此独立的任务,第一种最省事;有流程感、需要短暂连续的,第二种更合适;并发量大、要精细控制成本的,第三种最划算。
按资源来源分:IP的"出身"决定了它好不好用
第二条轴更关键,很多"明明用了动态IP还是被拦"的问题都出在这儿。同样是动态IP,来源不同,对方站点看到的东西完全不同。
机房IP,就是部署在数据中心服务器上的地址。特点是快、稳、便宜,响应时间常常在几十毫秒级。缺点是来源特征比较集中,一些风控严格的站点能识别出这类网段,所以更适合对速度敏感、对来源宽松的场景,比如公开资讯抓取、AI 训练语料的批量收集。
住宅IP,来自真实家庭宽带。它的访问特征跟普通用户上网没什么差别,所以在电商价格监控、市场研究这类需要"看起来像普通访问"的任务里,成功率明显高一截。代价是速度比机房慢一些,成本也高。
移动IP,走的是蜂窝基站。同一个基站下大量用户共享出口,所以地址变动本身就频繁,天然带一点"动态"属性。适合移动端页面的采集测试。
运营商正规授权这一类强调的不是技术属性,而是合规属性。地址来源可追溯、有明确授权链路,这一点在项目要过内部合规审查、或者要给客户交付报告的时候特别重要——你得说清楚这些IP是怎么来的。
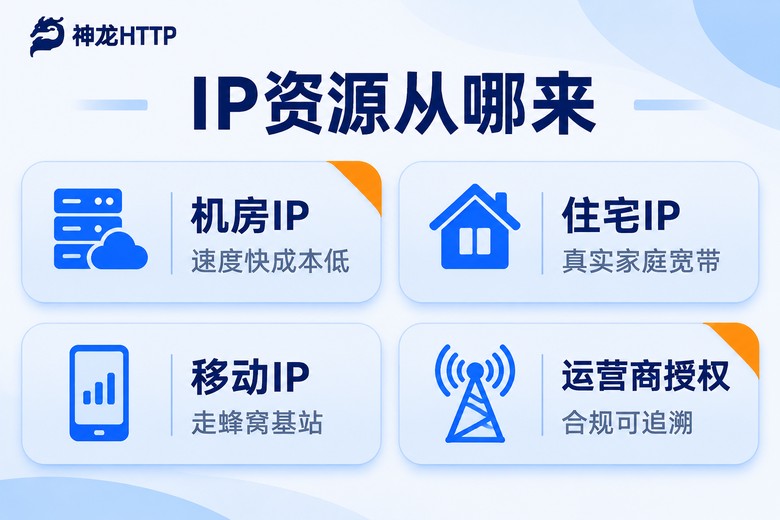
实际项目里很少只用一种。常见的做法是主力用机房IP跑量,遇到成功率掉下来的域名自动切到住宅池,两边各留一部分余量。
一张表:四种常见组合怎么选
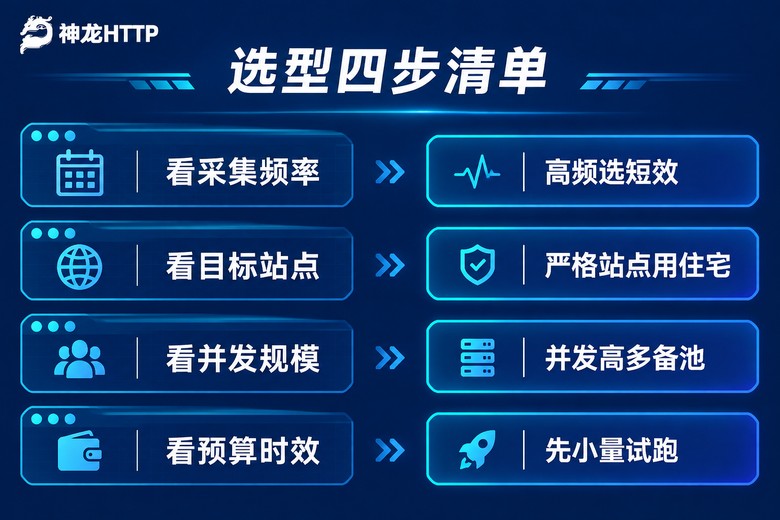
把两条轴合起来,落到具体配置上,大概是这么个对应关系。这张表可以当作选型的起点:
| 轮换方式 + 来源 | 适合的任务 | 要注意的地方 | 并发量级参考 |
|---|---|---|---|
| 每次请求轮换 + 机房IP | 公开页面批量抓取、语料收集 | 会话不连续,别用于需要登录态的任务 | 50~200 并发 |
| 定时轮换 + 机房IP | 列表页翻页、定时价格巡检 | 周期要设成站点频次阈值的 1.5 倍 | 20~100 并发 |
| 定时轮换 + 住宅IP | 电商详情页、市场调研样本 | 单IP别压太多请求,慢一点反而稳 | 10~50 并发 |
| 手动提取 + 混合池 | 大规模采集、需要精细控成本 | 要自己维护池子,做好过期标记 | 100 并发以上 |
表里的并发数字只是参考区间,别当成标准答案。真实项目里先跑 1000 个请求看成功率,再按比例往上加,比照着别人的配置抄要靠谱得多。
动手:把动态IP接进采集脚本
说回具体操作。以手动提取为例,核心就两件事:定时去要新IP,请求时带上它。下面这段代码是我平时用的骨架,改几行就能跑:
import requests, time

API = "你的动态IP提取链接"      # 个人中心里复制那条
TARGET = "目标站点地址"

def fetch_proxy():
    r = requests.get(API, timeout=5)
    r.raise_for_status()
    return "http://" + r.text.strip()

proxies = {"http": fetch_proxy(), "https": fetch_proxy()}

for page in range(1, 201):
    # 每 20 页换一批,模拟定时轮换
    if page % 20 == 1:
        proxies = {"http": fetch_proxy(), "https": fetch_proxy()}
        print("已获取新的IP:", proxies["http"])

    try:
        resp = requests.get(TARGET, params={"page": page},
                            proxies=proxies, timeout=10)
        print(page, resp.status_code, len(resp.text))
    except Exception as e:
        print(page, "失败,重取IP", e)
        proxies = {"http": fetch_proxy(), "https": fetch_proxy()}

    time.sleep(1.5)
几个容易踩的坑,顺手记一下:别把超时设太长,10 秒足够,卡住的请求会拖垮整个队列;失败重试别超过两次,同一个IP连续失败就该换,硬重试只会让情况更糟;给每个IP记一下使用次数,用超过 30 次还没换,成功率通常会开始下滑。
如果你的采集脚本用的是 Node 或者 Go,思路一模一样,把发请求那一层换成对应的 HTTP 客户端、把代理参数写进去就行。接口本身只是返回一段文本,不挑语言。
神龙HTTP在这两条轴上能给到什么
回到选型本身。如果你不想自己拼好几家服务商,神龙HTTP 这两条轴的覆盖是比较齐的:轮换模式上有短效动态IP、长效静态IP、固定IP代理三条产品线,短效那条适合高频次请求轮换或几分钟一换的任务,长效那条适合需要连续会话的场景;资源来源上有 3000万+ 正规授权代理IP储备,国内三大运营商正规授权,300+ 城市级精准定位,想做地域分布的样本采集时可以直接按城市挑。
接入这块对写代码的人比较友好:API 兼容主流爬虫编程语言,文档里带示例代码,复制到项目里改两行就能跑通,支持 HTTP/HTTPS/SOCKS5。跑起来之后,个人中心里的可视化用量统计和实时监控值得常看看——哪个时段消耗陡增、哪些IP段成功率偏低,一眼能看出来,比事后翻日志高效。技术团队 7×24 小时在,遇到协议层面的问题也能问到人。
给个实操建议:先拿最小的量试。挑一个目标域名,用短效动态IP跑 500 次请求,看可用率是不是接近 99.9% 那个水平,再决定要不要铺开。可用率 99.9%、IP 纯度 99.8% 这些数字,自己跑一遍心里才踏实。
常见问题
Q:动态IP代理和静态代理,我该先试哪个?
看你怕不怕被限频。同一来源短时间访问次数多,就先上动态;任务量很小、或者需要长期保持登录状态,静态更省心。不确定的话,先用短效动态IP跑一轮,看成功率曲线什么时候往下掉,掉得快的业务后面基本都得靠动态池。
Q:每次请求换IP,是不是一定比定时换好?
不一定。每次请求换,你拿不到会话连续性,遇到需要带着 cookie 走完整流程的任务会直接断在中间。而对目标站点来说,一秒内从几十个不同地址涌过来,本身就是异常特征。定时轮换在大部分中低并发场景里反而更稳。
Q:住宅IP比机房IP贵,值不值得?
看你被拦在哪一步。如果返回的是明确的频次提示、或者干脆返回空内容,换住宅池通常有改善;如果只是单纯的速度慢,那加预算买住宅IP是浪费。建议先做小规模对照测试:同一批页面,两种来源各跑 200 次,成功率差 10 个点以内就别换。
Q:手动提取的IP池,怎么判断哪些该淘汰?
两个信号最直接:一是连续两次请求失败,二是累计使用次数超过一个阈值(我一般设 30 次)。另外给每批IP记上提取时间,按官方给的存活周期提前 20% 的时间就标记为"待换",别等它自然过期才处理,那时候失败请求已经产生了一堆。
Q:多个项目共用一个动态IP池会不会互相影响?
会。同一个池子里,A 项目的高速请求会把整个出口的使用特征拖累,B 项目跟着受影响。要么按项目拆成不同的提取通道,要么在调度层给每个项目分配独立的IP段配额,别让两条业务线抢同一批地址。