上周有个做选品数据的读者来找我,说买的代理"太慢了",一个页面要转七八秒。我让他先别急着退,把测试数据发我看看。结果他一共就测了三次,而且是拿浏览器点开百度首页目测的——连慢在哪一步都没分清。
这种判断方式很常见,也很吃亏。代理慢,可能是连接建立慢,可能是服务器返回慢,也可能是你要的那个文件太大、管道太细。三种原因对应的处理方式完全不一样,一个是换地区、一个是换产品线、一个是加并发。下面这套测法我自己用了两年多,一台笔记本、两条命令就能跑完,十几分钟出结论。
第一步:先分清你嫌的"慢"是哪一种
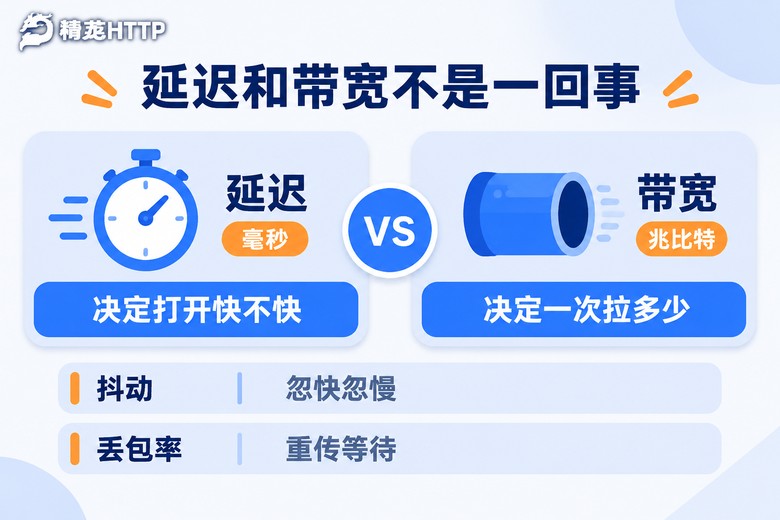
延迟和带宽,是两个方向的事。打个比方,延迟是货车从仓库开到你家门口要多久,带宽是这辆车一趟能装多少货。你打开一个商品详情页,主要花的是延迟的钱——请求发出去、对方回过来,一个来回就结束,数据量可能才几十KB。你要下载一份20MB的行业报表压缩包,那才是带宽说了算。
很多人测速失败,就失败在这一步。拿下载大文件的速度去判断打开网页快不快,或者拿 ping 值去判断能不能跑大文件采集,两边都对不上。
还有一个容易被忽略的指标:抖动。同一个代理连续测十次,延迟在 40ms、45ms、42ms 之间晃,这叫稳;如果在 40ms 和 320ms 之间来回跳,平均值再好看也没用,因为你的程序会时不时卡在那儿等一个超时的响应。
第二步:延迟怎么测,三条命令就够
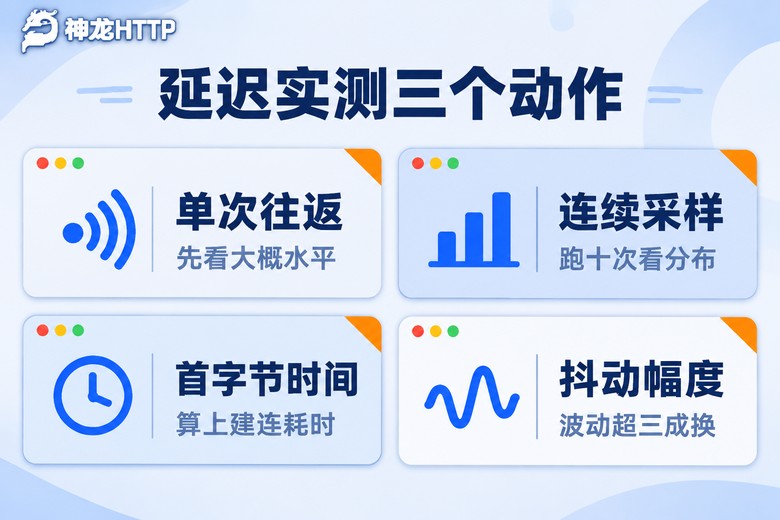
别用浏览器秒表。curl 自带分段计时,走代理也能用,一条命令把连接耗时、首字节耗时、总耗时全打出来:
for i in $(seq 1 10); do
  curl -o /dev/null -s \
    -w "连接 %{time_connect}s 首字节 %{time_starttransfer}s 总计 %{time_total}s\n" \
    -x http://用户名:密码@代理地址:端口 \
    http://example.com/
  sleep 1
done
看三个数就够了。time_connect 是跟代理握手用了多久,这个数大,说明代理入口离你远或者入口本身拥堵;time_starttransfer 是目标站点开始吐数据的时间,减去 time_connect,大致就是代理转发加对方响应的耗时;time_total 是整件事结束。连着跑十次,把十个值抄到一张纸上,看最大最小值差多少。
经验值是这样的:国内节点,首字节时间稳定在 30–80ms 属于正常好用;100–200ms 能接受但采集任务要放宽超时;超过 300ms 或者十次里有三次跳到 500ms 以上,基本可以放弃这一批。
如果你用的是命令行不熟的机器,用 Python 也一样直观:
import time, requests

PROXY = "http://用户名:密码@代理地址:端口"
URL = "http://example.com/"

for _ in range(10):
    t0 = time.time()
    r = requests.get(URL, proxies={"http": PROXY, "https": PROXY}, timeout=15)
    print(f"{r.status_code}  {(time.time()-t0)*1000:.0f} ms")
    time.sleep(1)
这里有个小细节值得注意:一定要 sleep 一秒再测下一次。连着猛打,测出来的可能是你自己把入口打拥堵了,跟代理质量无关。
第三步:带宽怎么测,找一份固定大小的文件掐表
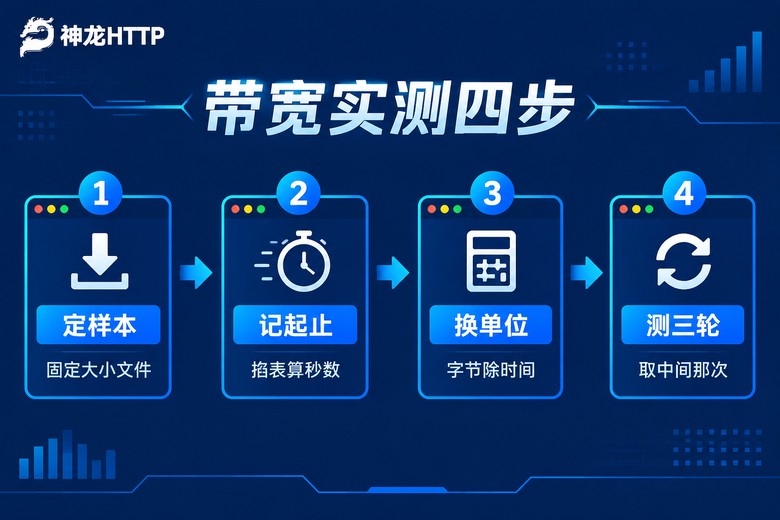
带宽测试最怕的就是"我觉得挺快"。要能量化,就得有固定样本:自己准备一个 5MB 到 20MB 的文件,放在一个你能稳定访问的服务器上,通过代理下载它,记录开始到结束的秒数,然后用文件大小除以耗时。
import time, requests

PROXY = "http://用户名:密码@代理地址:端口"
URL = "http://example.com/testfile.zip"   # 20MB 左右的固定样本

t0 = time.time()
r = requests.get(URL, proxies={"http": PROXY, "https": PROXY}, stream=True, timeout=60)
total = 0
for chunk in r.iter_content(65536):
    total += len(chunk)
sec = time.time() - t0
print(f"大小 {total/1024/1024:.1f} MB  耗时 {sec:.2f}s  速度 {total/sec/1024/1024:.2f} MB/s")
重点在单位换算,很多人算错。1 MB/s 大约等于 8 Mbps,家里宽带说的"200兆"是 Mbps,不是 200MB/s。如果你通过代理跑到 2 MB/s,那是 16 Mbps 左右。这个数字跟你的本地出口带宽、目标站点限速、代理出口带宽三者取最小值,所以别拿它当代理的绝对上限。
还有一个坑:小文件测不出带宽。5MB 以下的文件,握手和慢启动占了大头,测出来的速度会明显偏低。样本建议 10MB 起步,测三轮,取中间那次,扔掉第一次(首次走新链路往往偏慢)和特别离谱的那次。
第四步:把数字摆到一张表里,别凭感觉选
我把这两年记下来的实测数据整理成了下面这张对照表,你可以直接拿去比对你手里的结果:
| 实测项 | 好用的区间 | 勉强可用 | 建议处理 |
|---|---|---|---|
| 首字节时间 | 30–80 ms | 100–200 ms | 超过 300ms 换地区 |
| 十次延迟波动 | 小于 20% | 20%–40% | 超过 50% 视为抖动大 |
| 单线程下载速度 | 1.5 MB/s 以上 | 0.5–1.5 MB/s | 低于 0.3 MB/s 只适合小请求 |
| 并发 10 路平均耗时 | 与单路差距 30% 内 | 差距 30%–80% | 差距一倍以上说明池子紧 |
| 失败重试率 | 低于 1% | 1%–5% | 高于 5% 先排查脚本 |
表格里最后两行是我额外加的,很多教程不写。做公开数据采集的人都知道,单路快不等于多路快,十个并发一起打的时候平均耗时要是翻了一倍,那说明你拿到的是共享程度很高的资源。这个指标比单次 ping 更能反映真实体验。
第五步:这五个坑,八成的"测速不准"都出在这里
一是拿目标站点当测试对象。目标站点自己限速、做风控,你测出来的是它的水平。测代理请用你自己能控制的服务器或者中立的测试页。
二是忽略本地网络。办公室下午三点整层楼都在开会视频,你测什么都慢。开工前先在本地直连测一遍,拿到基线,再对比走代理的差距。
三是DNS 解析耗时没算进去。如果脚本里每次都是新域名,解析时间会被算进总耗时。建议测速阶段直接用 IP 或缓存域名,排除干扰。
四是只测一次就下结论。网络有早高峰晚高峰,同一个IP在上午十点和晚上九点能差一倍。至少分两个时段各测一轮。
五是超时设得太短。requests 默认不设超时,或者有人随手写个 timeout=2,慢一点的链路直接被掐断,你看到的是"失败"而不是"慢"。测速阶段给到 15 秒比较合适。
测完了还是不行?看看资源本身
如果你按上面的方法测完,发现不是脚本问题、不是本地网络问题,而是IP池里换出来的地址普遍延迟高、波动大,那基本就不是调参能救的了,得从资源质量上找原因。
我目前主要用神龙HTTP,原因很实际:它的资源是国内三大运营商正规授权的,3000万+ 代理IP储备,300+ 城市级定位可以选。做区域价格对比这类活儿,能指定到具体城市这一点很关键,不然你测出来的数据里混着不同地区的响应差异,结论就没法看。
另外它的可用率标称 99.9%、IP 纯度 99.8%,这两个数在实测里体现得比较明显——十次采样里很少出现突然失败的情况,抖动也收得比较紧。产品线分短效动态、长效静态和固定IP代理,短效适合轮换抓列表页,固定IP适合需要保持会话的场景,按任务选就行,不用自己拼。API 兼容主流爬虫语言,接进现有脚本基本是改两行配置的事。
还有个小功能我挺常用:个人中心里的可视化用量统计和实时监控。跑批量任务的时候盯着曲线,如果某段时间失败率突然抬头,一眼就知道是该调并发还是该换批IP,不用靠猜。
常见问题
Q:ping 值只有 20ms,但程序跑起来还是慢,为什么?
ping 走的是 ICMP,测的是到代理入口那一段,不包含代理转发和目标站点的响应时间。真正有参考价值的是走代理发一个 HTTP 请求的 time_starttransfer。建议用 curl 的分段计时看完整链路,别只看 ping。
Q:同一个代理,我这边测 60ms,同事那边测 200ms,谁的数据对?
都对。延迟跟你的本地出口线路、所在城市、运营商都有关系。做判断时以实际跑任务的机器为准,在A机器上测出来的好数据,换到B机器上不一定成立。
Q:下载速度只有 300KB/s,是不是这个代理不能用?
要看你干什么。如果只是抓网页文本、调接口拿 JSON,300KB/s 完全够用,延迟稳才是关键。如果要拉图片、PDF、视频封面这类大文件,建议换固定IP代理或者提高并发数,单线程速度不是唯一解法。
Q:测多少轮才算数?
延迟至少十次,取最大值、最小值和中位数三个数一起看;带宽三轮取中间那次。时间上早晚各测一轮,一轮十几分钟,成本不高,但能避掉大部分"买回来才发现不行"的麻烦。
Q:并发测试怎么做比较靠谱?
先用 1 路跑十次记下平均耗时,再开 10 路并发跑同一批请求,对比平均耗时和失败率。差距在 30% 以内说明资源够用,翻倍就说明这个池子在你用的这个时段比较紧张,换个时段或者换个产品线再试试。