先把"在线时间"这两个字拆开看
很多人问代理IP能用多久,脑子里其实混着两件事。一件是单个IP的存活时长——从你把它提取出来那一刻开始计时,过了有效期它就不归你了,再拿这个地址去请求,大概率直接超时或者被拒绝。另一件是你这条任务能连续跑多久——只要池子里还有货,你能一直不停地获取新的IP,理论上可以跑几天几夜。
这两件事经常被搞混,然后就出现那种对话:"我这个IP怎么用两分钟就挂了?是不是质量不行?"——不是,是你买的就是短效的那一档。所以看时长之前,先想清楚你要的是"一个IP能用很久",还是"一直有IP能用",这两个答案完全不同。
短效动态IP:以分钟计的档位,用对了才不亏
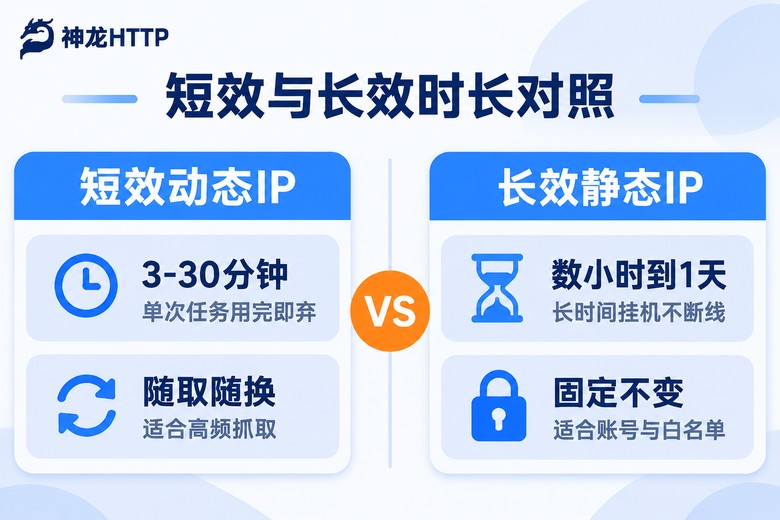
短效这一类,行业里常见的档位从几十秒到半小时不等,最主流的集中在3分钟、5分钟、30分钟这几个规格上。它的逻辑很简单:一次提取给你一个IP,倒计时走完,这个IP从你的可用列表里划掉,下次提取给的是另一个。
听起来很短,但对绝大多数公开数据采集来说完全够。算个账:你抓一个商品详情页,服务器正常响应一百多毫秒,算上重试和间隔,一分钟能请求几十次。3分钟的IP窗口,够你在这一个地址上跑完一个小的抓取单元,然后换个新的接着来。真正吃时长的是那种"必须保持同一个身份连续对话"的场景,比如登录后要连续翻几十页、要把表单一步步提交完,这种才需要更长的窗口。
用短效最常见的两个坑,一个是把有效期当成"保证能用满",实际上任何一个IP都可能在窗口内提前失效,这是概率问题;另一个是拿到IP后不做任何标注,跑了一半报错了才发现已经过期十几秒。所以短效的用法应该是:拿到就记开始时间,到有效期的八成左右主动换掉,别掐着最后一秒。
长效静态IP和固定IP:按小时到按周,图的是稳定
长效静态这一档,单个IP的在线时间通常从几个小时到一整天,规矩是有效期内反复用同一个地址,不用每次重新提取。固定IP更进一步,按周甚至按月绑定不变,长期就是那一串数字。
这类时长的价值不在"数量"而在"连续性"。你想想这些场景:一个后台接口需要先把IP加进白名单才能调,那IP一变你就得重新加,固定IP能免掉这个折腾;再比如某个数据源会在会话里给你一个临时令牌,令牌和请求来源IP是绑定的,中途换了地址令牌就作废——这种时候你的任务时长完全取决于IP能撑多久。
代价也明摆着:固定IP单价高,数量有限,而且它不像动态池那样"取之不尽"。所以别什么活都用固定IP,几个页面抓一下就用掉一个固定IP,成本上很不划算。
一张表看清:短效与长效时长对照
把上面这些整理成一张表,看的时候重点不是记数字,而是看"到期之后会发生什么"这一列。
| 类型 | 单个IP在线时长 | 到期后 | 典型适用 | 成本感受 |
|---|---|---|---|---|
| 短效动态IP | 几十秒 ~ 30分钟 | 自动失效,重新提取换新地址 | 公开数据采集、页面抓取、多任务并行 | 低 |
| 长效静态IP | 数小时 ~ 1天 | 到期前可复用,到期后需重新获取 | 需保持会话的采集、长时间挂机轮询 | 中 |
| 固定IP代理 | 按周 / 按月长期不变 | 有效期内在同一地址上继续用 | 白名单对接、接口联调、AI训练数据拉取 | 高 |
补一句容易被忽略的:表格里的时长是"设计值",不是"承诺值"。真实环境里IP可能因为对方站点封禁、线路抖动、上游资源回收等原因提前结束,所以你的程序里永远要留一条"失败就换IP重来"的路,别把逻辑写死在"这个IP一定能用满3分钟"上。
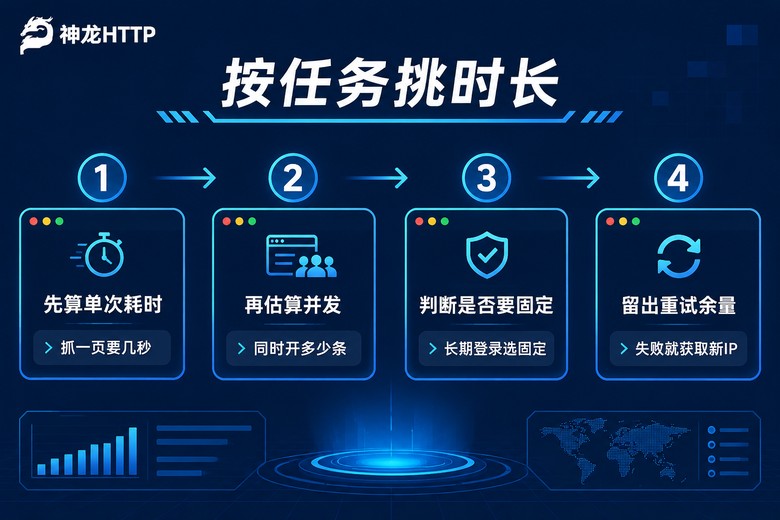
选时长别拍脑袋,按这四步走
接到一个任务,先别急着下单,花两分钟回答四个问题,时长大致就定了。
第一步,算单次任务要多久。你要抓的是一个详情页还是一整条分页列表?前者秒级,后者可能要几十秒到几分钟。单次耗时越接近甚至超过IP窗口,越要考虑长效那一档。
第二步,估并发规模。如果同时要跑几十上百条请求,短效动态池反而是更合适的选择——量大、便宜,一条失效了立刻用另一条补上,整体不掉速。反之如果是少量长任务,长效更省心。
第三步,判断是不是必须保持同一身份。需要登录态、需要令牌绑定、需要IP在对方白名单里,这三条中任意一条成立,就得上长效静态或固定IP。这一条是硬约束,成本再高也得认。
第四步,给重试留位置。不管选哪一档,代码里都要有一段"这个IP不行了,去获取新的IP再试一次"的处理。这一步写好了,选短效还是长效的差距会被拉平很多。
代码里怎么管住IP的"保质期"
光知道时长没用,得让它落到代码里。下面这段是一个很朴素的写法:按有效期给IP设一个本地倒计时,跑到八成时间就主动作废,遇到异常也立刻作废,下一轮请求自动获取新的IP。
import time
import requests

API_URL = "https://你的提取接口地址"   # 换成控制台里的接口链接

def fetch_ips(num=20):
    """一次提取一批短效IP,返回 ['ip:port', ...]"""
    resp = requests.get(API_URL, params={"num": num, "format": "txt"}, timeout=10)
    resp.raise_for_status()
    return [line.strip() for line in resp.text.splitlines() if line.strip()]

def crawl(urls, ip_ttl=180):
    pool = fetch_ips()
    proxies = None
    born_at = 0

    for url in urls:
        # 用满八成就换,别等它自己到期
        if proxies is None or time.time() - born_at > ip_ttl * 0.8:
            if not pool:
                pool = fetch_ips()          # 池子空了再获取一批
            ip = pool.pop()
            proxies = {"http": f"http://{ip}", "https": f"http://{ip}"}
            born_at = time.time()
            print(f"当前IP: {ip}")

        try:
            r = requests.get(url, proxies=proxies, timeout=8,
                             headers={"User-Agent": "Mozilla/5.0"})
            print(r.status_code, len(r.text))
        except requests.RequestException as e:
            print("这个IP不行了:", e)
            proxies = None                  # 作废,下一轮自动换
        time.sleep(0.5)

if __name__ == "__main__":
    urls = [f"https://example.com/list?page={i}" for i in range(1, 60)]
    crawl(urls)
几个实操上的细节:ip_ttl 这个值要按你实际拿到的规格填,3分钟档填180,5分钟档填300,别直接抄;timeout 别设太长,8秒足够了,拖得越久越容易误判;如果目标站点需要保持会话,把 requests.get 换成 requests.Session(),这样Cookie能跟着走,但你换IP的时候记得把Session一起重置,不然旧Cookie配新地址,反而更容易被拦。
还有个小检查很有用:拿一个已知能通的目标地址做探活,每次提取完先请求一次,200就留着用,超时就丢掉换下一个。这一步多花两百毫秒,能省掉后面一堆莫名其妙的失败。
想让时长"可预期",工具得跟得上
说到底,"在线时间多长"这件事,一半取决于你选的类型,另一半取决于你手上这套服务稳不稳。同样是3分钟档,有的池子跑着跑着大批IP提前失效,有的池子基本能跑满,你的重试成本差出好几倍。
神龙HTTP 在这块比较让人放心的地方有两个。一个是资源底座:3000万+正规授权代理IP储备,国内三大运营商正规授权,可用率99.9%、IP纯度99.8%,300+城市级精准定位,短效动态、长效静态、固定IP三条产品线都齐,你想按分钟用还是按天用,不用换服务商来回折腾。另一个是个人中心里的可视化用量统计和实时监控,能看趋势、能识别异常——哪天某个批次提前失效的比例突然高了,你从曲线上就能看出来,而不是等程序报了一堆错才去猜。
接入这块也不复杂,API兼容主流爬虫编程语言,文档和示例代码都给好了,把上面那段示例里的接口地址一换基本就能跑。跑不通的时候技术团队7×24小时在线,这个对赶进度的人来说挺重要。
常见问题
Q:标称3分钟的短效IP,实际用一分多钟就失效了,正常吗?
属于正常波动范围。可用率99.9%说的是整体水平,不等于每一个IP都能跑满窗口,上游资源回收、目标站点封禁、线路抖动都会让某个IP提前结束。做法上别死等,按有效期的八成主动更换,再配一条异常即作废的逻辑,整体成功率就上来了。
Q:长效静态IP是不是等于永久在线?
不是。它指的是在有效期内反复用同一个地址,常见是数小时到一天,固定IP那档能到按周按月,但都有明确的到期时间,到期一样要重新获取或续期。把它理解成"长期租用同一个门牌号"更准确,房子还是房东的。
Q:一个IP在它的在线时间里,请求发得越多越划算吗?
不建议这么算。请求密度太高,对方站点照样会拦你,那时候IP没到期也等于废了,而且容易把整段线路拖进黑名单。合理节奏是给每个IP配一个请求上限,跑满就歇着,让它自然到期或者直接作废,比压榨到最后一秒更省事。
Q:报错了,怎么判断是IP到期还是被目标站点限流?
看现象。IP到期通常是连接超时、代理握手失败这类"根本连不上"的错误;被限流一般是能连上但返回403、429,或者给你一个验证页面。前者去获取新的IP就好,后者要降频率、换请求头、拉长间隔,光换IP解决不了。手上如果有多个IP,也可以拿同一个地址轮着试两次,两次都这样,基本就是站点侧的问题。