先分清:被拦的是IP,还是你的请求
做采集的人几乎都有一个条件反射:一看到验证码、403、429,第一反应就是去获取新的IP。换完之后确实能安静一阵子,可过不了多久又被拦。这种情况八成不是IP不够干净,而是你的请求放在一起,根本不像人点出来的。
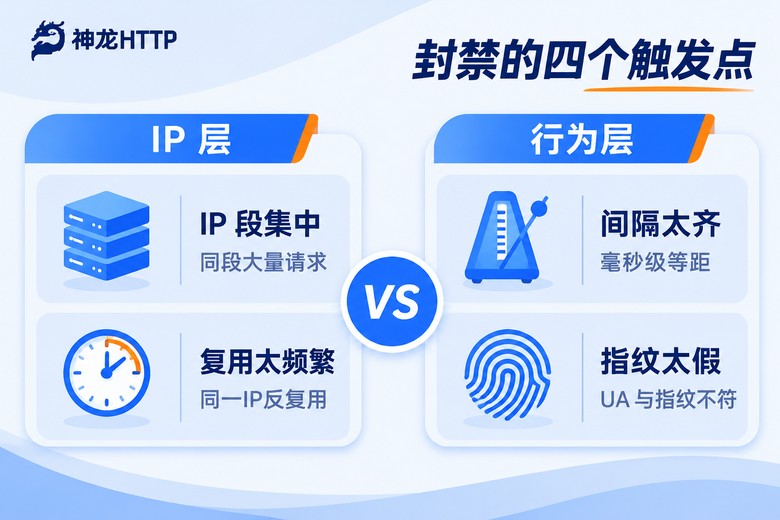
站点那边判断请求像不像真人,通常看这几样东西:
时间分布——间隔均匀到毫秒,人手点不出这种节奏。
访问路径——永远从列表直插详情,从不看首页,从不回退。
指纹一致性——UA 写着最新版浏览器,JS 指纹却是几年前的特征。
IP 使用密度——同一个IP在 24 小时里被好几个任务轮着用。
这四条里踩中两条,很多站点就开始弹验证码了;踩中三条,被封只是时间问题。所以排查顺序应该是:先看节奏和指纹,再看IP池。
风控规则升级后,判定维度变了三个地方
早几年的风控基本靠计数,一分钟超过多少次就拦,思路很直白。现在的做法是动态打分,同一个阈值对不同IP、不同时段、不同访问深度都不一样。下面这张表是这两年最明显的变化:
| 检测维度 | 以前的判法 | 现在的判法 |
|---|---|---|
| 请求频率 | 固定阈值,一分钟不超 N 次 | 按时段、页面类型、IP 历史动态计算 |
| 浏览器与设备 | 只核对 UA 字符串 | UA + JS 指纹 + TLS 指纹 + 分辨率一起比对 |
| 访问路径 | 基本不看 | 看顺序、停留时长、有没有回退动作 |
| IP 质量 | 简单黑名单 | 看网段集中度,以及这个IP最近被多少人用过 |
| 处罚方式 | 直接封 | 先验证码、再限速、最后才封 |
最后一条最容易被忽略。验证码不是终点,是警告。验证码命中率开始往上抬,说明你已经被盯上了,这时候还按原来的节奏猛跑,封禁就是几步之后的事。很多人就是在这个阶段输掉的:明明已经出现信号,却把它当成随机波动。
监控告警怎么搭:盯住四个数就够了
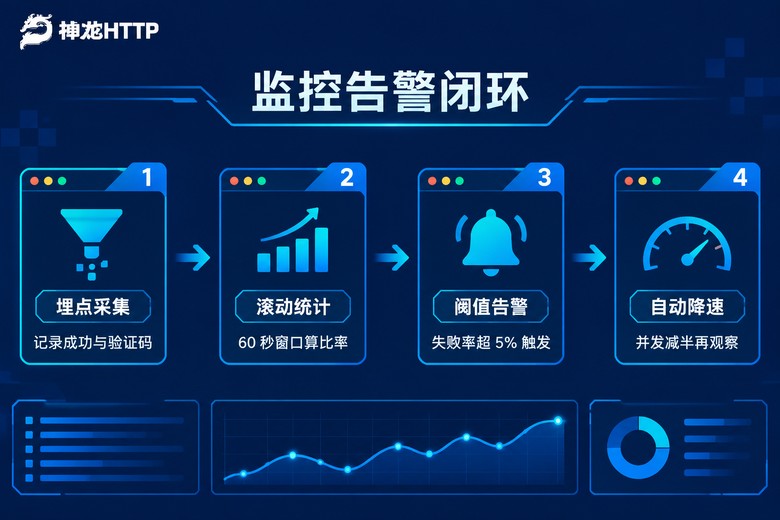
不用一上来就上很重的监控系统。在采集脚本里加一个滚动窗口,把每次请求的结果记下来,每 60 秒算一遍这四个数:
成功率——低于 95% 就该看一眼日志。
验证码命中率——超过 3% 立刻降速。
慢请求占比——耗时超过 3 秒的比例往上走,先查出口带宽。
单IP请求数——一个IP一分钟打出去多少次,心里必须有数。
下面这段代码可以直接塞进现有脚本,跑在采集线程旁边,几十行就够:
from collections import deque
import time

WINDOW = 60
FAIL_LINE = 0.05      # 失败率 5%
CAPTCHA_LINE = 0.03   # 验证码 3%
SLOW_LINE = 0.20      # 慢请求 20%

rows = deque(maxlen=1200)

def report(ip, ok, captcha, cost_ms):
    rows.append({"t": time.time(), "ip": ip, "ok": ok,
                 "captcha": captcha, "cost": cost_ms})

def check():
    now = time.time()
    win = [r for r in rows if now - r["t"] <= WINDOW]
    if len(win) < 20:
        return
    n = len(win)
    fail = sum(1 for r in win if not r["ok"]) / n
    cap = sum(1 for r in win if r["captcha"]) / n
    slow = sum(1 for r in win if r["cost"] > 3000) / n

    if fail > FAIL_LINE or cap > CAPTCHA_LINE:
        print(f"[告警] 失败 {fail:.1%} 验证码 {cap:.1%},建议并发减半")
    if slow > SLOW_LINE:
        print(f"[告警] 慢请求 {slow:.1%},先查带宽再查IP池")
告警推到值班群里就行,别搞太复杂。关键是每条告警都要能直接对应一个动作——“并发减半”“暂停十分钟”“把新IP低速探一遍”,而不是只告诉你“出问题了”。只报现象不给动作的告警,用三天就没人看了。
节奏调整:把“快”换成“稳”
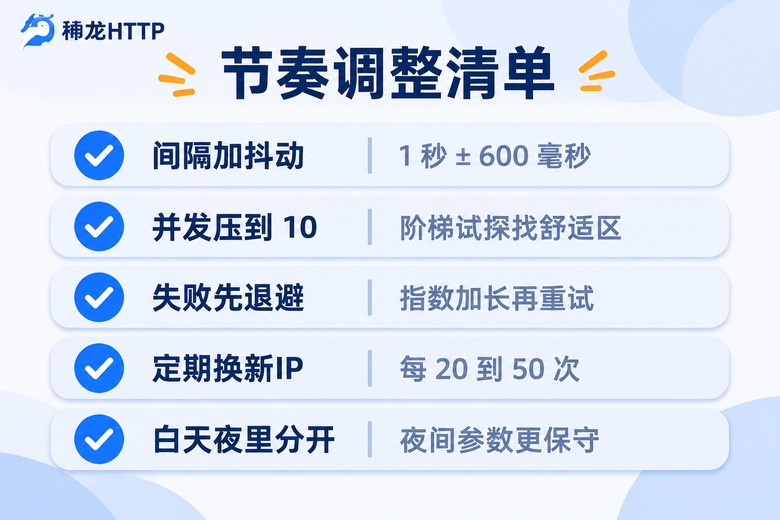
风控升级之后,砸并发这条路基本走不通。真正省时间的做法是把节奏做得不规则一点。几个一直在用的参数:
基础间隔 1 秒,上下浮动 600 毫秒。固定间隔是最明显的机器特征,加上随机抖动之后,光看时间分布已经和人很接近了。
并发先从 10 开始试。不要一上来就 40,从 10 起每半小时加 5,加到验证码冒头就退回去,那个值就是这个站点的舒适区。
失败立刻退避。碰到 403、429 不要马上重试,按指数加长等待,第一次 2 秒,第二次 4 秒,最多到 30 秒。
每 20 到 50 个请求获取新的IP。让单个IP的请求量保持低位,比事后去补救便宜得多。
import random, time

def pace(ok, level, base=1.0, jitter=0.6):
    if ok:
        time.sleep(base + random.uniform(0, jitter))
        return max(level - 1, 0)
    wait = min(2 ** level, 30) + random.uniform(0, 1.0)
    print(f"第 {level + 1} 次重试,等待 {wait:.1f} 秒")
    time.sleep(wait)
    return min(level + 1, 5)
还有一个特别容易被漏掉的点:白天和晚上应该用两套参数。不少站点晚上的风控更紧,同一套节奏白天跑得好好的,晚上就出事。把时段写进配置,比事后一条条翻日志省心太多。
什么时候该获取新的IP,怎么换才不浪费
不是所有异常都要换IP。我的判断顺序是:先看验证码命中率,再看单IP请求数,最后才看IP本身。如果命中率是被节奏拖上去的,你换多少IP都会被一起带走——新的IP刚上场就满速跑,往往十分钟内就废掉。
真正需要获取新的IP的信号有两个:一是同一个IP在很短时间内连续失败,已经不是节奏能解释的问题;二是任务本身要求地域分布,比如做市场研究时要看不同城市的价格展示和推荐差异。
这种场景我更倾向用现成的服务。神龙HTTP 的短效动态IP池有 3000万+ 正规授权资源,国内三大运营商直接授权,可用率标到 99.9%,而且是城市级定位,300 多个城市可选——需要换个地区的IP时,指定城市提取就行,不用自己攒一堆代理源。接口支持 HTTP/HTTPS/SOCKS5,API 兼容主流编程语言,文档里带示例代码,接到现有脚本里基本是改几行的事。
另一个我觉得实用的地方是个人中心的可视化用量统计与实时监控:哪些IP在拖后腿、失败率什么时候抬头,看一眼就知道。配合前面那套滚动窗口告警,能很快分清到底是IP的问题还是节奏的问题。技术团队是 7×24 小时在线,遇到看不懂的返回码也可以直接问。
换IP的时候记住两件事:新IP不要立刻满速跑,先用低并发探一下这段的质量;同一批任务尽量绑定同一组IP,别一次请求换一个,那样反而更像机器。
常见问题
Q:为什么换了IP还是被拦?
大概率是请求特征没变。UA、Header 顺序、TLS 指纹、访问路径这些只要有一处明显不对,换多少IP结果都一样。先把节奏和指纹理顺,再考虑IP池的问题。
Q:验证码多到什么程度该停下来?
超过 3% 就值得警惕,超过 10% 建议直接停任务重来。硬跑只会让风控把这个网段的权重压低,后面正常请求也会被连带。
Q:并发到底开多少合适?
没有通用答案。目标站点越小、风控越新,能承受的并发越低。用阶梯试探的办法:从 10 开始,稳定半小时加 5,验证码一抬头就退回去,记住这个值写进配置。
Q:固定间隔加随机抖动真的有用吗?
有用,而且改起来最省事。均匀到毫秒的间隔在日志里一眼就看得出来,加上 300 到 600 毫秒的浮动,时间分布就接近真人了,建议第一个动手改这个。