爬虫跑到第 4000 条全是 403,问题多半不在代码里
这个画面基本每个做采集的人都见过:本地测试跑 50 条全绿,正式上量到四千条左右,返回码开始变 403、429,接着连接超时,日志一片红。逐行检查 parse 函数没毛病,headers 也带了,cookie 也维持着——那问题就落在"同一个出口 IP 扛了太多请求"这一件事上。
Scrapy 的代理设置不是加一行配置就完事的。它至少牵涉三处:中间件在哪一层动手、失败之后怎么把请求重新抛出去、以及请求调度时怎么安排 IP 的轮换节奏。下面按实际改代码的顺序来拆。
代理到底插在哪一层:找到 process_request 这个口子
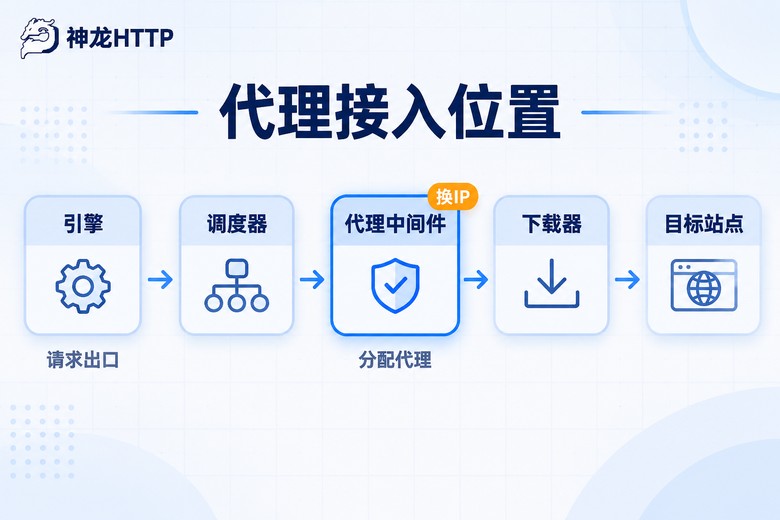
Scrapy 的请求出去要过一条链路:引擎把请求交给调度器排队,调度器再发给下载器真正发出去,而下载器中间件(Downloader Middleware)就卡在下载器的进出口上。代理就该在这一层挂,因为它能在请求真正发出之前改写 request 对象。
别去 pipeline 里折腾代理,pipeline 拿到的是已经抓回来的 item,那时候请求早发出去了。
先建一个中间件文件,比如 myproject/middlewares.py,写一个最小可用的类:
import random
from myproject.proxy_pool import get_one   # 自己封装的取IP函数

class ProxyMiddleware:

    def process_request(self, request, spider):
        proxy = get_one()
        # 把IP挂到 request.meta 上,Scrapy 会自动用它发请求
        request.meta['proxy'] = f'http://{proxy}'
        # 顺手记一笔,后面失败时要知道是哪个IP出的问题
        request.meta['proxy_source'] = proxy
然后到 settings.py 里登记,数字是执行顺序,543 这个位置在默认的 UserAgent 中间件之后、Retry 中间件之前,比较合适:
DOWNLOADER_MIDDLEWARES = {
    'myproject.middlewares.ProxyMiddleware': 543,
}

# 代理本身要带认证信息时,用下面这种写法
# request.meta['proxy'] = 'http://用户名:密码@ip:端口'
跑一次 scrapy crawl 你的爬虫名,如果终端里出现 ProxyMiddleware 相关的日志,说明中间件已经生效了。这里有个小提醒:proxy 给的地址必须带协议头,http:// 漏掉是最常见的报错原因。
光挂上代理还不够,得让它"失败了会自己换"
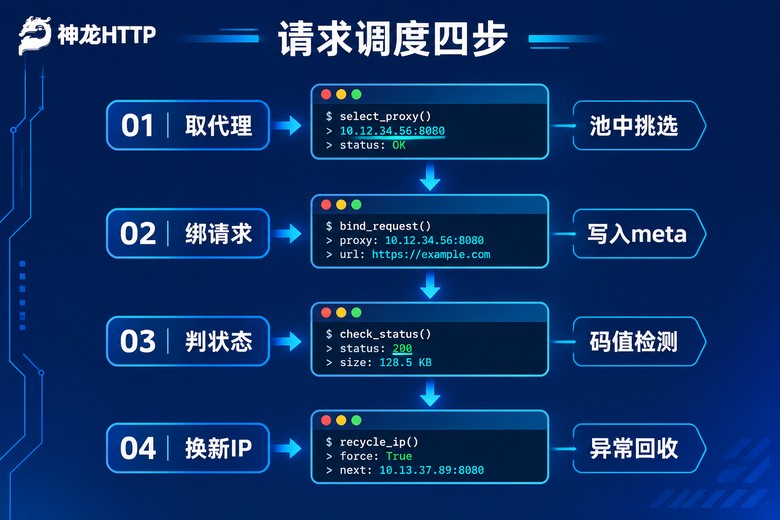
只写 process_request 只能算开了个头。IP 是会失效的,尤其是短效类型,几分钟就换一批。你得让中间件自己能察觉异常并重新派发请求,不然 Scrapy 默认的重试仍然会打在同一批已经废掉的 IP 上。
两个钩子要补上:process_response 看返回码,process_exception 看异常。命中问题就把原请求复制一份,换一个新 IP 再丢回去。
    def process_response(self, request, response, spider):
        if response.status in (403, 429, 503):
            mark_bad(request.meta.get('proxy_source'))   # 把这个IP标记为不可用

            retry = request.copy()
            retry.dont_filter = True        # 关键:别被去重规则挡回来
            retry.meta['proxy'] = f'http://{get_one()}'
            return retry

        return response

    def process_exception(self, request, exception, spider):
        mark_bad(request.meta.get('proxy_source'))

        retry = request.copy()
        retry.dont_filter = True
        retry.meta['proxy'] = f'http://{get_one()}'
        return retry
dont_filter = True 这一行千万别省。少了它,复制出来的请求会被调度器的去重规则直接丢掉,你会看到日志里请求数一直涨、但一条数据也没回来,排查起来非常费时间。
另外建议在 meta 里塞一个重试计数器,超过三次就放弃并记日志。无限换 IP 只会把无效请求堆满,反而拖慢整体速度。
请求调度:并发、延迟和取 IP 的节奏怎么配
中间件写好了,接下来是调度层的节奏问题。很多人配完代理发现速度还不如以前,基本是把并发开太满,几十个请求同时从一个 IP 出去,几秒钟就被目标站盯上。
三组参数值得动一动:
CONCURRENT_REQUESTS先压到 16 左右试水,跑稳了再往上加,别一上来就 100。DOWNLOAD_DELAY给 0.5 到 1 秒,配上RANDOMIZE_DOWNLOAD_DELAY = True,让间隔有波动,比固定频率自然得多。AUTOTHROTTLE_ENABLED = True打开,让 Scrapy 根据目标站的响应速度自己收放,比手调省心。
取 IP 的策略也要跟业务对上。需要广覆盖的场景,比如不同地区的公开数据采集,可以在取 IP 时带上城市参数,让每次拿到的出口落在不同城市;需要会话连续的场景,比如要连续翻十几页才凑齐一条完整记录,就得在同一个域名下复用同一个 IP,别每页都换——换个 IP 等于换了身份,之前的上下文全丢。
一个实用的做法是在中间件里按域名分组记账:同一个域名首次请求时取一个 IP 存进字典,后续同域请求优先复用,失败或超时再重新取。这样既保住了会话,又不会把某个 IP 用到报废。
选哪种 IP:短效动态、长效静态还是固定 IP
配置逻辑写完之后,剩下的变量其实是 IP 本身的质量。市面上代理按存活周期大致分三档,选错档位,代码写得再漂亮效果也上不去。
| 类型 | 存活周期 | 适合的活 | 调度要点 |
|---|---|---|---|
| 短效动态 IP | 几分钟到几十分钟 | 大规模公开数据采集、列表页抓取 | 每次请求都取新 IP,配好失败重试 |
| 长效静态 IP | 数小时到数天 | 需要维持会话的连续抓取 | 按域名或任务绑定,减少更换频率 |
| 固定 IP 代理 | 长期不变 | 接口对接、稳定的定时任务 | 提前加白名单,并发控制要更保守 |
神龙HTTP 在这块提供的是短效动态 IP、长效静态 IP 和固定 IP 代理三条产品线,3000 万+ 正规授权代理 IP 储备,可用率 99.9%,IP 纯度 99.8%,支持 300+ 城市级精准定位,接口兼容主流爬虫编程语言的调用方式,拿到的 IP 直接能填进上面那个 get_one() 里。如果你的采集任务需要按地区分散出口,城市级定位这个能力可以直接用在取 IP 的参数上,不用自己再维护地区表。
调试阶段还有个细节值得用上:个人中心里有可视化的用量统计和实时监控,能看出哪些 IP 频繁失败、请求集中在哪个时段。写完中间件先跑半天,回头看一眼异常率,比盲目调并发有效得多。技术团队 7×24 小时在线,遇到接入问题直接问比自己在日志里猜快。
常见问题
Q:中间件加上去了,但日志里显示请求还是走的本机 IP,怎么回事?
先看 DOWNLOADER_MIDDLEWARES 里的路径写对没有,模块名、类名有一个字母错就会静默失效。其次检查 process_request 有没有返回值——如果返回了 None 之外的 Response 对象,请求会被直接短路,后面的下载器根本不会执行。
Q:换了 IP 之后大量请求返回 407 或 502,是代码问题吗?
407 基本是认证信息没带上,检查 request.meta['proxy'] 里是不是写了账号密码、有没有做 URL 编码。502 通常是代理端连接目标站失败,属于 IP 侧的临时问题,在 process_response 里把它当失败处理、重新取一个就好。
Q:并发开多大比较合适?
没有标准答案,跟目标站和 IP 池规模都有关。经验做法是从 16 起步,观察半小时的成功率曲线,稳定在 95% 以上再往上加一档,每次加完等十分钟看效果。盲目拉到几百,往往成功率掉得比速度快。
Q:同一个爬虫里,能不能让部分请求走代理、部分直连?
可以。在 process_request 里判断一下 request.meta 中的自定义标记,命中标记的才挂代理,其余直接 return None 放行。适合那种只有少数几个栏目需要换 IP、其余抓自己内部页面不必绕路的场景,能省下不少 IP 消耗。