买代理IP这件事,第一次踩坑的人几乎都踩在同一个地方:页面写着"长期有效",结果拿到的IP第二天就连不上了。或者反过来说,IP确实一直在,但每次请求要等上七八秒,比不用代理还慢。
所以"长期有效的代理ip"这个说法本身是有歧义的。它可能指这个IP能活很久,也可能指这份服务能一直续下去、不用你操心。这两件事的评估方法完全不一样。这篇文章就把它们拆开,按存活周期、连通率、续费机制三个维度讲清楚怎么判断,看完你自己就能搭一套评估流程。
一、存活周期:别只看宣传页那个数字
很多人评估存活周期的方式特别简单——拿到IP,记下时间,等它掉线。这种方法只能拿到一个"最长能活多久"的数据,参考价值很低,因为你要的其实是"在我需要它工作的时候,它有多大比例是好的"。
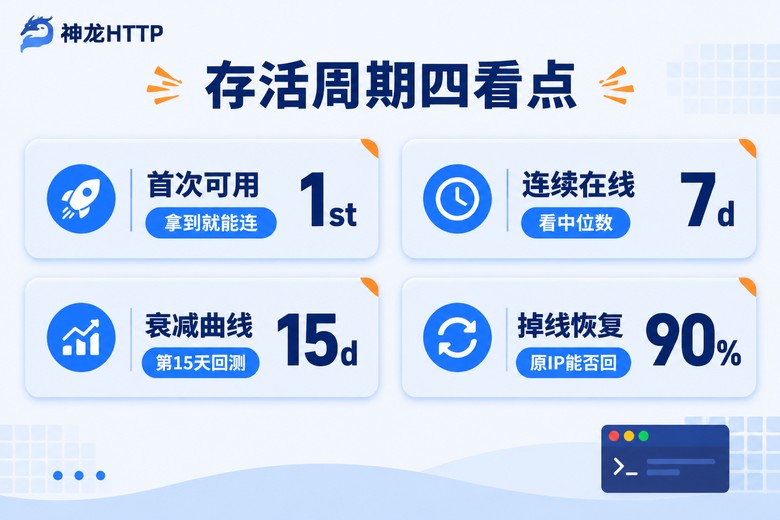
更靠谱的做法是记四个点:
1. 首次可用时间。从提取到第一次成功连接花了多久。有的IP池提取是秒回的,但里面混着还没激活的节点,你要重试三四次才碰上一个好的。这个"首次命中率"直接决定你的程序要写多少重试逻辑。
2. 连续在线时长(看中位数,不看最大值)。拿20个IP跑一周,把每个IP的在线时长排序,取中位数。你会发现很多服务商的平均值被少数几个超长寿的IP拉高了,中位数才是你日常能期待的水平。我的经验是,标称"长效"的IP,中位数如果能稳定在5天以上,就已经算靠谱了。
3. 衰减曲线。把第1天、第3天、第7天、第15天的成功率分别记一遍,画出来是一条缓降还是断崖。缓降的IP池通常管理比较规范,节点有健康检查;断崖式的往往是IP被目标站点批量拉黑了。
4. 掉线后可恢复性。这个最容易被忽略。同一个IP掉线之后,隔两小时再看,它能不能重新连上?能回来的,说明是网络抖动;回不来的,说明这个IP已经废了,你的重试逻辑得把它彻底剔除,不能死等。
二、连通率怎么测,才不是自欺欺人
连通率是各家最爱宣传的数字,99%、99.9% 到处都能看到。但你自己的测试结果往往差很多,原因通常不在数字本身造假,而在口径不一样。
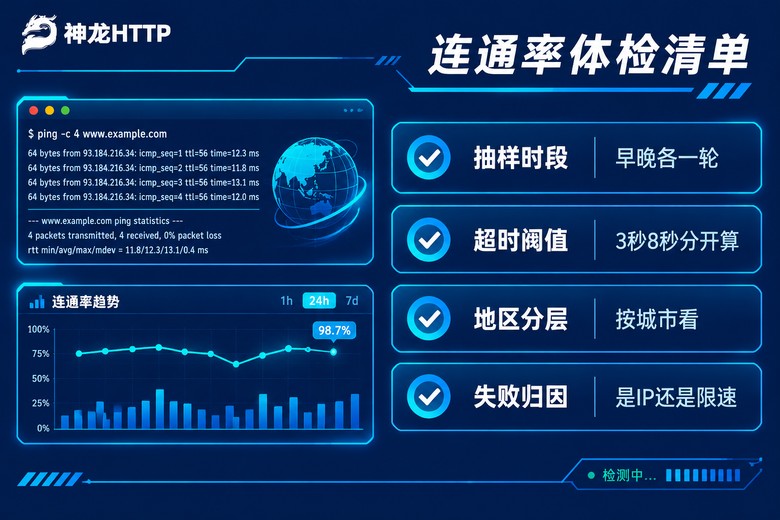
先说超时阈值。设3秒超时和设8秒超时,测出来的连通率能差十几个百分点。要在报告里对齐,就必须写清楚"3秒内响应视为通"。你自己测的时候,建议两档都记:3秒档用来看体验,8秒档用来看IP到底活没活。
再说抽样时段。上班时间测着很稳的池子,到了晚上八九点可能就挤成一团。原因是很多IP资源是共享的,晚高峰使用密度上来,响应就慢。所以至少要在上午9-11点和晚上20-23点各抽一轮,两轮的数字摆在一起看,才知道这个服务是不是真扛得住并发。
还有地区分层。你测全国平均值95%,很可能上海是99%,而某个二三线城市只有70%。如果你的业务需要按城市定位取数据,这个分层数据比总平均值重要得多。
最后一步是失败归因,很多人直接跳过了。请求失败了,到底是IP连不上,还是IP连上了但目标站点给你返回了验证页?这两种情况的处理方式完全不同:前者要换IP,后者要放慢频率、加随机间隔。不区分的话,你会误判一整批本来还能用的IP。
下面这段脚本就是按这个思路写的,跑一轮就能把四类结果分开统计:
import time, statistics, requests

PROXIES = [
    "http://用户名:密码@节点地址:端口",
    # 自己填20个左右,样本太小没有意义
]

CHECK_URL = "https://你的检测接口"
TARGET_URL = "https://你要采集的页面"

def probe(proxy, url, timeout):
    t0 = time.time()
    try:
        r = requests.get(url, proxies={"http": proxy, "https": proxy},
                         timeout=timeout, headers={"User-Agent": "Mozilla/5.0"})
        cost = round((time.time() - t0) * 1000)
        return ("ok" if r.status_code == 200 else "blocked", cost)
    except requests.exceptions.Timeout:
        return ("timeout", None)
    except Exception:
        return ("dead", None)

def run_round(timeout=3):
    result = {"ok": 0, "blocked": 0, "timeout": 0, "dead": 0}
    costs = []
    for p in PROXIES:
        state, cost = probe(p, TARGET_URL, timeout)
        result[state] += 1
        if cost:
            costs.append(cost)
    total = len(PROXIES)
    print(f"超时阈值 {timeout}s | 成功 {result['ok']}/{total} "
          f"| 被拦 {result['blocked']} | 超时 {result['timeout']} | 不通 {result['dead']}")
    if costs:
        print(f"P50 {statistics.median(costs)}ms  P90 {sorted(costs)[int(len(costs)*0.9)-1]}ms")

for t in (3, 8):
    run_round(t)
把这段跑几天,每天早中晚各一轮,数据存成表,存活周期和连通率两个维度就都有实测依据了。别小看这个动作,很多人买完代理就直接上业务,出了问题才发现根本不知道是代理的问题还是自己代码的问题,来回扯皮。
三、续费机制:便宜三个月,贵在第四个月
前面两个维度测的是"东西好不好",续费机制这条测的是"长期用下划不划算"。这里的坑很隐蔽,因为它不在产品页上,而在你用了两个月之后才慢慢浮出来。
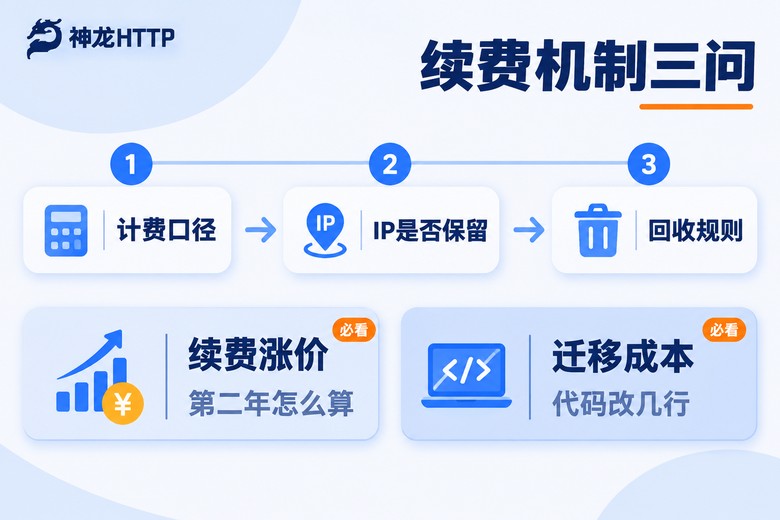
第一个要问清楚的是计费口径。是按IP数量计费、按天按月计费,还是按流量或提取次数计费?这几种口径适合的用法完全不同。跑持续任务的,按月按IP最直观;抓取量波动很大的,按量更省。评估的时候别只算一个月的钱,把你半年的预估用量套进去算,数字会差很多。
第二个是IP的保留规则。这个特别关键:续费之后,我原来那批IP还是原来那批吗?如果你的业务涉及登录态、白名单对接、固定合作方的接口调用,IP一换,等于前面的配置全部重来。所以要在购买前就确认:静态IP在合约期内是否绑定不变,续费时是否优先保留原有IP,断档多久会被系统回收。
第三个是回收和找回规则。有些服务商规定欠费或者停用几天后IP重新进入公共池,之后再想拿回来基本靠运气。这一条对需要长期稳定出口的团队来说,比价格重要得多。
第四个是迁移成本,也就是更换供应商时代码要改多少行。这点常被忽略,但它决定了你将来"想走能不能走得掉"。如果接入的时候老老实实用标准协议(HTTP/HTTPS/SOCKS5)、把认证信息抽成配置、把提取接口包一层自己的适配函数,那换供应商基本是改一个常量的事。反过来,如果直接在各处硬编码,迁移就变成一次小重构。
| 评估项 | 短效动态IP | 长效静态IP | 固定IP代理 |
|---|---|---|---|
| 典型存活表现 | 分钟级,频繁更换 | 数天到数周,中位数稳定 | 合约期内不变 |
| 连通率关注点 | 提取速度、并发上限 | 分时段稳定性、城市分层 | 白名单生效速度 |
| 续费时最该问的 | 提取量是否随续费调整 | IP是否绑定保留 | 保留期与回收规则 |
| 适合的任务 | 分散、短平快的采集 | 需要登录态或长期会话 | 对接合作方接口 |
四、把三个维度合起来看,结论会不一样
单独看任何一个维度都容易得出偏颇的结论。举两个真实的判断场景:
场景一,某池子的存活周期很短,只有几分钟,但连通率98%以上,价格还便宜。这种用来做分散的公开数据采集其实很合适,因为你不依赖单个IP的持久性,掉了再换就行,成本低、效率高。
场景二,某池子存活周期长,但衰减曲线很陡,第10天成功率就掉到六成。这种就属于"看着稳定,其实在慢慢漏",你如果不做回测,会一直在用一个越来越差的IP而不自知。
所以我一般建议:按任务类型选产品线,再按产品线定评估权重。需要会话连续的,权重压到存活周期和IP保留规则上;需要跑量的,权重压到连通率和计费口径上。这比笼统问一句"哪家好"有效得多。
如果你测下来发现,自己的业务确实需要一批能长期在位、又不想天天盯着换IP的出口,那么长效静态IP或者固定IP代理就是更对路的选择。神龙HTTP 这方面提供的是短效动态IP、长效静态IP、固定IP代理的一站式组合,IP资源来自国内三大运营商正规授权,储备规模在3000万+,可用率99.9%、IP纯度99.8%,支持300+城市级精准定位,接口按HTTP/HTTPS/SOCKS5标准协议来,接进现有代码基本不用改逻辑。
另外两个我觉得对"长期用"这件事特别有用的点。一是个人中心里的可视化用量统计和实时监控,能直接看到各条线路的调用趋势和异常波动,说白了就是把前面那些手工统计的活儿自动化了一部分,你不用天天自己跑脚本对表格也能发现哪个城市在掉线。二是API兼容主流爬虫编程语言,文档和示例代码给得比较全,技术团队7×24小时在线,遇到连通率突然下降这类问题,能拉人一起看而不是自己闷头猜。
五、一份可以直接抄走的评估清单
最后把上面的内容压成一份清单,你下次换服务商时照着填就行:
存活周期——记首次可用时间、在线时长中位数、第3/7/15天成功率、掉线后能否找回。
连通率——分早晚两个时段、分3秒和8秒两档超时、按城市分层、失败原因归类为不通/超时/被拦。
续费机制——确认计费口径、IP是否绑定保留、欠费多久回收、续费价格怎么算、迁移要改多少代码。
接入方式——统一走标准协议、认证信息进配置、提取接口包一层自己的适配层。
这套东西跑一周,你手上就有一份别人给不了的数据。之后再谈价格,心里是有底的——因为你算的不是单价,而是"这个价格能换来多少小时的有效工作时间"。
常见问题
Q:长效静态IP是不是就永远不会变?
不是。静态指的是在约定的使用周期内出口地址保持稳定,方便你做白名单和会话保持,但服务商侧仍然会有维护、故障切换这类情况。所以接入时要有兜底逻辑:一旦检测到出口地址变了,能自动更新白名单或触发告警,而不是等业务报错才发现。
Q:标称99.9%可用率,我测出来只有92%,是虚标吗?
先别急着下结论,先对齐口径。你的超时阈值是多少?测的是哪个时段?测的目标站点会不会本身就在限速?把超时从3秒放宽到8秒、把测试时段挪开晚高峰再测一遍,很多差异就消失了。如果对齐口径之后仍然差很多,把日志发给技术支持,让他们从节点侧看是不是某个城市出口有问题,这种情况通常能定位。
Q:续费的时候,原来的IP会被换掉吗?
这取决于产品类型和服务商规则,购买前一定要问清楚,尤其是短效动态和长效静态的差异。需要长期固定出口的,直接选固定IP代理这类绑定型产品,并在合约里确认保留期;同时把自己的业务配置做解耦,即便IP真的变了,改动量也控制在一处。
Q:我的采集量不大,还有必要折腾这套评估吗?
量小可以把频率降下来,比如一周测一次、样本从20个减到8个,但几个关键口径别省:超时阈值、失败归因、IP是否保留。这三个地方不清楚,出问题的时候你连"是代理不行还是目标站改了规则"都判断不了,排查时间成本远比测试成本高。