上周有个做数据采集的朋友给我看他的月度账单,同样的采集任务,这个月花的钱是上个月的两倍多。他第一反应是"涨价了吧",翻出报价单一看,单价没动,动的是他自己的重试次数——某个站点上了新的验证页,他那套脚本连续失败了十几天才被发现。
这种情况在用按量付费代理IP的团队里挺常见。按量付费本身没什么问题,灵活、不压货、不做无用功,但它的钱是"流"出去的,不是一次性交的,你得知道它从哪条缝里流走。下面就拿电商比价和舆情监测这两个最典型的场景,把账拆开算一遍。
一、先说清楚:按量付费"按"的到底是什么量
不同服务商的报价单写法不太一样,但落到计费维度上,基本跑不出这四个口子:
提取次数。你从接口里拉一次IP,算一次。这是最常见的计价单位,按"千次提取"报价的居多。注意这里说的是提取,不是你实际用IP发了多少个请求——一个长效IP可以撑几十上百次请求,短效的可能三五分钟就换。
并发上限。有些服务商的低档位会卡并发,比如同时只能跑10个线程。你算法再快也只能排队,时间成本就这么上去了。报价单上通常写得很小字,得翻到底部看。
会话时长。短效IP一般几十秒到几分钟,长效静态IP可以到小时甚至天级。做比价的时候如果商品页要滚动加载、还要点开规格弹窗,几秒就断的IP基本等于白买。
失败是否计费。这条最容易吃亏。有的服务商只要IP发出去了就扣费,不管你是拿到200还是拿到一个503。你的成功率从95%掉到70%,账单不会跟着掉。
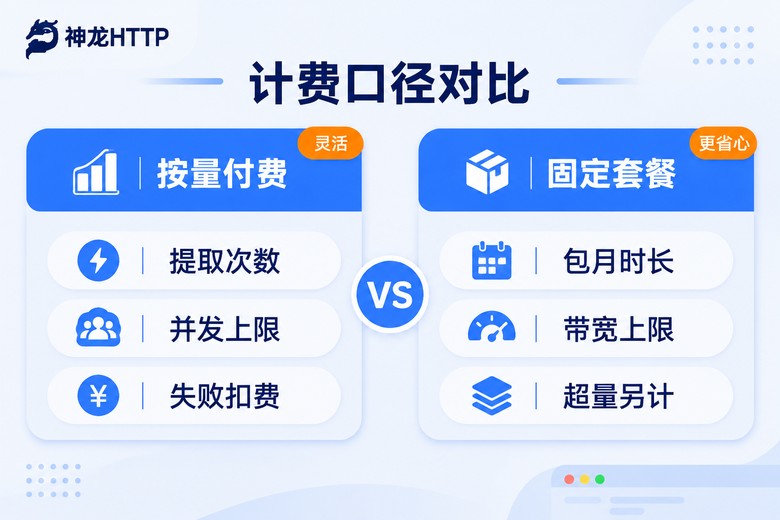
把这四条写在纸上,再去看报价单,很多"看着便宜"的档位会立刻现原形。
二、电商比价:一个商品页背后到底消耗多少次IP
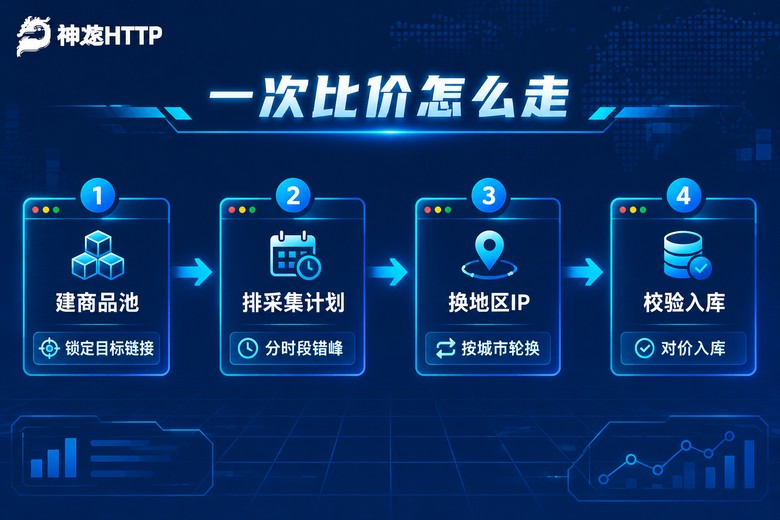
假设你盯的是8000个SKU,每天采两轮(早一次晚一次),每个商品要切3个城市视角看当地展示价。那就是 8000 × 2 × 3 = 48000 次请求/天。这还只是理想值。
真实情况里,电商页面有几个绕不开的坑:价格是异步加载的,你拿到HTML不代表拿到价格;部分类目会弹出领券浮层挡住按钮;规格选择要走XHR接口而不是页面本身。任何一个卡住,这一轮请求就废了,脚本会重试。实际重试率做到15%已经算不错的水平,那真实消耗就是 48000 × 1.15 ≈ 55200 次。
更关键的一点:比价这件事对IP地区的要求比大多数人想的高。同一件商品,不同城市仓的运费、活动价、是否有货都不一样,你用一批随机地区IP去采,采回来的数据本身就是脏的——花了钱,得到一堆对不上的数字。所以这一块的IP成本必须按"城市级精准"来估,不能按"国内随机"来估,两者的价差通常不小。
一段够用的重试与成功率统计脚本大概长这样,跑一天你就知道自己的真实重试率:
import requests, time

EXTRACT_API = "服务商提供的提取接口链接"
TARGETS = [...]   # 商品链接列表,每条带上目标城市

ok = retry = 0
for item in TARGETS:
    for attempt in range(3):
        try:
            ip = requests.get(EXTRACT_API, timeout=5).text.strip()
            proxies = {"http": f"http://{ip}", "https": f"http://{ip}"}
            resp = requests.get(item["url"], proxies=proxies, timeout=8)
            if resp.status_code == 200 and "price" in resp.text:
                ok += 1
                break
            retry += 1
        except Exception:
            retry += 1
            time.sleep(1)

print(f"成功 {ok} 条,重试 {retry} 次,重试率 {retry / (ok + retry):.1%}")
把这个比例记下来,它是你后面算成本时最有价值的一个数字。
三、舆情监测:钱最容易从哪几处漏掉
舆情监测和比价不是一回事。比价是"目标少、频次高",舆情是"目标多、深度深"。你盯着几百个新闻站、论坛、行业媒体,每个站要先翻列表页,再进正文页,正文里还得把评论区和相关推荐剔掉。一个站点平均吃掉3到5个请求,几百个站就是几千次,遇到突发事件要提频,一天翻好几倍都很正常。
漏钱的地方主要有三个:
一是长尾站的超时。大站响应快,长尾小站时不时抽风,设8秒超时的话,一个卡住的请求就白烧掉8秒和一次IP。把超时压到4秒、失败直接换IP重来,整体成本反而更低。
二是列表页翻页错乱。有的站分页参数在第3页之后开始返回重复内容,脚本察觉不到,一路翻到第50页,采回来一堆一样的东西。加个内容指纹去重,能省掉一大截无效请求。
三是全程只用一个地区的IP。舆情监测对城市的要求没比价那么高,但完全不换也会出问题——同一段IP连续访问一个站,很容易被识别成异常流量,然后你的成功率开始下滑,重试率往上飙。
| 对比维度 | 电商比价 | 舆情监测 |
|---|---|---|
| 采集深度 | 浅,一个链接一页 | 深,列表页 + 正文页 + 翻页 |
| 日请求量级 | 万级,波动小 | 十万级,随事件波动大 |
| 对IP地区的要求 | 高,需要城市级精准 | 中,多数只需国内多地区轮换 |
| 失败的主要来源 | 异步加载、浮层拦截 | 长尾站超时、分页重复 |
| 成本最敏感的点 | 无效地区IP的浪费 | 重试与超时的消耗 |
| IP时长偏好 | 短效,够走完一次会话即可 | 短效为主,个别站点用长效 |
四、三步算出你的"单条成本"
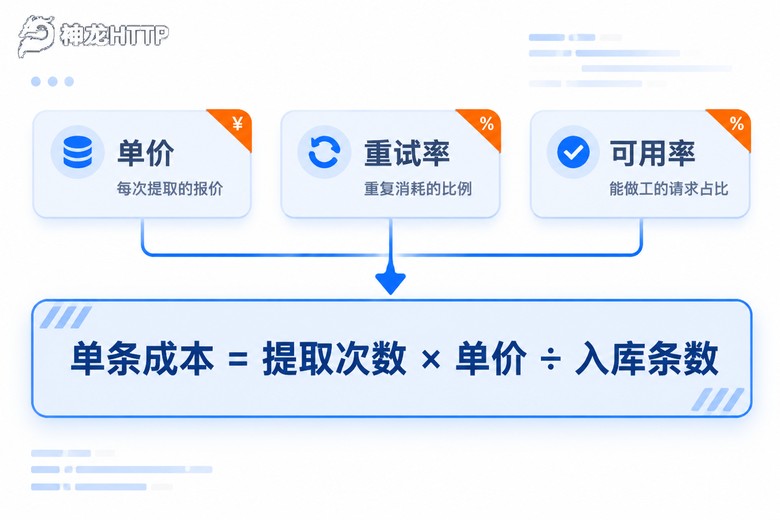
很多团队比价的时候只看"每千次提取多少钱",这个数字其实没什么参考价值,因为它不知道你多少次是白花的。真正能横向比较的指标只有一个:拿到一条有效数据,花了多少钱。
公式不复杂:
单条有效数据成本 = 提取次数 × 单次提取单价 ÷ 实际入库条数拆成三步来落地。
第一步,量出名义次数和实际次数。跑三天,把日志里的"发起请求数"和"成功入库数"都记下来。别用估算,就翻日志。
第二步,把重试摊进去。如果你的重试率是15%,那实际提取次数就是名义次数的1.15倍,这15%的钱必须算进分母。有些服务商失败不计费,这一块能省下来,报价单上要专门确认。
第三步,换算成每千条有效数据的价格。假设你一天入库5万条有效数据,日成本是C,那就是 C ÷ 50(千条)。拿这个数去比两家服务商,谁便宜一目了然——比"每千次提取多少钱"靠谱得多。
顺带一提:第三步算出来的数字,如果在换了服务商之后仍然算不出来,说明你的日志埋点有问题。这是成本测算的地基,不是可有可无的装饰。
五、选型时我会重点看的几张牌
算完成本,回到"选哪家"的问题上。除了单价,有几个点会直接影响上面那个公式的结果。
能不能先小量试。这是我最看重的。再漂亮的参数,不跑一遍你的目标站点都是空谈。神龙HTTP 支持先拿小流量跑通,API 兼容主流的爬虫编程语言,文档和示例代码直接能粘进项目里改,接起来不折腾。跑两天,重试率、可用率这些数字自己就出来了,比任何对比表都真实。
地区颗粒度够不够细。做电商比价,这一条几乎决定成败。神龙HTTP 提供 300+ 城市级精准定位,背后是国内三大运营商正规授权的 3000万+ 代理IP储备,短效动态、长效静态、固定IP几条产品线都有,采集任务里该用短的用短的、该挂长的挂长的,不用为了一个需求勉强凑合。IP 纯度做到 99.8%,可用率 99.9%,这两个数直接落到你公式的分母上。
有没有用量台账。个人中心里有可视化的用量统计和实时监控,能看出哪天提取量突然涨了、哪个时段成功率掉了。上个月那位朋友的账单翻倍,如果有这么一张图,他第一周就能发现问题,不至于拖一个月。异常识别和使用趋势分析这种东西,平时看着没用,出事的时候能救钱。
出问题能不能马上找到人。采集任务卡在验证页上过夜,第二天早上开会的报告就是空的。技术团队 7×24 小时支持,这条听着像套话,但真在凌晨两点被卡住的时候,它是唯一能救命的东西。
常见问题
Q:按量付费一定比包月套餐贵吗?
不一定,得看你的用量曲线。如果每天请求量稳定、跑满全月,包月摊下来的单价往往更低;但采集任务的量级波动本来就大,遇到大促或者突发事件翻几倍,包月的固定额度要么不够用要么平时闲着。按量付费的价值在于你不用为闲时买单。判断方法很简单:把过去三个月的日请求量拉成折线,波动超过30%的,按量付费通常更划算。
Q:电商比价必须用城市级定位的IP吗?
取决于你采的范围。如果只关心全国统一展示价,普通国内IP就够;但只要你需要看不同城市仓的价格、运费、库存状态,那就必须用对应城市的IP,否则采回来的数据对不上,等于白花钱。这一块宁可单价高一点,也别用随机地区的IP硬凑,浪费的钱远多于省下的。
Q:重试率多少算不正常?
10%以内属于正常波动,15%左右需要看一眼是不是目标站改版了,超过25%基本可以确定有问题——要么IP地区不对,要么请求头伪装没做好,要么被站点限流了。建议每天定时把重试率打出来看一眼,成本异常基本都是从这个数开始的。
Q:失败请求被计费了怎么处理?
先确认报价单上的规则,有的服务商明确写了"仅成功提取计费",有的则不做区分。如果是不区分的那种,你就要在估算时把重试率乘进去,当作实际单价的一部分。另外,别把所有失败都归因于服务商——超时设置过长、目标站返回空页面但状态码是200,这些是脚本侧的问题,换谁家的IP都救不了。
Q:舆情监测需要买长效静态IP吗?
大部分场景不需要。舆情采集的特点是一个页面拿完就走,短效IP足够覆盖一次完整会话。只有少数需要保持登录态、或者页面交互特别重的站点,才值得给它们单独配长效静态IP,按站点分类配置,比全局都用长效要省很多。