先说结论:自己搭一个HTTP代理,难的不是"搭",是"养"
上个月有个做市场研究的朋友找我,说他要看不同城市站点展示的页面差异,问我能不能帮他在云主机上弄个HTTP代理。我花了大概二十分钟给他跑通,配置也就三十来行。结果第二周他电话又来了——端口被人扫到,机器流量跑飞了,云厂商直接给他限速。
这个故事基本能概括这件事的全貌:部署环节一周内就能学会,真正吃掉时间的是后面长期的运维。所以这篇不打算只丢几段配置了事,会把从开机器到日常巡检的完整链路走一遍,包括我自己踩过的几个坑。
动手前,先把三样东西备齐
很多人卡在第一步不是不会装,而是方案没想清楚。开机器之前先回答三个问题:
一、你要几台机器? 只做本机或小团队出口,1核1G的入门配置就够跑Squid。如果预估并发连接数在几百以上,内存和带宽都得往上加一档,代理软件本身不重,重的是连接数和出口流量。
二、地址怎么规划? 云主机的公网IP是代理的"门牌号",如果你需要多个地区的出口地址,就得在不同区域各开一台。提前把每台机器的用途、区域、负责人记在一张表里,后面排障能省很多事。
三、走哪个协议? HTTP/HTTPS代理用Squid最稳,Tinyproxy更轻,资源占用低;需要SOCKS5就走3proxy这类。绝大多数公开数据采集场景,HTTP/HTTPS已经够用,不必一上来就上更复杂的方案。
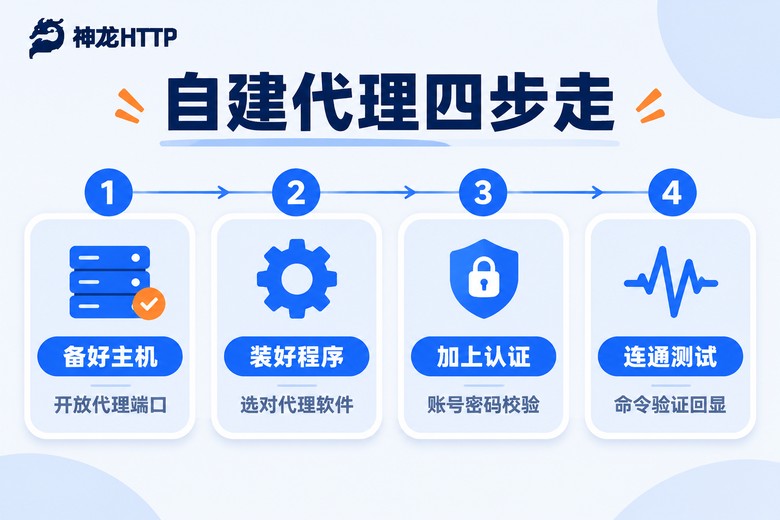
第一台代理服务器:十分钟装完Squid
以最常见的Ubuntu为例,一条命令搞定安装,端口默认3128。整个过程比装个桌面软件还快。
sudo apt update
sudo apt install -y squid
sudo systemctl enable --now squid
ss -lntp | grep 3128   # 确认端口已监听
装完之后先别急着从外面连。打开配置文件 /etc/squid/squid.conf,把默认那堆注释冗长的规则换成下面这几行,逻辑是"只放行我自己的固定地址,其他一律拒绝":
http_port 3128
acl my_ip src 203.0.113.24/32
http_access allow my_ip
http_access deny all
改完执行 sudo squid -k reconfigure 让它重新加载。这里有个新手常犯的错:改完配置直接重启服务,结果端口冲突报错却看不出来。用 reconfigure 会先检查语法,有问题会明确告诉你第几行不对。
顺带提一句云厂商的安全组。光在机器里放开端口没用,控制台那层防火墙也得放行你自己的来源地址,否则外网怎么连都是超时。
加一层账号密码,别让代理变成公共出口
上面那种绑固定IP的做法适合来源地址稳定的场景。如果一个IP会变,就要走认证方式。装一个密码生成工具,给每个使用者建独立账号:
sudo apt install -y apache2-utils
sudo htpasswd -c /etc/squid/passwd crawler01
然后在配置里加三行,开启基础认证:
auth_param basic program /usr/lib/squid/basic_ncsa_auth /etc/squid/passwd
auth_param basic realm proxy
acl authenticated proxy_auth REQUIRED
http_access allow authenticated为什么强烈建议加这层?我那位朋友的机器就是在裸奔阶段被扫到的——公网上的扫描器会成规模地试探常见代理端口,一个没认证的3128对外开放,通常撑不过一天。账号密码不是可选项,是入场券。如果团队人多,一人一号、离岗即删,还能顺带通过日志定位是谁的流量异常。
测试:三条命令确认它真的通了
配置完别靠感觉,用命令验证。第一条看出口地址是不是你服务器的那一个:
curl -x http://crawler01:你的密码@服务器IP:3128 https://httpbin.org/ip第二条验证HTTPS是否正常穿透,重点看返回码:
curl -x http://crawler01:你的密码@服务器IP:3128 -I https://example.com第三条最容易被忽略——测一下实际耗时。把 -w 参数加上,看总耗时和连接耗时:
curl -x http://crawler01:你的密码@服务器IP:3128 -o /dev/null -s \
-w "总耗时 %{time_total}s 连接 %{time_connect}s\n" https://example.com如果总耗时稳定在几百毫秒,说明链路正常。要是经常蹦到两三秒,大概率是服务器带宽被其他进程占了,或者你选的机房离目标站点物理距离太远——这也是自建最容易吃亏的地方,你只有一台机器,出口位置是固定的。
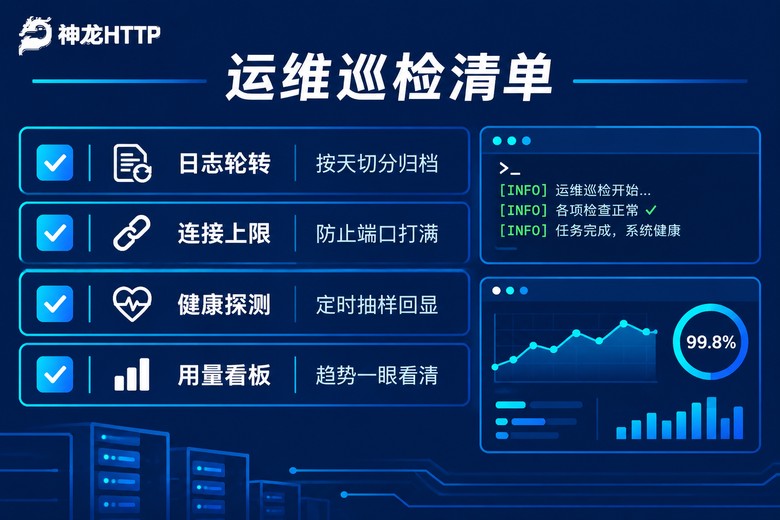
运维才是真正的开始:四件事要盯住
能从"部署完了"走到"稳定跑了半年",中间差的是下面这些日常动作。
日志轮转。Squid的访问日志长得比你想象中快,一个中等流量的小时级访问就可能有上万行。配好按天切分和保留周期,别等磁盘写满、服务静默退出才发现。默认日志在 /var/log/squid/,用 logrotate 加一条规则即可。
连接数上限。给每个账号设个并发上限,避免某一个任务把端口占满、其他人全都超时。Squid里可以用 client_idle_pconns 一类参数控制空闲连接,实际用起来比想象中更有用。
出口地址的健康探测。写个定时脚本,每隔几分钟用代理请求一次固定地址,把返回码和耗时写进小日志。连续几次失败就告警。这套东西看着简陋,但能让你在业务方发现之前知道机器出了问题。
用量与趋势。把每天的请求数、失败率、平均耗时记下来,画成一条线。某天失败率突然抬头,通常意味着上游目标站点调整了策略,或者你的出口地址被限了频。有趋势图,判断起来会快很多。
自建和用现成服务,到底差在哪
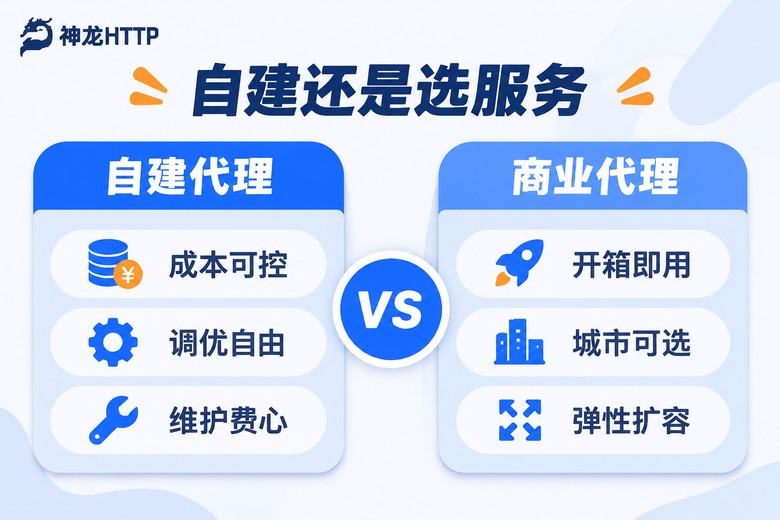
把话摊开说。自建的优势是可控——配置在你手里,日志在你手里,想加什么规则自己加。但代价是:机器你得养,故障你得修,出口位置取决于你开了几台机器,而这恰恰是数据采集类任务最常碰到的瓶颈。
| 对比项 | 自建代理 | 商业代理服务 |
|---|---|---|
| 上手时间 | 半小时到一天 | 注册后即可调用 |
| 出口位置 | 取决于开了几台机器 | 多城市可选,随时切换 |
| 扩容方式 | 加机器、加配置、加运维 | 调整调用参数即可 |
| 日常维护 | 日志、监控、安全加固全靠自己 | 服务方负责 |
| 故障处理 | 自己排查,无人兜底 | 有技术支持通道 |
| 适合场景 | 小流量、固定出口、学习验证 | 公开数据采集、市场研究、持续运行的任务 |
我一般的建议是:先用自建跑通流程,理解代理的工作方式,然后把长期跑的业务搬到商业服务上。自建这件事的价值在于让你明白超时到底出在哪一层,而不是让你真的去养几十台机器。
什么时候该考虑换成专业服务
有几个信号很明显:任务开始要求覆盖多个城市、机器数量从两台涨到十台、每天早上第一件事是看监控有没有红。到这一步,自建的时间成本已经超过它省下的钱了。
像神龙HTTP这类服务,解决的就是上面表格右列的那些问题。它家有3000万+正规授权代理IP储备,可用率99.9%,支持300+城市级精准定位,需要换到某个城市时直接在调用参数里指定就行,不用再为了一台机器跑一遍部署流程。协议上HTTP/HTTPS/SOCKS5都支持,短效动态IP、长效静态IP、固定IP代理这几条产品线可以按任务类型挑——短期高频的采集用短效动态,需要长期稳定会话的用长效静态。
接入方式也不复杂,API兼容主流爬虫编程语言,官方有文档和示例代码,装个依赖、改几行请求参数就能跑起来。个人中心里能看到可视化用量统计和实时监控,哪段时间请求量异常、哪个城市返回失败多,一眼就能看出来——这恰好补上了自建方案里最费人的那块。技术团队7×24小时在线,真卡住了有人接。
常见问题
Q:自己在云主机上搭HTTP代理,需要备案或者额外资质吗?
用境内云主机对外开放服务,按云厂商的要求走实名与相关流程即可;具体规则各家不同,开通前看一眼控制台的提示。另外无论哪种情况,代理端口都不建议无认证对外开放,这是安全底线,不是合规问题。
Q:装好了,但curl一直超时,从哪开始查?
按这个顺序:机器里 ss -lntp 看端口有没有真的监听;控制台安全组有没有放行你的来源地址;配置文件里 http_access 的顺序对不对(Squid是从上往下匹配的,deny all放太前面会把所有请求挡掉);最后看日志 /var/log/squid/cache.log,报错信息通常写得很直白。
Q:一台入门配置的机器能扛多少请求?
关键不在CPU,在带宽和并发连接数。纯文本页面的小请求,1核1G配普通带宽跑日常使用没问题;但如果有大文件下载或者几百个并发连接,很快就顶到上限。实际压测一遍比估算靠谱,先小流量跑一天看监控曲线。
Q:自建的代理一定比商业服务慢吗?
不一定,取决于机房位置和线路。如果目标站点就在同城,自建延迟可能更低。但如果你的任务需要覆盖多个城市,自建就得每个城市开一台机器,成本和维护量会成倍上升——这种时候商业服务的城市级精准定位优势就很明显了。