一个公司里往往不止一个团队在用代理IP。数据组写爬虫要用,市场组做竞品价格监测要用,算法组跑模型训练的数据清洗也要用。刚开始大家都是自己申请、自己接、自己管,等到月底对账,三份账单三套口径,谁也说不清到底花了多少;出了故障,业务方找 A 团队,A 团队说不是我这条链路,最后查半天发现是某个系统的密钥过期了。
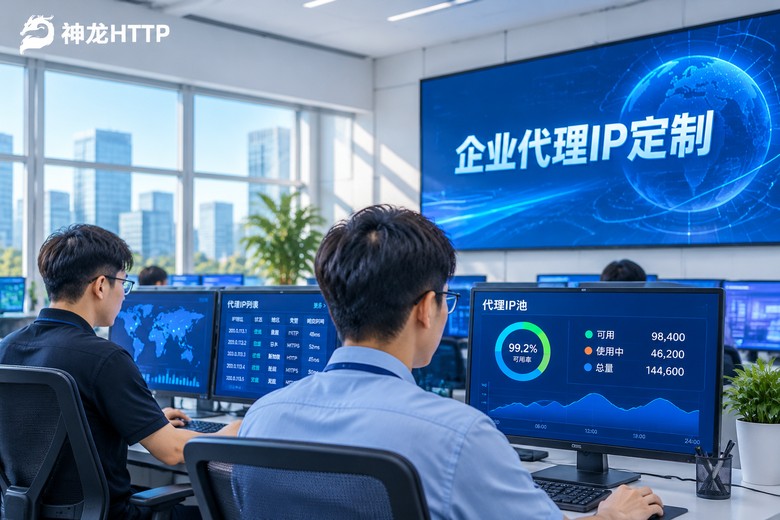
这就是为什么"企业级代理IP定制"这件事,2026 年越来越不像买一个套餐,而更像做一次架构设计和一份服务约定。下面按我们实际帮客户落地过的路径,一步步拆开讲。
一、先别急着选套餐,把多系统接入的坑摊开看
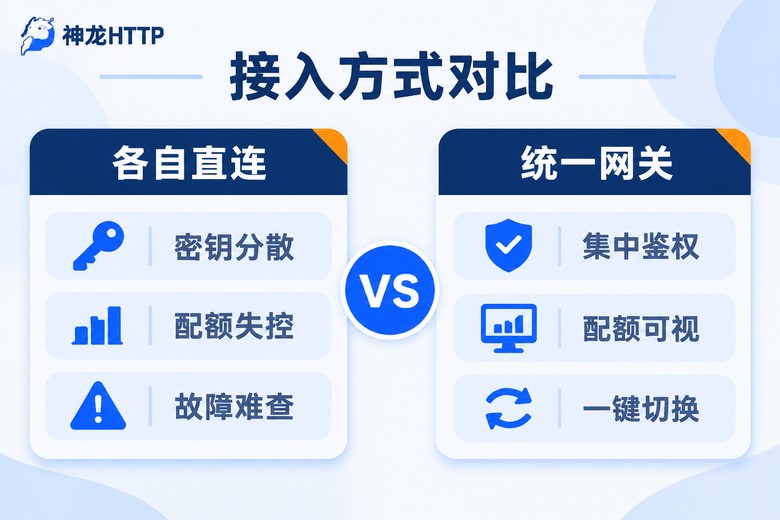
多个系统共用一个代理资源池,问题基本集中在四个地方,你可以对照自己公司看看中了几条:
密钥散落。每个系统一套账号密码,写在配置文件里、写在环境变量里、甚至硬编码在脚本里。有人离职、有人改密码,就是一波线上报错。
配额失控。没有统一出口,某个系统某天跑了个大任务,把当月 IP 提取量吃掉了七成,其他系统排队等着,业务方互相投诉,但谁也拿不出数据证明是谁占的。
地区与协议不统一。有的系统要华东地区的 IP,有的要指定城市;有的走 HTTP,有的走 SOCKS5。各写各的逻辑,重复造轮子,还容易写错。
故障定位慢。报错日志里只有一行超时,是目标站点拦了、代理 IP 失效了、还是自己网络抖动?没有链路追踪,只能靠猜。
把这几条摆出来之后,方案方向其实就清楚了:不要再让业务系统直接对接代理服务,而是中间加一层统一网关。
二、架构怎么分层:把代理调用收进一层
推荐的四层结构,从上往下是:
接入层——给业务方一个统一入口,可以是 HTTP 接口,也可以是一个轻量 SDK。业务代码只需要说"给我一个上海地区的 HTTP 代理,要能撑 30 分钟",不用关心背后是哪条产品线。
调度层——负责按地区、协议、存活时长去资源池里取 IP,做失败重取和冷热分流。短效动态 IP 适合高频轮换的场景,长效静态和固定 IP 适合需要保持会话的场景,这一层做判断。
鉴权与配额层——每个业务系统一个独立凭证,各自有日/月额度上限,超额自动降速而不是直接断掉,同时把用量按系统打标签记下来,对账就有依据了。
可观测层——提取成功率、平均首次响应时间、IP 失效率、各系统调用量,四个指标做成看板,异常自动告警。
落到代码上,这个统一客户端大概长这样,业务方拿过去改个业务名就能用:
import requests, time

ENDPOINT = "代理提取接口地址"   # 由平台统一分配
TOKEN    = "业务专属密钥"        # 一个系统一个,方便对账

def fetch_ip(area="上海", protocol="http", retry=3):
    """统一取 IP:带重试和失败兜底"""
    params = {"area": area, "protocol": protocol, "num": 1}
    headers = {"Authorization": f"Bearer {TOKEN}"}
    for i in range(retry):
        try:
            r = requests.get(ENDPOINT, params=params, headers=headers, timeout=5)
            if r.status_code == 200 and r.text.strip():
                return r.text.strip()
        except requests.RequestException:
            pass
        time.sleep(0.5 * (i + 1))   # 退避重试,避免打爆接口
    return None
重点是 TOKEN 按系统拆分,别图省事全公司共用一个。后面所有用量统计、限额控制、问题排查,都建立在这个拆分上。
三、提取方式怎么选:三类产品对应三类系统
很多团队卡在这里,其实按业务特征对号入座就行:
| 类型 | 存活特征 | 适合的系统 | 选型建议 |
|---|---|---|---|
| 短效动态IP | 存活时间短,可高频获取新IP | 公开数据采集、价格监测、搜索结果核对 | 并发要求高的主力池,按需提取,失败即换 |
| 长效静态IP | 存活周期长,会话稳定 | 需要保持登录态、多次请求同一站点的任务 | 数量不用多,但要预留冗余 |
| 固定IP代理 | 长期不变,可加白名单 | 内部系统对接、合作方接口回调、固定出口的业务 | 用于需要报备出口地址的场景 |
一个常见误区是:所有系统都往动态池里塞。结果需要保持会话的那条业务,因为 IP 中途变化不断重新登录,成功率掉到六成以下,团队还以为代理质量不行。分开选型之后,同样一批资源,整体成功率能明显往上走一截。
四、服务约定:这几条一定要写清楚
定制两个字的价值,很大一部分体现在约定上。别只谈价格和量,下面这些条款建议逐条落到合作文档里:
可用率口径。是按时长算还是按请求次数算?夜间算不算在内?口径不一致,后面每次对账都要吵一轮。神龙HTTP 给出的可用率是 99.9%、IP 纯度 99.8%,这类数字要明确统计方式和周期。
并发与提取速率。写清楚峰值 QPS 上限和超出后的处理方式(限速还是拒绝),避免业务方以为"买了就能无限跑"。
地区覆盖粒度。300+ 城市级精准定位,不代表每个城市的库存量一样。如果有重点城市,最好在约定里单独标注保障量级。
故障响应与恢复时限。什么级别的问题多久响应、多久给替代方案,写明白。技术团队 7×24 支持这条,要落到具体的联系通道上。
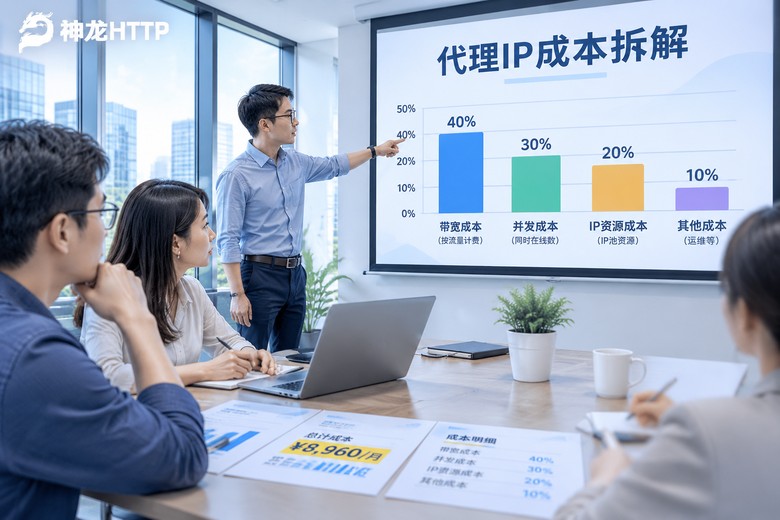
对账口径与账单维度。按系统、按项目、按天可拆,最好能导出明细。这一步做扎实,财务那边一次就能过。
五、上线别一把梭:压测和灰度怎么做
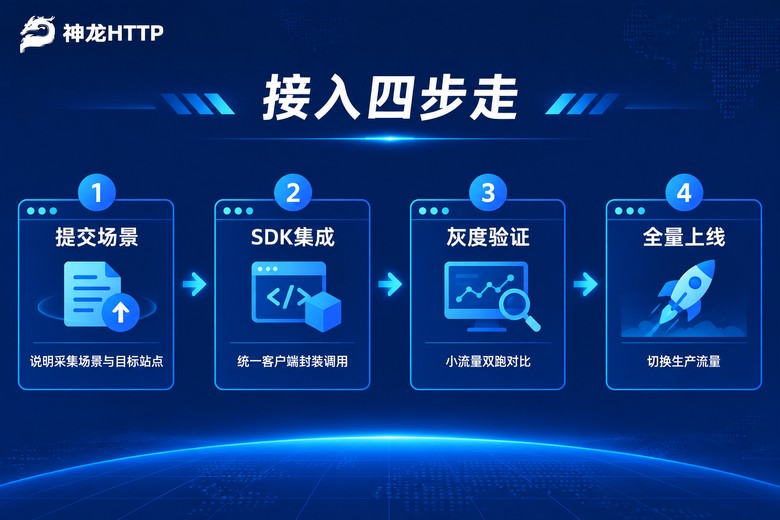
架构和约定都定了,很多人就直接切生产流量,这是最容易翻车的一步。稳妥的做法分三拍:
第一拍,单系统小流量灰度。挑一个对成功率不敏感、量也不大的系统先接,比如内部的市场研究脚本。跑三天,看成功率、看提取耗时、看有没有 IP 被目标站点大面积拦截。
第二拍,双跑对比。新旧两条链路同时跑一周,同一批任务各走一遍,把成功率、平均耗时、单任务 IP 消耗量摆在一起看。这一步经常能发现预算预估偏差——有些任务实际消耗比想象中多得多。
第三拍,全量切换。先切读多写少的业务,再切核心链路。老链路保留两到四周作为兜底,随时能回退。
压测时别只压"能不能取到 IP",更要压"取不到的时候系统表现如何"。代理这个环节,超时和失败是常态,你的代码对失败的处理方式决定了整体稳定性。
六、日常运维:靠看板而不是靠问人
上线之后,架构能不能长期稳住,取决于你有没有一块能看懂的看板。神龙HTTP 的个人中心里提供了可视化用量统计和实时监控,各系统的提取量、成功率走势、异常波动都能直接看到,还能识别异常调用、分析使用趋势。建议每周固定看一眼这三件事:
一是成功率曲线有没有拐点,突然掉下去通常是目标站点改了反爬策略,或者某个系统在异常高频调用;二是各系统的用量占比,某个系统用量凭空翻倍,先问业务再问代码;三是地区分布,重点城市的提取量占比如果和业务预期差太远,说明调度层的地区参数没传对。
把这些看清楚,代理这个环节就从"玄学"变成了一个可以正常管理的技术组件。
说到底,企业级代理IP定制做的不是一次采购,而是把一件原本分散在各处的小事,收成一个有人管、有数据、有约定、能回溯的基础能力。3000万+正规授权代理IP储备、国内三大运营商正规授权、支持 HTTP/HTTPS/SOCKS5 与 API 快速集成,这些是底座;统一网关、分系统配额、清晰的服务约定,才是让底座真正跑起来的那部分。
常见问题
Q:我们公司只有两个系统在用代理,也需要做统一网关吗?
如果两个系统的量都很小、也没打算扩,确实可以先简单点。但建议至少把密钥按系统拆开、用量按系统打标签。等到第三个系统出现时,这两步能帮你省掉大部分对账麻烦——我们见过太多团队是在账单对不上之后才回头补这一课的。
Q:短效动态IP和长效静态IP可以混着用吗?
可以,而且大多数企业最后都是混用的。关键在于调度层要判断清楚:这条请求需不需要保持会话。建议在业务侧调用时就显式声明场景(比如传一个 scene 参数),别让网关去猜,猜错了就是一次莫名其妙的失败。
Q:怎么判断代理资源够不够用?
别看总量,看峰值并发和单位时间提取量。压测时记录两件事:正常业务下每分钟消耗多少个 IP、失败重试会额外吃掉多少。通常真实消耗会比按任务数估算的高出 20%~50%,预留这个余量比事后加买更省钱。
Q:服务约定里最容易被忽略的一条是什么?
是"超出并发上限时的处理方式"。很多约定只写了上限数字,没写超了会怎样,结果业务高峰时被限速,团队以为是服务方故障,服务方以为是你超量,各执一词。写清楚是降速、排队还是拒绝,附上告警通知方式,这条能省掉大量沟通成本。