同一份需求,两份报价差了将近四倍
上周有位做市场研究的读者甩来两张报价单,问得特别直接:同样是每天抓十几万条公开数据,同样要二十来个城市的出口,A家算下来比B家便宜将近四倍,是不是闭眼选A就行?
我让他把两份单子上的计价单位圈出来。一份写的是「每 GB」,一份写的是「每 IP 每天」。这两个单位量的根本不是同一样东西,放在一起比价格,就像拿西瓜的斤价去比瓜子袋的价格。
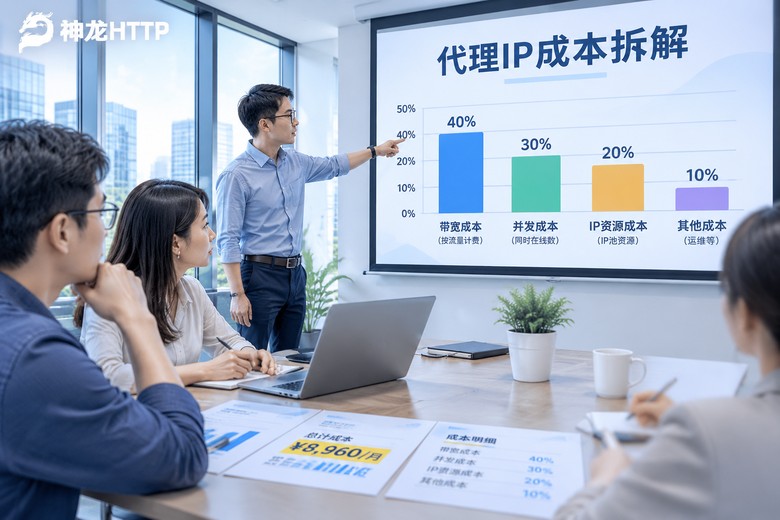
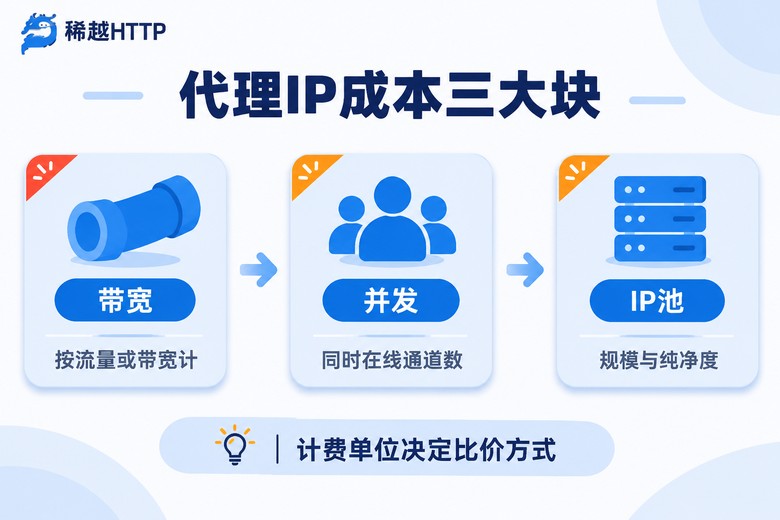
代理IP这门生意,卖的东西其实能拆得很干净:你要有出口(IP池)、要有通道(并发)、数据要跑得动(带宽)。三样东西的成本结构完全不一样,所以报价方式才五花八门。今天就把这层皮剥开,你以后拿到任何一份报价单,都能自己判断它贵在哪、是不是你的钱该花的地方。
带宽:先分清「管子有多粗」和「用了多少水」
带宽这个词很容易糊弄人。有人跟你说「给你 100M 独享」,说的是水管粗细;有人跟你说「每月 500G 流量」,说的是你用了多少水。两者都叫带宽成本,但结算逻辑差得很远。
实际采购时你会碰到三种计价方式:
| 计费方式 | 计价单位 | 适合什么节奏的采集 | 容易踩的坑 |
|---|---|---|---|
| 纯流量计费 | 每 GB | 采集量忽高忽低、项目制、月初闲月底忙 | 目标站点页面大,流量悄悄超标 |
| 带宽计费 | 每 Mbps / 月 | 长期稳定高频,几乎跑满不歇 | 没跑满就是白付通道钱 |
| 混合方式 | 基础包 + 超出按流量 | 有固定基线、偶尔冲一波峰值 | 要看清超出部分的单价 |
流量成本这块,很多人栽在「抓了不该抓的东西」上。同一篇文章页面,只要正文文本可能才 60KB,但把图片、JS、CSS 一起拉下来,单页能飙到 1.5MB 以上。差二十多倍。采集时在代码里关掉静态资源加载、只走接口,你在这条成本线上能省下的钱,比跟供应商磨半天价还多。
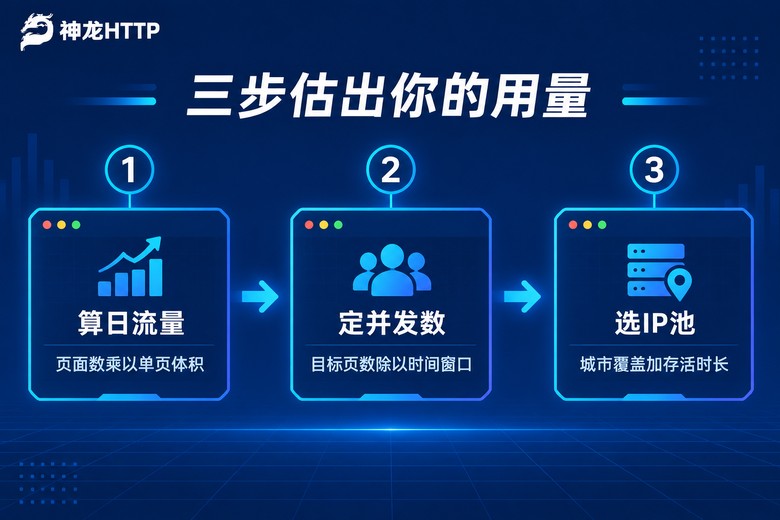
动手前先给自己算一笔,比拍脑袋靠谱:
# 估算每天要消耗多少出口流量
pages_per_day = 180_000      # 每天目标页面数
kb_per_page   = 480          # 单页平均响应体积(含 HTML + 少量静态资源)
fetch_static  = False        # 是否拉取图片/JS/CSS

if not fetch_static:
    kb_per_page = kb_per_page * 0.35   # 只走文本和接口时,体积大概降到三分之一

daily_gb = pages_per_day * kb_per_page / 1024 / 1024
print(f"日流量约 {daily_gb:.1f} GB")
print(f"按 30 天算,月流量约 {daily_gb * 30:.0f} GB")
这个数字出来之后,再回头看报价单上的「每 GB」,你心里就有底了:月流量 200GB 的方案和月流量 2TB 的方案,哪怕单价一样,总价也差十倍,而你真的需要那么大的量吗?
并发:最容易被忽略、也最容易临时加钱的一项
并发说白了就是「同时能开几条通道」。你程序里开 100 个线程同时发请求,就需要 100 个并发通道在跑;如果供应商只给你 5 个,剩下的 95 个请求就只能排队、超时、报 429。
为什么并发是成本里最硬的一块?因为它绑着真金白银的资源:出口机器的调度能力、IP 轮换的频率、风控过滤的算力,全都是按通道摊的。一个IP池再大,同时在跑的通道数也是有限的,商家不太可能在这块让太多。
所以低价套餐里藏得最深的限制往往不是流量,而是并发。你看着便宜,买回来一跑,发现只能开 5 个通道,原来 8 小时能干完的活变成三天,人工和机器成本早把省下的钱吃回去了。
并发怎么估?拿你的目标量去除以时间窗口就行:
target_pages   = 180_000     # 目标页面总数
window_hours   = 10          # 希望多长时间跑完
avg_latency_s  = 1.2         # 单次请求平均耗时(含少量重试)
safety_factor  = 1.4         # 留 40% 余量,应对站点变慢

qps_per_channel = 1 / avg_latency_s
need = target_pages / (window_hours * 3600) / qps_per_channel * safety_factor
print(f"建议并发通道数 ≈ {need:.0f}")
算出来大概是 70 上下。这个数字就是你跟供应商谈并发时的锚点——买 50 会卡,买 200 会浪费。另外提醒一句,并发不是越大越快,目标站点本身有承受上限,通道开太猛反而容易被拦,稳定比猛更重要。
IP池规模:池子大不等于你要买大的
IP池这项成本包含三个维度,很多人只盯着第一个:
总量——可调用的IP数量;覆盖——能精确到多少个城市;纯净度与存活——IP是不是干净、能用多久。三个维度里,第二个和第三个其实更贵,因为要维护运营商资源、要做实时筛除。
目前主流的三类产品,成本逻辑差别很明显:
| 类型 | 存活特点 | 成本位置 | 更适合的场景 |
|---|---|---|---|
| 短效动态IP | 几分钟到几十分钟就换 | 相对低,按量提取 | 分散的公开数据采集、市场研究 |
| 长效静态IP | 几小时到几天不变 | 中高 | 需要保持会话连续的任务 |
| 固定IP代理 | 长期不变 | 最高 | 需要加白名单对接的长期业务 |
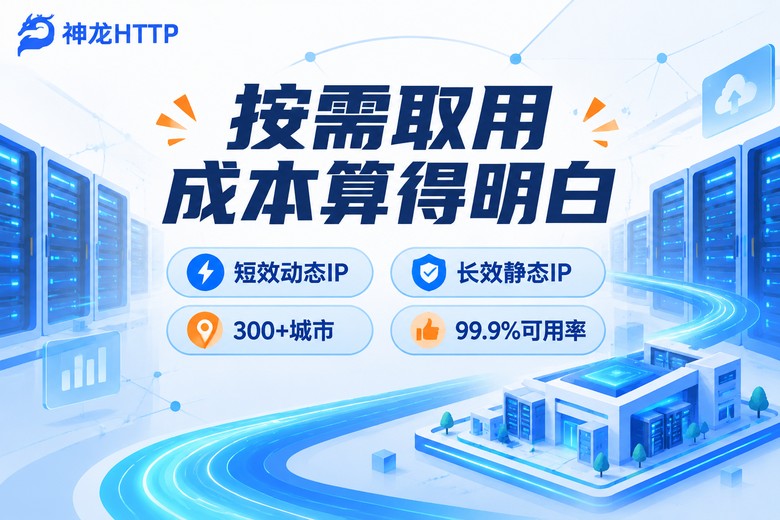
一个常见误解是「池子越大越好」。如果你的任务只是每天抓几个城市的公开商品信息,一个覆盖 300+ 城市、可用率稳定在 99.9% 的池子,配上合适的并发,完全够用;非要上最大规格,多出来的钱并不会让采集更快,只会让你的账单更厚。
把三项拼起来:算一笔完整的需求账
还是拿那位读者的需求当例子:每天 18 万页面、希望 10 小时内跑完、要覆盖 20 个城市、只抓文本和接口数据。三项分别是——
带宽:约 30GB/天,折合月流量 900GB 左右;并发:70 个通道上下;IP池:需要支持城市级定位、短效动态为主。拿着这三个数字去对照报价单,你会立刻发现某些「看起来很便宜」的方案其实是在并发上砍了刀,而某些「看起来很贵」的方案,是因为它给的是长效静态IP,根本不是你需要的规格。
还有一个经常被忽视的成本项:调试时间。有的服务商只给你一个IP列表,接入、重试、失效剔除全得自己写;有的提供现成API和示例代码,二十分钟就能跑通。你按人天折算一下,这笔账往往比单价差更值钱。
签之前,先问清这三个问题
第一,计价单位到底是流量、带宽、IP 数量还是请求次数?超出部分怎么算?第二,并发上限是多少,超限是限速、排队还是直接拒绝?第三,IP 池的城市覆盖和纯净度怎么保证,掉线怎么补?这三个问题答得清楚的,基本可以往下谈;答得含糊的,谨慎。
拿神龙HTTP举例,它的产品线划分相对清爽:短效动态IP、长效静态IP、固定IP代理各归各位,你按上面算出来的三个数字直接对号入座就行,不用在一堆套餐名里猜。底层是3000万+正规授权代理IP储备,来自国内三大运营商正规授权,支持 HTTP/HTTPS/SOCKS5 三种协议,300+城市级精准定位,可用率 99.9%、IP 纯度 99.8%,低延迟高并发提取,适合公开数据采集、AI大模型训练这类需要长期稳定跑的活。
对算成本这件事特别有用的一个细节:个人中心里有可视化用量统计和实时监控,能看到每天的消耗曲线、异常波动和使用趋势。你可能第一个月按估算买了量,跑完一看实际只用了七成,第二个月就能把规格调到更贴合的位置——这种「用数据反推自己真实需求」的动作,比任何估算公式都准。
import requests

# 提取链接在个人中心复制,粘进来即可
extract_url = "你在个人中心复制的提取链接"

resp = requests.get(extract_url, timeout=10)
ip_list = [line.strip() for line in resp.text.strip().split("\n") if line.strip()]
print(f"本次拿到 {len(ip_list)} 个出口IP")

# 用一个探针接口验证这批IP是否可用、延迟多少
probe = "https://你要访问的公开数据接口"
for proxy in ip_list[:5]:
    proxies = {"http": f"http://{proxy}", "https": f"http://{proxy}"}
    try:
        r = requests.get(probe, proxies=proxies, timeout=8)
        print(proxy, r.status_code)
    except Exception as e:
        print(proxy, "失效", e)
API 兼容主流爬虫语言,文档和示例代码齐全,接进去不算费劲。技术团队是 7×24 小时支持,跑量过程中真遇到并发顶不住或者某个城市掉线,能有人及时接住,这点在长周期项目里很重要。
常见问题
Q:报价单上「每GB」和「每IP·天」到底哪个更便宜?
没法直接比,因为它们量的东西不同。你先把日流量和需要的IP数量各自估出来,分别代入两种单位算出总价,再放在一起看。经验是:采集量大、单页体积小的任务,流量计费往往更划算;IP需求少、但要长时间保持同一出口的任务,按IP计价更合适。
Q:并发买小了会怎么样?
不会报错说「你超了」,而是表现为超时变多、失败率上升、任务跑不完。很多人第一反应是「这家IP质量差」,其实是通道不够。先按公式算出建议通道数,再留 30%–50% 余量,观察一周的实际失败率再决定要不要调。
Q:IP池是不是越大越划算?
看你的任务分布。需要覆盖很多城市、目标站点反爬比较敏感,池子大确实有价值;如果你只固定抓几个城市的公开数据,大池子带来的边际收益很低,钱应该花在并发和稳定性上。
Q:短效动态和长效静态该怎么选?
看任务要不要「连续」。一次请求完成就结束的采集,短效动态足够,成本也低;需要连续几次请求保持同一出口(比如填表、翻页、保持会话)的,才上长效静态。选错了,要么多花钱,要么任务频繁中断。
Q:预算有限,三项成本里先保哪一项?
先保并发。带宽可以靠关掉静态资源、只走接口来压;IP池可以按需小规格起步再扩;唯独并发不够,整个任务的时间窗口会被拉长,人工和机器成本跟着涨,怎么省都省不回来。