长效代理给人的第一印象是省心:IP一直在线,任务挂上去就能跑。但真正跑过连续几天采集的人都碰到过这种情况——IP明明没过期,成功率却一路往下掉。问题往往不在IP本身,而在两件没做对的事:会话没保持住,轮换总是慢半拍。这篇文章就把这两件事拆开讲透,给你一套能直接落地的思路。
先搞清楚:长效IP身上跑着两个时钟
很多人以为长效代理的有效期就是全部,其实一个长效IP身上同时跑着两个时钟。
第一个时钟握在服务商手里:这个IP在你的套餐里能存活多久。长效静态IP通常按天计,到期或被释放就彻底不可用,这个好理解。
第二个时钟握在目标网站手里:这个IP在你采集的那个站点眼里还剩多少信任度。站点风控盯的是行为——请求频率、访问轨迹、Cookie连续性。一个IP哪怕还有5天有效期,你要是一秒钟压几十个请求过去,可能第2个小时它在这个站就提前被拉黑了:响应时间从200毫秒涨到2秒,验证页开始频繁出现,成功率从98%滑到70%。
所以轮换的判断依据不该是"到期了没有",而是"它还好不好用"。两个时钟的区别列出来是这样的:
| 时钟 | 谁在计时 | 到点的表现 | 应对动作 |
|---|---|---|---|
| 套餐有效期 | 代理服务商 | IP直接不可用 | 提前提取新IP补位 |
| 信任度余额 | 目标网站风控 | 变慢、验证变多、成功率下滑 | 指标触发,主动轮换 |
想明白这两个时钟,后面的内容才有落点:会话保持是为了喂饱第二个时钟,让目标站持续信任你;自动轮换是为了在第二个时钟走完之前,把流量平稳搬到新IP上。
会话保持:让目标站觉得你始终是"同一个人"
先说为什么非要保持会话。目标站的风控基本都按"IP + Cookie + 行为"三个维度识别访客。任务跑到一半出口IP变了,Cookie和IP对不上号,轻则登录态失效重头再来,重则被判定为异常访问,同批次任务跟着受影响。
会话保持有三种常见做法,按实现成本从低到高排:
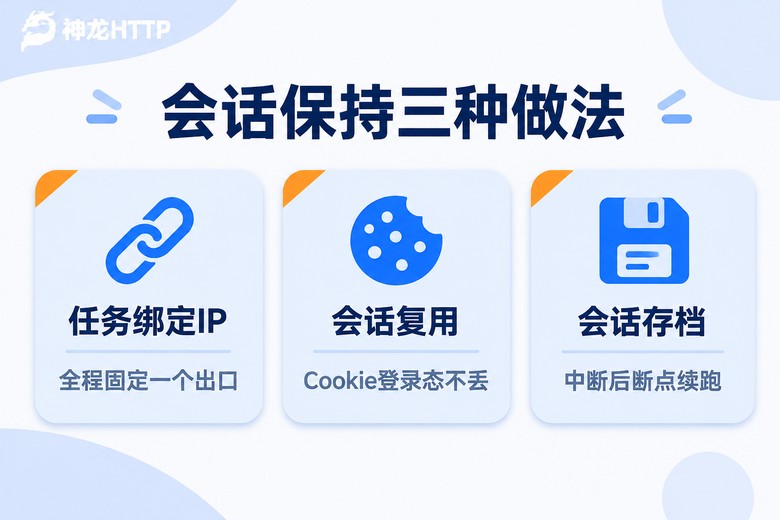
第一种,任务绑定IP。任务启动时从池子里领一个长效IP,整个生命周期只用这一个,不同任务之间不混用。这是最基础的隔离,一个任务出问题不会传染给别人。
第二种,会话复用。用 requests.Session 这类自带Cookie管理的客户端,配合固定代理,目标站看到的就是一个连续访问的"老用户",翻页、登录态都自然延续。
第三种,会话存档。把Cookie和任务断点定期写到本地或数据库,进程重启、机器重启之后加载回来接着跑。这是长任务的保险丝。
| 做法 | 适合场景 | 优点 | 要注意 |
|---|---|---|---|
| 任务绑定IP | 多任务并行 | 互不干扰,问题不传染 | 任务数别超过IP数 |
| 会话复用 | 单任务连续翻页 | Cookie自动维护 | 进程重启会话即丢 |
| 会话存档 | 长周期易中断任务 | 断点续跑 | 换IP后旧Cookie可能触发验证 |
代码大概长这样:
import requests, json

class TaskSession:
    """一个采集任务绑定一个长效IP,会话全程不断"""
    def __init__(self, task_id, proxy_ip):
        self.task_id = task_id
        self.page = 0
        self.session = requests.Session()
        self.session.proxies = {
            "http":  f"http://{proxy_ip}",
            "https": f"http://{proxy_ip}",
        }
        self.session.headers.update({
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"
        })

    def save(self):
        """每翻一页,把Cookie和断点一起落盘"""
        state = {
            "cookies": requests.utils.dict_from_cookiejar(self.session.cookies),
            "page": self.page,
        }
        with open(f"{self.task_id}.json", "w") as f:
            json.dump(state, f)

    def resume(self):
        """进程重启后加载会话,从上次的页码接着跑"""
        with open(f"{self.task_id}.json") as f:
            state = json.load(f)
        self.session.cookies.update(state["cookies"])
        self.page = state["page"]
有个细节要提醒:会话存档在"原地恢复"时很好用,但如果恢复时IP已经变了,带着旧Cookie换新出口,风控严的站点可能会起疑。这种情况宁可重新走一遍登录流程,也别硬扛着旧状态跑。
自动轮换:抢在失效前面,别跟在报错后面
新手做轮换最常见的写法是:请求报错了,在 except 里换个IP重试。这属于跟在失败后面跑——等你发现报错,目标站可能已经把这个IP观察半天了,同池子里的其他任务也跟着遭殃。
更好的思路是让轮换由指标驱动,抢在彻底失效之前动手。盯三个信号:
一是滑动窗口成功率,比如最近50次请求的成功率,低于85%就预警;二是响应时间趋势,比近期均值高出3倍,说明这个IP大概率已被限速;三是内容校验,返回200但页面里找不到关键元素,大概率是验证页,按失败计。
三个信号任意触发,就启动轮换。整套流程是一个四步闭环:
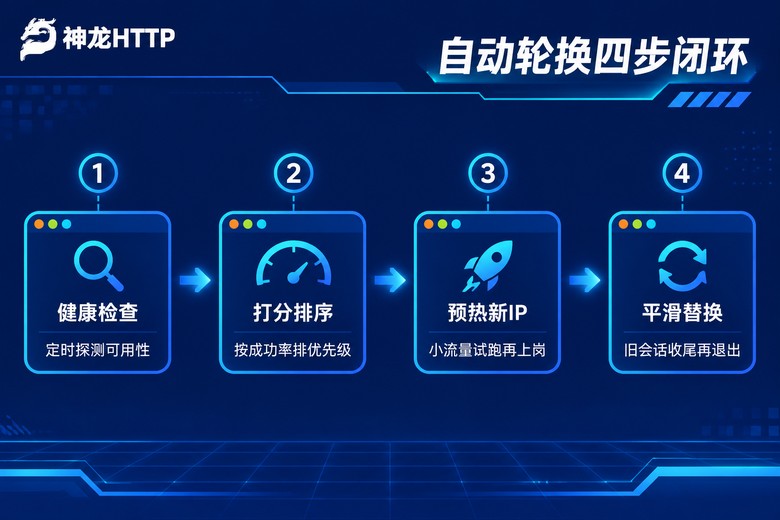
1. 健康检查:后台线程定期用当前IP请求一个轻量页面,采集上面三个指标;2. 打分排序:按滑动窗口成功率给池子里的IP排队,优先级一目了然;3. 预热新IP:从服务商提取新IP后别直接上岗,先小流量试跑几个请求,确认能通、速度正常再转正;4. 平滑替换:旧IP把手头正在处理的请求做完就退休,新任务全部走新IP,不做硬中断,Cookie和任务状态都保得住。
核心代码骨架:
import time
import threading
from collections import deque

class SessionBox:
    """托管一个任务的长效IP会话:打分、预热、平滑轮换"""
    def __init__(self, task_id, build_session, fetch_new_ip, probe_url):
        self.task_id = task_id
        self.build_session = build_session   # 传入IP,返回绑定该IP的会话
        self.fetch_new_ip = fetch_new_ip     # 从代理服务提取一个新IP
        self.probe_url = probe_url           # 目标站点的轻量页面
        self.window = deque(maxlen=50)       # 滑动窗口:最近50次结果
        self.lock = threading.Lock()
        self.session = None
        self._spawn()

    def _spawn(self):
        ip = self.fetch_new_ip()
        self.session = self.build_session(ip)
        self.warm_up()                       # 新IP先试跑,再接正式流量

    def warm_up(self):
        for _ in range(3):
            ok = self._request(self.probe_url)
            self.window.append(1 if ok else 0)

    def _request(self, url):
        try:
            r = self.session.get(url, timeout=10)
            # 内容校验:状态码对,关键元素也得在
            return r.status_code == 200 and "关键元素" in r.text
        except Exception:
            return False

    @property
    def degraded(self):
        if len(self.window) < self.window.maxlen:
            return False
        return sum(self.window) / len(self.window) < 0.85

    def rotate(self):
        """平滑轮换:迁移会话档案,旧会话收尾,新会话接管后续请求"""
        with self.lock:
            cookies = self.session.cookies
            self._spawn()
            self.session.cookies.update(cookies)

def keeper(box):
    """每30秒体检一次,劣化就轮换,上层任务全程无感"""
    while True:
        time.sleep(30)
        if box.degraded:
            box.rotate()
            print(f"[{box.task_id}] 已轮换到新IP,会话档案已迁移")
这段骨架接上你自己的提取接口和任务逻辑就能跑。真正要花心思的是阈值:85%不是铁律,风控严的站点可以放宽到90%,宁可早换;站点宽松就收紧到75%,减少无谓的轮换开销。
三个代价最高的坑,全栽在细节上
坑一:把"长效"当成可以往死里压。再长的有效期也架不住单IP每秒几十个请求。给每个IP设并发上限,多任务分摊到多个IP上,才是长效IP的正确打开方式。
坑二:只看状态码。很多站点被风控时照样返回200,内容却是验证页或空壳。内容校验必须写进健康检查里,比如检查返回的HTML里有没有你预期的那个元素,比单纯看请求通不通靠谱得多。
坑三:轮换时硬中断。正在翻页的任务被一刀切断,断点和Cookie全丢,前面跑的请求白费。平滑替换的价值就在这里——旧会话收尾、新会话接管,任务状态全程落库,轮换对上层任务完全透明。
服务商选对,轮换逻辑省一半力气
前面这套逻辑能跑顺,有个前提:你提取IP的时候池子里有货,IP本身够干净。神龙HTTP的长效静态IP在"干净"这一点上做得比较扎实——3000万+正规授权代理IP储备,来自国内三大运营商正规授权,可用率99.9%、IP纯度99.8%。纯度高,意味着IP到你手里之前没被滥用过,目标站的信任基础好,会话保持能撑的周期自然更长。
另一个对自动轮换特别实用的是它的可视化用量统计与实时监控:个人中心里能直接看到哪个任务异常多、哪个时段成功率在下滑,相当于健康检查的后半段有现成工具帮你盯着,轮换阈值该怎么调,看几天数据心里就有数了。API兼容主流爬虫编程语言,文档和示例代码齐全,上面那段骨架接上提取接口就能用;拿不准策略的时候,技术团队7×24小时在线,直接问比自己试错快。

常见问题
Q:长效静态IP和短效动态IP,采集任务怎么选?
看任务有没有连续性要求。要登录、要翻页、要维持状态的,用长效静态IP配会话保持;只抓一次性列表页、追求吞吐量的,用短效动态IP配高频轮换更省事。不少团队是混着用:长效跑核心任务,短效跑外围补充。
Q:会话保持期间IP突然失效,任务会丢吗?
做了会话存档就不会。Cookie和断点定期落库,IP失效时提取新IP、加载存档、从断点继续即可。注意风控严的站点在换IP后带旧Cookie可能触发验证,这种情况建议重新登录,别硬带旧状态跑。
Q:多久轮换一次比较合适?
不建议按固定时间换,按指标换更合理。滑动窗口成功率低于85%、响应时间翻倍、验证页出现频率上升,任意一个信号触发就该换。风控松的站点一个长效IP跑几天没问题,风控严的可能几小时就得轮换。
Q:怎么判断一个长效IP还"健康"?
三看:看成功率走势,看响应时间趋势,看内容对不对。把内容校验写进探测请求里,返回200但抓不到关键元素也算劣化,这比单纯看请求通不通靠谱得多。