写爬虫的人几乎都撞过同一堵墙:脚本本地测试一切正常,正式开跑后前几百条数据进得很顺,跑到某个节点突然全是验证码页面,再过几分钟连请求都发不出去,日志里躺着一排超时。这时候回头检查代码,逻辑一点毛病没有——问题出在IP上。目标网站看到同一个地址短时间发来成千上万个请求,不拦你拦谁。这篇文章就顺着实际操作的顺序,把代理IP从接入配置到反爬应对的整条链路过一遍。
先弄明白:代理IP在爬虫里到底干了什么
网站判断"来的是人还是程序",最直接的依据就是IP。同一个地址高频访问、访问轨迹整整齐齐像节拍器,基本会被判定为机器行为,轻则弹验证码,重则直接拉黑。
代理IP做的事,是在你和目标网站之间加一层中转:你的请求先发到代理服务器,由它代替你去访问,网站看到的就是代理服务器的地址。再配合一个IP池——也就是一大堆随时可用的代理地址——每次请求或每几次请求换一个出口,单个IP的访问密度就降下来了,被盯上的概率自然小很多。
还有一个容易被忽略的好处:不少网站对不同地区的访客返回的内容有差别。通过代理可以指定提取某个城市的IP,拿到那个地区视角下的数据,做市场研究、价格比对的时候特别管用。
三步接入:把代理写进你的采集代码
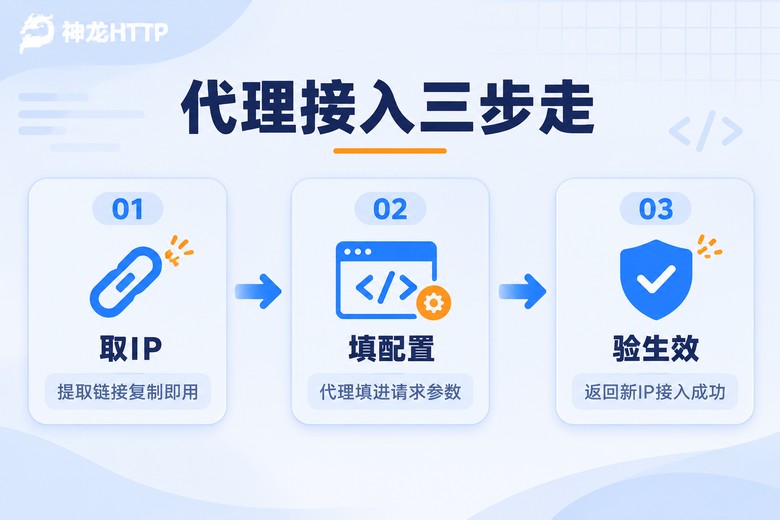
主流服务商的接入方式基本一致,拆开就三步。
第一步,提取IP。在服务商后台生成一个提取链接,程序请求它就会返回一批格式统一的代理地址,一般长这样:http://用户名:密码@IP:端口。把这一步封装成函数,随取随用。
第二步,填进请求。以Python的requests为例,把代理塞进proxies参数就完事了:
import requests

# 从服务商提取接口拿到的一个代理
proxy = "http://账号:密码@113.120.61.18:16816"

proxies = {
    "http": proxy,
    "https": proxy,
}

resp = requests.get("https://www.example.com/list?page=1",
                    proxies=proxies,
                    timeout=10)
print(resp.status_code)
print(resp.text[:300])
第三步,验证生效。拿代理请求一次查询本机IP的接口,返回的地址变了,说明链路通了。如果你用Scrapy,写个中间件统一挂代理更省事:
# middlewares.py
import random

class RandomProxyMiddleware:
    def process_request(self, request, spider):
        if spider.proxy_pool:
            request.meta["proxy"] = random.choice(spider.proxy_pool)
神龙HTTP的提取API兼容主流爬虫语言,文档里直接给了各语言的示例代码,照着改几个参数就能跑通,这一步通常花不了十分钟。
IP池建好只是开始:验证、剔除、补货
很多人以为把代理填进代码就大功告成,跑起来才发现速度越来越慢——池子里的IP是有生命周期的,尤其是短效动态IP,几分钟到几十分钟就失效一批。死IP留在池子里,每次请求都先撞几秒超时,整体速度就被拖垮了。所以池子要养,三件事不能少:
验证:IP进池前先测一遍,能不能连通、延迟多少毫秒,不达标的直接不进池。
剔除:请求失败就把这个IP标记淘汰,别让重试逻辑反复去敲一扇关着的门。
补货:池子水位低于阈值就自动调提取接口补充,保证任何时刻都有新鲜IP可用。
def check_proxy(proxy):
    """进池前花一秒验证,省得把时间浪费在死IP上"""
    try:
        r = requests.get("https://httpbin.org/ip",
                         proxies={"http": proxy, "https": proxy},
                         timeout=5)
        return r.status_code == 200
    except Exception:
        return False
选型上也有讲究,两类IP各有各的用法:
| 对比项 | 短效动态IP | 长效静态IP |
|---|---|---|
| 存活时间 | 几分钟到几十分钟 | 按天计,长期稳定 |
| 适合任务 | 列表页、详情页这类大流量采集 | 要保持登录态、跑长会话的任务 |
| 维护成本 | 失效快,必须配自动剔除 | 省心,但要有节制地用 |
| 成本特点 | 单价低,靠数量取胜 | 单价高一些,胜在稳定 |
大范围的列表页、详情页采集,用短效动态IP走量最划算;需要登录状态、长会话的任务就上长效静态IP。神龙HTTP的短效动态、长效静态、固定IP代理是分开的产品线,按任务性质对号入座就行。
请求发出去还被拦?反爬应对的四个动作
代理配好了、池子也养着,为什么偶尔还是会被拦?因为IP只是反爬体系里的一环,下面四个动作配套做上,被拦的频率会明显下降。
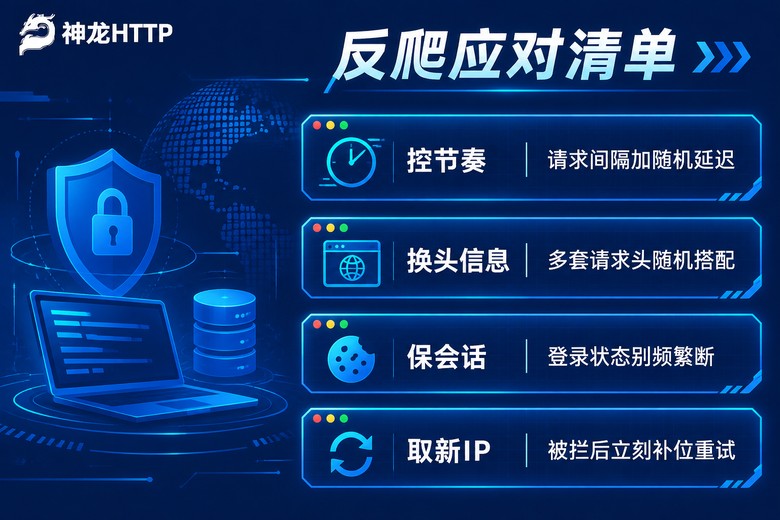
控节奏。请求之间加随机延迟,比如在1到3秒之间取随机数,别让访问间隔整整齐齐。并发也别一上来就拉满,先小规模试出目标网站能承受的量,再稳步往上加。
备好几套请求头。User-Agent、Referer这些字段要像真人浏览器,准备多套组合随机取用,Cookie照常带上,让每次请求看起来都出自正常的浏览过程。
失败重试取新IP。被限制的IP不要恋战,重试时直接取一个新IP顶上,这是代理IP相对单机采集最大的优势。
识别软拦截。有的网站不报错,而是返回200加一个空页面或假数据。校验返回内容的长度和关键字段,发现不对劲就当失败处理。
import time, random

HEADERS_POOL = [
    {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) ..."},
    {"User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) ..."},
]

def fetch(url, get_proxy, retry=3):
    for _ in range(retry):
        proxy = get_proxy()            # 每次重试都取一个新IP
        headers = random.choice(HEADERS_POOL)
        try:
            r = requests.get(url,
                             proxies={"http": proxy, "https": proxy},
                             headers=headers, timeout=10)
            if r.status_code == 200 and len(r.text) > 500:
                return r               # 内容长度也校验,防软拦截
        except Exception:
            pass
        time.sleep(random.uniform(1, 3))  # 间隔加随机数
    return None
出问题别瞎猜:常见症状对照排查
最后给一张排查表,采集任务出状况时先对号入座,能省掉大半试错时间:
| 现象 | 大概率原因 | 处理办法 |
|---|---|---|
| 大面积请求超时 | 池子里死IP太多 | 请求前先验证,失效立刻剔除 |
| 频繁弹验证码 | 单IP请求太密 | 放慢节奏,取新IP顶上 |
| 状态码200但内容为空 | 请求头露馅或触发软限制 | 补全请求头,再降一档频率 |
| 某些城市的数据拿不到 | 出口IP地区太集中 | 提取时指定城市,换个地区的IP再试 |
这张表能覆盖日常九成以上的状况。如果对着表还是查不出原因,优先怀疑两件事:一是目标网站最近升级了反爬策略,二是代理质量本身不过关——后者换个靠谱的服务商,往往立竿见影。
选对服务商,能省一半折腾
判断一家代理服务靠不靠谱,主要看三样:IP储备量决定你有没有足够的余量,可用率决定你要不要反复踩坑,定位精度决定你能不能拿到指定城市视角的数据。
以神龙HTTP为例,它有3000万+正规授权代理IP储备,来自国内三大运营商的正规授权,可用率99.9%、IP纯度99.8%,支持HTTP/HTTPS/SOCKS5三种协议;300多个城市可以精准定位,需要指定地区数据时直接按城市提取。另外它的个人中心里有可视化的用量统计和实时监控,消耗了多少、有没有异常一眼就能看出来,任务挂后台跑着心里有底。真遇到解决不了的问题,技术团队7×24小时在线,半夜任务出状况也有人接。

常见问题
Q:免费代理能用吗?
跑通流程、做小规模测试可以,正式任务别指望。免费IP可用率低、速度慢、稳定性差,采到一半断链很耽误事,时间成本算下来反而不划算。
Q:请求频率压到多少合适?
没有统一答案,取决于目标网站的承受能力。从保守值起步,比如每秒1到2个请求,观察返回情况,没异常再逐步往上调,一出现验证码就退回上一档。宁可慢一点跑得久,也别贪快被整个拦住。
Q:短效IP几分钟就失效,是质量问题吗?
不是。短效动态IP本来就是按"用完即弃"设计的,靠新鲜度和数量取胜。把验证、剔除、自动补货的逻辑写好,失效了立刻获取新的IP,对任务几乎没有影响。
Q:一个采集任务要准备多少IP?
先小规模试跑,记录单个IP在被限制前平均能承受多少请求,用总采集量除以这个数就是基础消耗,再留两成余量应对失败重试。跑几天有了真实数据,估算会越来越准。