周一早上九点,负责数据业务的老周打开后台一看,昨晚的采集任务成功率从98%掉到了六成,日志里铺满超时报错。排查半天发现原因:目标站点收紧了频率限制,公司出口IP被盯上了。这类问题在企业里太常见,而IP在线代理服务就是对应的常规解法——把请求分散到庞大的IP池里,单点压力小了,任务自然跑得稳。
不过很多团队卡在"怎么接"这一步,或者接完了也说不清服务到底稳不稳。这篇文章按真实项目的推进顺序来讲:动手之前想清楚什么、具体怎么接、接完之后怎么验。
接入之前,先把三个问题想清楚
不少团队的流程是这样的:注册账号、要API文档、闷头写代码、跑不通、回头问销售"我们该买哪种"。绕一圈才发现,问题出在没想清楚业务就动了手。按下面的顺序过一遍,能少走很多弯路。
第一,量级。每天大概消耗多少IP?高峰期同时跑多少路请求?以公开数据采集为例,一天几万次请求的任务和一天上百万次的任务,对IP池深度、提取频率的要求完全不是一个量级。这两个数心里有底,后面选规格、算成本都不会虚。
第二,IP要"活"多久。有的任务每次请求相互独立,用完一个就获取新的IP继续;有的业务要保持会话几十分钟不能断;还有一类系统对接场景,对方要求来源IP长期固定。三种诉求对应三种产品形态,选错了接得再顺也是白搭。
| 产品形态 | IP存活特点 | 适合的业务 |
|---|---|---|
| 短效动态IP | 存活时间短,用完即弃 | 高频次公开数据采集、大规模语料获取 |
| 长效静态IP | 存活时间长,状态稳定 | 需要维持会话的业务 |
| 固定IP代理 | 长期固定不变 | 系统对接、来源IP需加入白名单的场景 |
第三,技术栈。主流语言的请求库都支持代理配置,Python的requests、Java的HttpClient、Go的net/http,改动也就几行代码。确认服务商的API兼容你的语言、带示例代码,联调时间能省一大半。
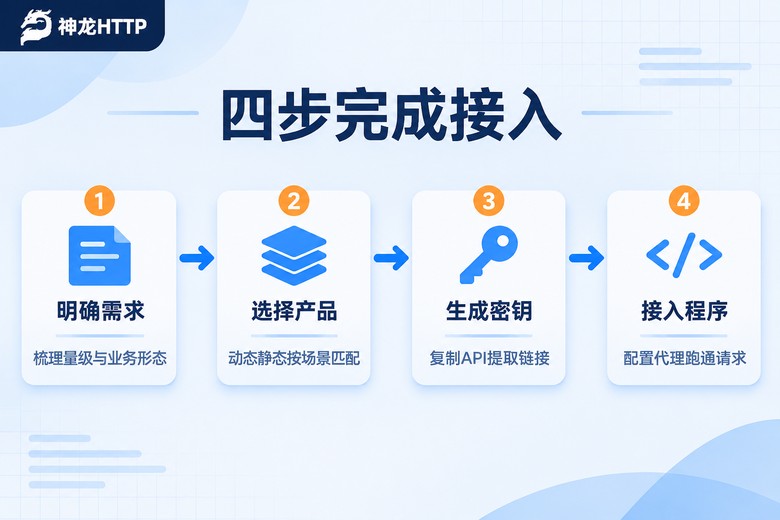
四步接入:从拿到IP到跑通第一个请求
下面用Python演示整个流程,其他语言只是写法不同,逻辑完全一样。
第一步,生成API提取链接。在服务商个人中心创建提取规则,拿到一个专属链接。它就是你的"取IP口",每次访问都会返回一批当前可用的IP,格式一般是"IP:端口"。
第二步,配置进代码。核心就两段:请求提取链接拿IP,把IP塞进代理参数发业务请求。
import requests

# 1. 请求API提取链接,拿到一个代理IP
# 返回内容形如:113.120.xx.xx:4231
res = requests.get("你的API提取链接", timeout=5)
proxy_ip = res.text.strip()

# 2. 配置代理,发起业务请求
proxies = {
    "http": f"http://{proxy_ip}",
    "https": f"http://{proxy_ip}"
}

resp = requests.get(
    "https://目标站点.com/api/list",
    proxies=proxies,
    timeout=10
)
print(resp.status_code, resp.text[:200])第三步,验证链路。看状态码是不是200、返回内容对不对。第一次接入建议多跑几轮,观察不同IP的返回情况,确认稳定了再挂正式业务。用Scrapy这类框架的话,在下载中间件里配置同样的代理参数即可,aiohttp等异步库同理。
第四步,加上容错逻辑。短效IP有存活周期,过期继续用必然失败;代理链路比直连多一跳,超时建议给到10秒左右,别用默认值硬等。程序里做好"失败就重新提取"的处理:
import time

def fetch_with_retry(url, max_retry=3):
    for _ in range(max_retry):
        proxy = requests.get("你的API提取链接", timeout=5).text.strip()
        try:
            r = requests.get(url,
                proxies={"http": f"http://{proxy}",
                         "https": f"http://{proxy}"},
                timeout=10)
            if r.status_code == 200:
                return r.text
        except requests.RequestException:
            time.sleep(1)
    return None
这段逻辑看着简单,却能挡掉八成以上的偶发失败,比人工盯着日志省心得多。
企业里用得最顺的三类场景
公开数据采集。最典型的用法。做价格监测的团队要持续读取各电商平台的公开页面,而目标站点对单一IP的访问频率有限制,靠本机IP跑不了多久就会被限流。挂上代理池,每次请求走不同的IP,任务就能平稳跑完。这里有个细节:控制好单个IP的请求节奏,别把刚到手的IP频率拉太满,质量才能撑得更久。
AI大模型训练的数据准备。训练语料要从大量公开站点获取,数据量动辄以亿计,单机单IP根本撑不住。通过高并发提取代理IP、配合分布式采集集群,数据准备阶段的时间能压缩一个量级。这类场景对IP纯度特别敏感——池子里失效IP一多,重试成本会成倍上涨,选型时纯度指标要重点看。
市场研究。调研团队经常需要对比不同城市的公开信息表现,比如本地生活服务在各地的展示差异。用支持城市级定位的代理服务,可以直接指定某个城市的IP发起请求,拿到的就是当地用户视角下的真实数据,比发问卷、跑现场快得多。
稳定性评估:四个硬指标,加一个容易漏掉的点
宣传页上的数字要看,但更要自己验。建议盯死下面四项。
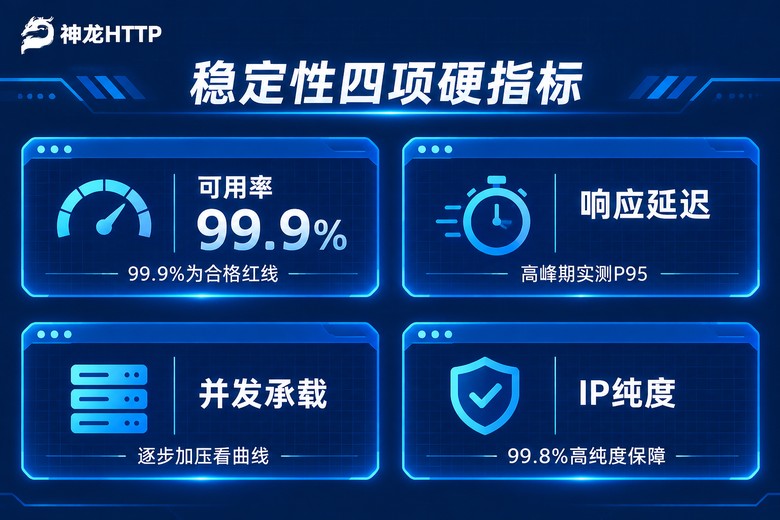
可用率。行业里说得过去的水线是99.9%,一千个IP里不能用的控制在个位数。测法很土但有效:提取100个IP逐个发轻量请求,统计成功率,重复测三轮取平均。神龙HTTP对外标称可用率99.9%、IP纯度99.8%,这两个数属于第一梯队水平,可以拿自己的测试结果去对照。
响应延迟。同样是"能用",200毫秒返回和2秒返回对业务是天壤之别。一定要在业务高峰时段测,同时记录平均延迟和P95延迟,后者更能反映真实体验——平均值好看、长尾一塌糊涂的服务商并不少见。
并发承载。把并发从10路逐步加到100路、500路,盯着成功率和延迟曲线。扛不住的服务,曲线会明显抖动甚至跳水。这一步能直接筛掉一批"参数漂亮、实战拉胯"的供应商。
IP池更新能力。短效动态IP靠流动保持质量,池子更新慢,失效IP会越积越多。隔两三个小时重复提取一次,对比返回结果的重复率,重复率偏高说明池子周转有问题。
还有一个容易被漏掉的点:监控工具。出了问题能不能第一时间发现,比问题本身更影响业务。神龙HTTP的个人中心提供可视化用量统计与实时监控,能识别异常请求、分析使用趋势,接入后建议把监控面板纳入日常巡检,别等业务方来催了才去翻日志。
落地建议:小规模试跑一周再拍板
正式采购前,拿真实业务小规模试跑。圈一个非核心任务接入代理,跑满一周,每天记录可用率、延迟、失败重试次数三个数。曲线平稳再放量,比任何评测文章都可靠。
选型时重点看两样东西。一是资质与资源底子,IP来源是否正规直接决定稳定性上限——神龙HTTP的代理IP来自国内三大运营商正规授权,储备3000万+,覆盖300+城市,支持HTTP/HTTPS/SOCKS5协议,源头的合规和纯度有保障。二是技术支持响应,接入过程难免卡壳,7×24小时在线的技术团队加上完整的文档和示例代码,能把联调时间从几天压到几小时,这笔隐形账很多团队事后的才反应过来。
常见问题
Q: 接入代理IP之后,请求速度反而变慢了?
先查三处:超时设置是不是太短、代理节点离目标服务器远不远、协议用对没有。把timeout放到10秒左右、优先选就近节点,多数情况能明显改善。如果整体都慢,大概率是线路质量问题,直接找服务商技术支持排查,别自己硬扛。
Q: 短效动态IP和长效静态IP,到底选哪个?
看业务要不要维持状态。每次请求相互独立、用完即弃的,选短效动态,池子大、成本低;要保持登录态或长连接的,选长效静态;系统对接、对方要求来源IP固定的,用固定IP代理。拿不准就两种都小规模试跑几天,对比失败率再定。
Q: 提取出来的IP连不上,一般是什么原因?
常见有四种:IP过了存活期、本地网络出方向端口受限、账号认证信息没配对、并发超出了套餐上限。先用curl或telnet单独测这个IP通不通,把问题定位在IP本身还是程序逻辑上,再对症处理。
Q: 怎么快速判断一家服务商的IP质量?
做三组测试就够:提取100个IP逐个请求测可用率;高峰时段测P95延迟;间隔几小时多次提取看重复率。三项数据都过硬,质量基本有保障。记得拿自己的真实业务去验,比看宣传页的数字靠谱得多。