上周帮朋友看一个采集脚本,本地跑得好好的,放到服务器上不到二十分钟,返回全是超时。翻日志才发现,目标站对他那台机器的IP做了频率限制——同一个地址每分钟请求太多,直接不给数据了。这种情况几乎每个写爬虫的人都撞过,解法大家也都知道:给请求套一层代理IP。
但"用代理"和"搞到能用的代理"是两码事。到了2026年,获取渠道不但没变多,反而更集中了,拢共四条路。这篇我把每条路的真实成本、可用率和适用场景摆出来,再手把手演示两条最常用渠道的完整获取流程。
四条主流渠道,先把全景看清楚
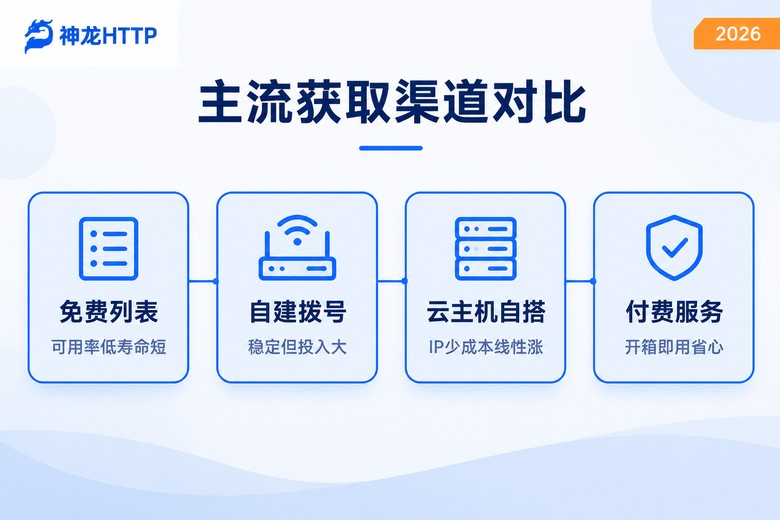
网上讲渠道的文章很多,大多罗列一堆名词,看完还是不知道选哪个。我按"钱花在哪、活谁来干"重新分了下类,其实就四种:
第一类,免费代理列表。一些聚合站和开源项目会持续发布免费IP,零成本,听着很美。真实情况是可用率惨不忍睹——我上个月随手抓了100个做测试,5秒内能连通的只有11个,这11个里大半活不过一小时。拿来练手、写验证逻辑没问题,正经项目别指望。
第二类,自建拨号。自己拉多条宽带,用拨号设备定期重拨获取新的IP。IP质量好、完全可控,但硬件、场地、断线重连的维护全要自己扛,投入数万起步。适合有长期稳定采集需求、预算充足的团队。
第三类,云主机自搭。买若干台云服务器,每台装代理服务端。IP干净稳定,可一台机器就出一个IP,想要一百个就得开一百台,成本随规模线性上涨,只适合小规模固定场景。
第四类,付费代理服务。向服务商按量或按时长购买,通过API提取,拿来就能用。池子维护、验证、调度全由对方负责,是目前绝大多数团队的选择。
| 渠道 | 前期投入 | 实测可用率 | 维护量 | 适合谁 |
|---|---|---|---|---|
| 免费列表 | 零 | 10%~20% | 高,自己写验证调度 | 练手、轻量任务 |
| 自建拨号 | 数万起步 | 90%以上 | 高,硬件加线路 | 长期大项目 |
| 云主机自搭 | 随规模增长 | 95%以上 | 中 | 小规模固定场景 |
| 付费服务 | 按量付费 | 95%以上 | 低 | 绝大多数团队 |
表里的可用率是我和几个做采集的朋友这几年的经验值,不同网站、不同时段会有浮动,看量级即可。
免费渠道完整流程:抓取、清洗、验证、入库
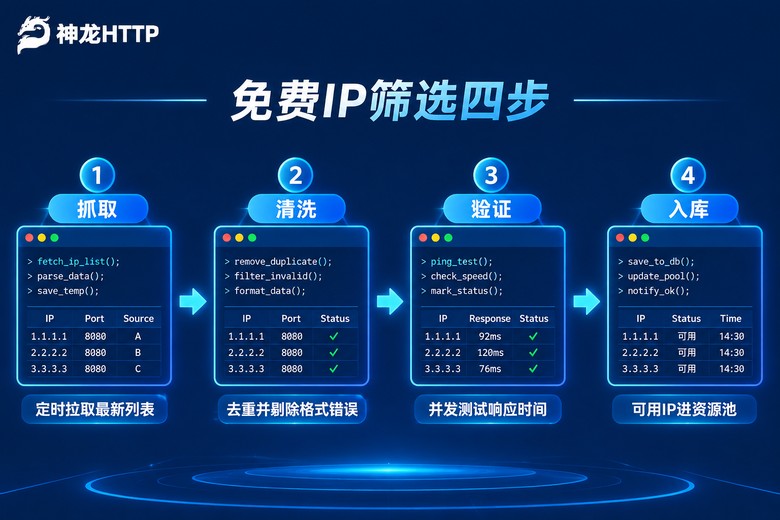
决定用免费IP的话,工作量比想象中大,重心全在验证环节。完整走一遍:
第一步,收集源。把几个免费代理聚合页加进抓取任务,另外留意代码托管平台上一些持续更新的免费IP列表项目,不少是每小时刷新一次的。
第二步,解析清洗。各站页面结构五花八门,建议统一解析成"IP:端口"格式,顺手去重、剔掉格式不完整的。
第三步,并发验证。这是重点。拿到IP不代表能用,必须实际发一次请求确认连通性和响应速度:
import requests
from concurrent.futures import ThreadPoolExecutor

VERIFY_URL = "https://www.example.com"  # 验证地址,可换成你的目标站

def check(proxy):
    """单个代理验证:5秒内能通就算可用"""
    proxies = {"http": f"http://{proxy}", "https": f"http://{proxy}"}
    try:
        r = requests.get(VERIFY_URL, proxies=proxies, timeout=5)
        return proxy if r.status_code == 200 else None
    except Exception:
        return None

raw_list = ["120.1.2.3:8080", "223.5.5.5:3128"]  # 你抓到的列表

with ThreadPoolExecutor(max_workers=50) as pool:
    results = list(pool.map(check, raw_list))

alive = [p for p in results if p]
print(f"原始 {len(raw_list)} 个,可用 {len(alive)} 个")
第四步,滚动更新。免费IP寿命普遍只有几分钟到几小时,验证脚本要定时跑:可用的进资源池,失效的及时清掉,主爬虫只从池子里取,别直接用刚抓的生IP。
整套跑通大概一两百行代码,之后每天的活就是盯着池子水位。学习期和个人小项目够用了;一旦日请求量上了几万次,这套方案的维护成本会迅速反超付费渠道。
付费API接入演示:从提取到跑通不到十分钟
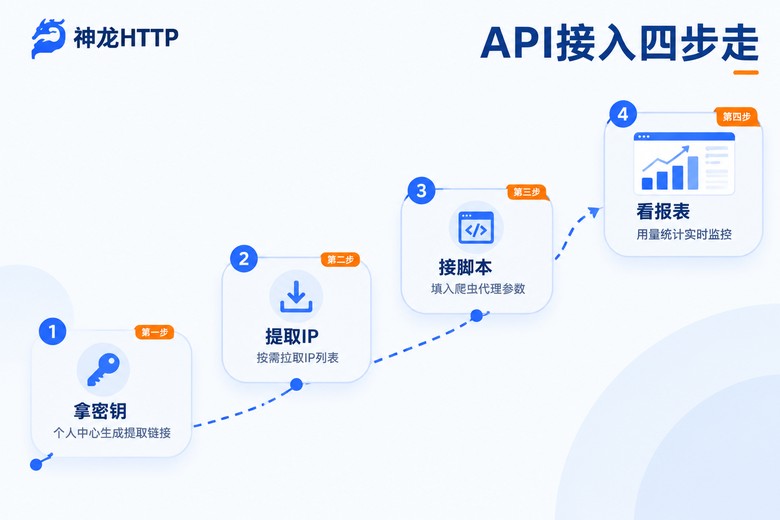
付费渠道把验证和维护的活全接过去了,你要做的只有一件事:通过API把IP取出来,塞进爬虫。以神龙HTTP为例走一遍。
第一步,拿到提取链接。注册后在个人中心配置提取规则——要短效动态IP还是长效静态IP、一次提取多少个、需要哪个协议,配置完系统生成一条专属的API提取链接。
第二步,请求提取。浏览器里打开这条链接就能看到返回的IP列表,实际使用中直接在代码里请求:
import requests

API_URL = "你的API提取链接"   # 在个人中心复制
TARGET_URL = "https://www.example.com/page/1"

def get_proxies(num=5):
    """按需提取一批代理IP"""
    res = requests.get(API_URL, params={"num": num})
    return [line.strip() for line in res.text.splitlines() if line.strip()]

def crawl(url, proxy):
    proxies = {"http": f"http://{proxy}", "https": f"http://{proxy}"}
    return requests.get(url, proxies=proxies, timeout=10)

if __name__ == "__main__":
    pool = get_proxies()
    for p in pool:
        try:
            resp = crawl(TARGET_URL, p)
            print(p, resp.status_code)
        except Exception:
            print(p, "失败,从池子补下一个即可")
第三步,失败自愈。生产环境一定要留兜底:某个IP请求失败,立刻取下一个补上,别让整条任务卡死。上面的例子里留了口子,正式项目可以封装成装饰器或中间件。
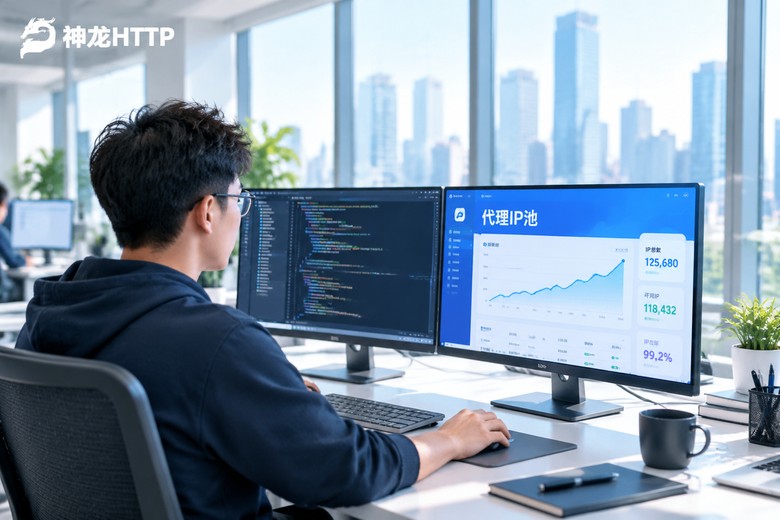
第四步,看监控。神龙HTTP的个人中心自带可视化用量统计和实时监控,今天用了多少、成功率多少、有没有异常消耗,一眼看清。这个功能比想象中重要——出问题时,它能帮你快速分辨是IP的问题还是脚本的问题。
说说我把它留在工具箱里的两个原因。一是IP来源干净:池子由国内三大运营商正规授权,储备量3000万以上,官方标称可用率99.9%、IP纯度99.8%。来源不明的IP用起来提心吊胆,跑着跑着出各种幺蛾子,这点比什么都要紧。二是监控省心:用量和成功率实时可见,异常消耗当场就能发现,不用等账单吓一跳。
挑服务商,盯死这四个硬指标
不管最后选哪家,先过这四关:
1. 授权来源。问清楚IP是不是运营商正规授权。来路不明的IP轻则频繁失效,重则连累你的业务。
2. 可用率与纯度。可用率决定你补货的频率,纯度决定有多少人跟你共用同一个IP。敢把99.9%可用、99.8%纯度白纸黑字写出来的,和只说"能用"的,是两种东西。
3. 定位精度。有些任务要求IP来自指定城市,只能精确到省级的服务商满足不了。城市级定位是基本盘,最好覆盖300城以上。
4. 并发与延迟。高并发场景下,提取接口的限频规则、单IP的并发上限都要提前确认,别等任务跑起来才发现瓶颈卡在提取这一环。
再多提醒一句:先小规模试用再放量。用真实的目标网站跑上一天,可用率和速度的数据,比任何宣传页都准。
常见问题
Q:免费代理IP到底能不能用在正式项目里?
能,但仅限对稳定性要求低的场景,比如调试脚本、小规模抓公开数据。正式项目里,免费IP的可用率和寿命都撑不住,排查故障耗掉的时间远超省下的钱,建议直接走付费渠道。
Q:短效动态IP和长效静态IP怎么选?
看业务对IP存活时长的要求。高频次、短任务、需要频繁获取新IP的场景,短效动态IP更划算;要保持会话、登录状态维持较久的场景,选长效静态IP;要求IP长期完全固定的场景,用固定IP代理。拿不准就各试一小批,看数据说话。
Q:提取到的IP连不上,一般是什么原因?
常见三种:一是提取后放太久,短效IP已经过期,提取后应尽快用掉;二是认证信息没配对,检查账号的授权方式;三是本地网络或防火墙拦了代理端口。如果大面积失败,先去服务商的监控面板看池子状态,再回头排查自己这边。
Q:请求量多大才需要上代理IP?
没有绝对线,经验上单IP每分钟请求超过几十次、或日请求量过万,就该准备了。与其等被目标站限制后手忙脚乱,不如在压测阶段就把代理接入跑通,顺带把失败重试逻辑验证好。