上个月帮朋友复盘他的采集项目,发现一个挺典型的问题:他按"IP越多越好"的思路买了个大套餐,结果项目每天只跑两万多条数据,池子里九成资源白白闲置。也有人反过来,图便宜按最小规格下单,跑到第三天提取频率顶到上限,任务在队列里排着队等IP,进度直接卡死。套餐选得不合适,多数时候不是预算问题,而是没把采集量和套餐规格对上号。这篇文章就把这笔账拆开算给你看。
先把账算明白:你一天到底消耗多少IP
很多人估采集量,只看"要抓多少页面",这个算法漏了一个关键变量:重试消耗。一个页面未必一次请求就能拿到,遇到响应慢、内容不完整的情况,代码里的重试逻辑会自动获取新的IP再试一次。按经验,目标站点校验松一点的,平均1.5个IP能稳定拿下一页;校验严的,一个页面烧掉三四个IP很正常。
所以日IP消耗可以用一个粗略公式估出来:
日IP消耗 ≈ 当日采集页面数 × 单页平均IP消耗(1.5~4)

举例:
当天计划抓 20000 个页面,站点校验较严,按每页 3 个IP算
20000 × 3 = 60000 个IP/天
建议上线前先跑一天小流量,把真实数据记下来。下面这段Python统计逻辑可以直接塞进现有爬虫里,跑完就知道单页平均消耗几个IP:
import collections

stats = collections.defaultdict(int)  # 记录每个页面用了几个IP

def on_page_done(page_id, ip_used_count):
    stats[page_id] = ip_used_count

# 跑完一天后汇总
total_pages = len(stats)
avg_ip_per_page = sum(stats.values()) / total_pages
daily_need = total_pages * avg_ip_per_page
print(f"页面数: {total_pages}, 单页均耗: {avg_ip_per_page:.1f}, 日需求: {daily_need:.0f}")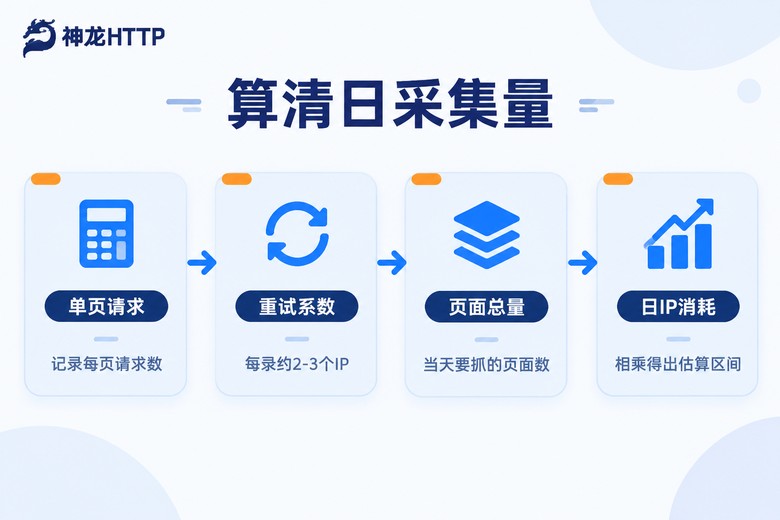
拿到这个数,你就有了选套餐的基准线。后面所有的判断,都围绕它展开。
三类套餐,分别接得住什么样的活
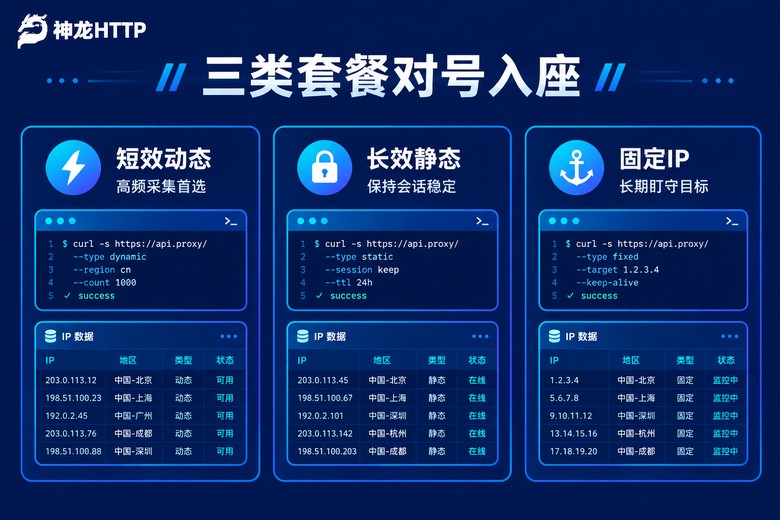
市面上的代理套餐看着五花八门,拆到底就是三类,区别在IP的存活时间和归属方式上:
| 类型 | IP存活时间 | 适合的采集形态 | 量级感受 |
|---|---|---|---|
| 短效动态IP | 几分钟到几十分钟 | 大流量拉取、页面间无需保持状态 | 日消耗几万到几十万 |
| 长效静态IP | 按天到按月 | 要保持会话、连续翻页、有简单校验的站点 | 日消耗几千到几万 |
| 固定IP代理 | 长期固定 | 长期盯少数目标、需要稳定出口 | 量不大但要求稳 |
一个简单的判断办法:问自己"同一个任务里,页面之间需不需要记住彼此"。需要保持状态的,往长效和固定方向选;纯拉取、抓完就走的,短效动态最划算,因为单价摊下来最低,池子也最大。
按量级对号入座:三档配置方案
把前面算出来的日IP消耗套进下面三档里,基本就能锁定规格了。
第一档:日均1万请求以内。典型的是刚起步的采集脚本、周期性的数据核对。这类需求选短效动态IP的最小规格就够,重点不是量,而是先把可用率和响应速度验证好。别一上来就囤大套餐,先跑两周看看真实的消耗曲线再说。
第二档:日均1万到10万请求。这是大多数正经采集项目的主战场。建议短效动态做主力,配一小部分长效静态IP去处理需要会话的页面。到了这个量级要开始盯提取频率上限和并发数——很多套餐的IP总量看着够用,但每分钟提取次数卡着,实际根本跑不满。
第三档:日均10万以上。到了这个体量,比拼的就不是IP数量,而是高并发提取能力和IP池的吞吐。池子必须足够大,否则高频提取下同一个IP会被反复发出去,重复率一高成功率就往下掉。这一档建议直接找服务商确认并发上限和提取方式,按月度用量去谈规格更划算。

比IP数量更该盯的四个参数
同样标着"百万级IP"的两个套餐,实际用起来体验可能差出一倍。下单前把这四项翻出来看清楚:
一是可用率和纯度。可用率99.9%和90%的差距,换算成重试成本非常可观——90%意味着每10次请求就有1次在白白消耗时间和重试额度。像神龙HTTP标称可用率99.9%、IP纯度99.8%,这两个数字直接决定你第一节算出的"单页平均IP消耗"能不能压下来,纯度高的IP意味着更少的验证失败和更低的重复率。
二是提取频率和并发上限。问清楚每秒、每分钟最多能提取多少次,同时能挂多少并发。采集高峰期卡在提取频率上,是"套餐明明够用却跑不动"的最常见原因。
三是定位精度。如果目标数据跟地区挂钩,就要看服务商能不能做到城市级取IP,省得拿到手再自己筛一遍。
四是用量监控。好的服务商后台能看到实时消耗和异常提醒——消耗曲线突然飙高,多半是重试逻辑出了问题,能第一时间发现。神龙HTTP的个人中心里有可视化用量统计和实时监控,异常消耗和趋势变化都看得见,对控制成本很实用。
下单前,先花一天做实测
最后给一条实操建议:不管销售页写得多好看,先按最小规格买,跑24小时实测。重点记录三个数:请求成功率、平均响应时间、实际IP消耗。拿这三个数回头对照第一节的公式,误差在两成以内,说明估算靠谱,可以放心按档位往上加规格。
集成环节的门槛也比想象中低。神龙HTTP的API兼容主流爬虫编程语言,文档里带示例代码,Python、Java这些常见技术栈改改参数就能跑通,实测卡住了技术团队7×24小时在线,直接问就行。它背后是3000万+正规授权代理IP储备,资源都来自国内三大运营商的正规授权,实测阶段可以放心压量去验证。
一句话收尾:套餐不是越大越好,而是让规格贴着真实采集量走。先算账,再分档,最后用实测数据校准——这三步走完,花的每一分预算都在刀刃上。
常见问题
Q: 采集量忽高忽低,波动很大怎么办?
优先选支持规格灵活调整的套餐,量小的阶段不浪费,量大的阶段顶得上去。同时给脚本加一层队列缓冲,把高峰期的请求削平,避免瞬时提取频率顶到上限。
Q: 短效动态和长效静态能混着用吗?
能,而且推荐这么用。主流量走短效动态控制成本,需要保持会话的那部分请求单独走长效静态。代码里按任务类型路由到不同的提取接口就行,两套池子互不干扰。
Q: 怎么判断是套餐质量问题,还是我代码写错了?
做个对照测试:拿同一批页面,先用浏览器逐个手动访问一遍,再走代理跑一遍。浏览器正常、代理失败率高,大概率是IP质量问题,找服务商反馈调整资源;两边都失败,先回头查自己的请求头、频率控制和解析逻辑。
Q: 已经买大了,富余的量怎么用不浪费?
把周期性任务迁过来跑,比如定时的数据核对、历史数据补抓,这类活不挑时效,正好消化富余量。另外多看后台的用量统计,摸清真实消耗节奏后,下一个周期按实际数据调规格。