先搞清楚:提取API到底帮你省了什么事
写过采集脚本的人多半遇到过这种场景:程序跑得好好的,忽然开始大面积超时,翻日志才发现是IP被目标网站限制了。这时候你登录服务商后台,手动复制几条IP填进代码里,撑个把小时又不行了,来回折腾一晚上,正事没干多少。
提取API就是来解决这个重复劳动的。说白了,它是服务商给你的一条专属链接,程序对这个链接发个请求,它就吐回一批当下可用的IP。你不用再登录后台复制粘贴,脚本自己按需去拿,拿到的永远是新鲜的。可以把它理解成一台自动售货机:链接是投币口,参数是你按的按钮,掉出来的饮料就是一条条IP。
这篇文章带你从零跑通一次完整调用:准备什么、怎么请求、参数怎么配、拿到IP之后怎么塞进自己的程序,最后把几个高频报错的排查思路列出来。
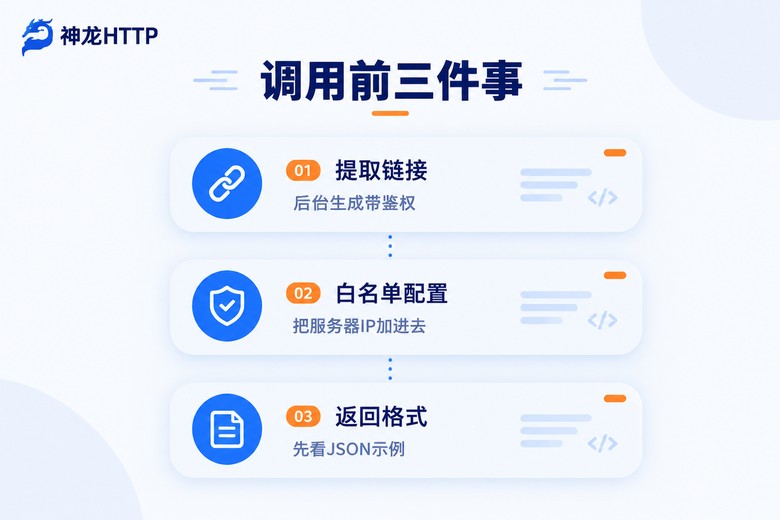
调用之前,先把三样东西备齐
第一样,你的专属提取链接。注册账号、开通套餐之后,在后台的提取页面就能生成这条链接,里面已经带了你的身份信息。它是整个流程的入口,后面所有调用都围着它转。
第二样,鉴权方式。常见的有两种:一种是白名单,把你跑程序那台服务器的出口IP加进后台,之后请求提取链接就不用再报身份;另一种是账号密码,适合本地网络出口经常变的情况——比如公司网络是动态分配的,白名单今天加了明天就失效,这时候账号密码更省心。拿不准就先用白名单,简单直接。
第三样,返回格式说明。别急着写代码,先在文档里找到返回示例,看清楚给你的IP是纯文本一行一条,还是带端口、地区、过期时间的JSON。格式没看明白就动手,后面解析报错能折腾半天。
第一次请求:五分钟把流程跑通
最省事的验证方式,是把提取链接直接粘到浏览器地址栏里回车。屏幕上刷出一串IP,说明账号、鉴权都没问题,通道是通的。确认这点之后,再进命令行:
# 直接请求你的提取链接
# 链接本身已带问号参数时,往后再拼参数用 & 连接
curl "你的提取链接?num=5&format=json"
正常情况下,会拿到类似这样的返回(字段名以你手里文档的示例为准,下面是一种常见结构):
{
  "code": 0,
  "list": [
    {"ip": "113.120.61.28", "port": 8080, "city": "广东深圳", "expire_time": "2025-06-01 15:30:00"},
    {"ip": "121.33.24.107", "port": 3128, "city": "浙江杭州", "expire_time": "2025-06-01 15:31:00"}
  ]
}
用Python解析就是几行的事:
import requests

# 后台复制出来的提取链接,通常自带鉴权参数
api_url = "你的提取链接"

params = {
    "num": 5,          # 这次提取5条
    "format": "json"   # 返回JSON格式
}

resp = requests.get(api_url, params=params, timeout=10)
data = resp.json()

for item in data["list"]:
    print(item["ip"], item["port"], item["city"])
跑通这一步,整条链路就通了:请求链接、拿到IP、解析成结构化数据。剩下的都是在这个骨架上做精细配置。
参数配置逐个讲透
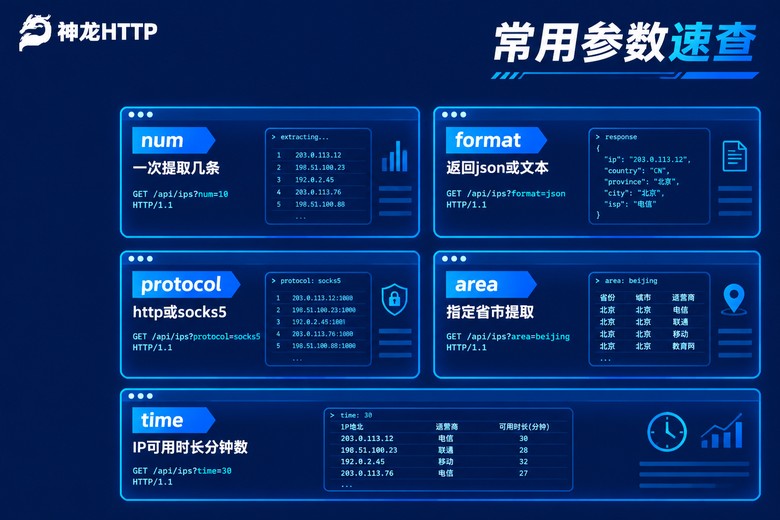
提取链接后面能拼的参数,决定了你每次拿到什么样的IP。下面这几个最常用,思路各家通用,具体参数名以文档里的参数表为准:
| 参数 | 管什么 | 写法示例 | 不写会怎样 |
|---|---|---|---|
| num | 一次提取几条 | num=20 | 按后台默认数量返回 |
| format | 返回格式 | format=json | 多数默认纯文本,一行一条 |
| protocol | 协议类型 | protocol=socks5 | 一般默认HTTP |
| area | 指定地区 | area=广东,深圳 | 从全国资源里随机分配 |
| time | IP可用时长 | time=5 | 按套餐默认有效期给 |
几条实战经验。num别一上来就拉满。先用5条、10条小数量试,确认格式解析、IP可用性都没问题,再按程序的消耗速度往上加,不然一次提一堆,短效IP放到过期就浪费了。
area参数配合业务用价值很大。比如你做的是分城市的公开数据核对,指定城市提取能省掉大量筛选工作。像神龙HTTP这类支持300+城市级精准定位的服务商,地区可以精确到城市这一级,提取链接里写上目标省市,拿到的IP就直接带地区属性。
protocol按目标站点的支持情况选。纯HTTP页面用默认的就够;走HTTPS加密连接的,确认提取的IP支持HTTPS;需要SOCKS5的场景,记得在参数里明确指定,否则拿到的IP协议对不上,连了也白连。
IP拿到手之后,怎么用才不浪费
很多人拿到IP直接往业务请求里塞,结果十次里两三次超时,还以为是IP质量差。更稳的做法是先验再用:
import requests

proxy_ip = "113.120.61.28"
proxy_port = "8080"

proxies = {
    "http": f"http://{proxy_ip}:{proxy_port}",
    "https": f"http://{proxy_ip}:{proxy_port}"
}

# 先拿一个轻量请求试试水,把地址换成你的目标站点
resp = requests.get("https://example.com", proxies=proxies, timeout=8)
print(resp.status_code)
想确认请求确实是通过代理发出去的,把目标地址换成任意一个能回显访问IP的测试页面对比一下即可。
再往上走一层,可以维护一个本地IP池:程序启动时通过API提取一批IP放进队列,业务请求从队列里取用;某条IP请求超时或返回异常,就标记为失效丢掉,同时调一次提取API补位。这样程序手里永远有一池子活水,而不是每次请求都现去提取,速度和稳定性都会好一截。
判断IP失效的信号很简单:连接超时、状态码反复异常、返回内容明显不对。命中任何一条,就换池子里的下一条,别在一条死IP上反复重试。
高频报错排查清单
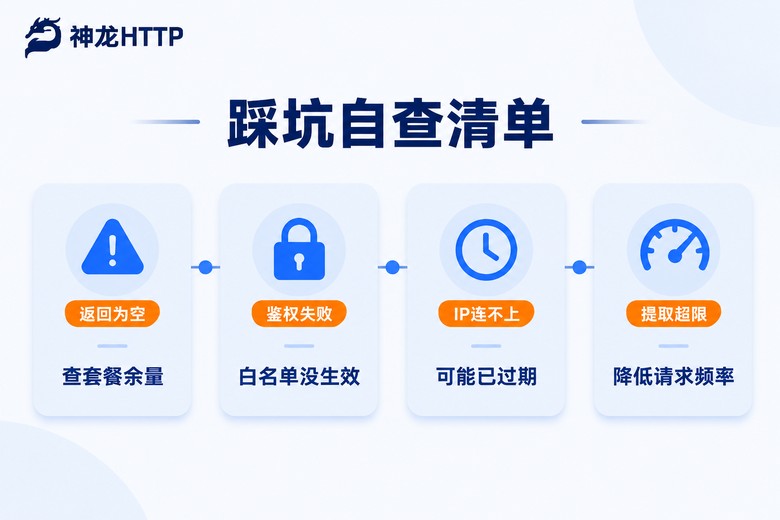
调用过程里卡住,八成逃不出下面这几种情况。
返回为空或提示无可用IP。先查套餐余量是不是用完了,再看单次提取数量是不是超了上限。都正常的话,把参数简化到最少再试一次,排除某个参数写错导致过滤过严。
提示鉴权失败。九成是白名单的问题:要么没加,要么你本地的出口IP变了。办公网络大多是动态分配的,隔几天换一次很正常,重新查一下当前出口IP、更新白名单就好;嫌麻烦就改用账号密码鉴权。
提取频率被限制。有人在脚本里写个死循环不停地请求提取链接,触发了服务商的频率保护。正确姿势是按消耗速度补货,两次提取之间留出间隔,用完一批再提下一批。
IP连不上。短效动态IP本身有生命周期,提取到使用之间隔太久,它可能已经到期。提取和使用的时间差越短越好,最好做到用多少提多少。
还有个容易忽略的点:如果你在后台看到用量曲线突然异常飙升,先检查程序里的重试逻辑是不是写岔了——失败后无限循环提取加重试,几分钟就能把一天的额度烧完。像神龙HTTP的个人中心提供可视化用量统计与实时监控,异常提取一眼就能看出来,每天开工前扫一眼,能省掉很多事后排查的时间。
选服务商时多看两眼什么
提取API只是个通道,用起来顺不顺,最终取决于池子的质量和服务响应速度。挑选时建议重点看两块:一是资源规模和纯度,比如神龙HTTP有3000万+正规授权代理IP储备,全部来自国内三大运营商正规授权,可用率99.9%、IP纯度99.8%,池子干净,程序里因IP质量问题报错的概率就低;二是接入成本,它的API兼容主流爬虫编程语言,文档和示例代码给得全,技术团队7×24小时在线,卡住的时候有人能问,比自己在网上翻帖子快得多。
协议层面确认支持HTTP、HTTPS、SOCKS5,短效动态、长效静态、固定IP这几条产品线按业务节奏选,公开数据采集、AI大模型训练、市场研究这类需求基本都能覆盖。
常见问题
Q: 提取API的调用次数有上限吗?
一般按套餐计费,额度内调用,单次提取条数和调用频率会有约定。写程序前先把这两个数字弄清楚,提取逻辑按"消耗多少补多少"来设计,就不会触顶。
Q: 提取出来的IP为什么有的连不上?
两种可能:一是提取到使用之间隔得太久,短效IP已经到期;二是协议没对上,比如拿的是HTTP的IP却按SOCKS5去连。先验再用,加上自动补位逻辑,这类问题基本能消掉。
Q: 白名单和账号密码鉴权,到底选哪个?
服务器在固定机房、出口IP稳定,用白名单,少一步认证更快;本地开发、网络出口常变,用账号密码,省得天天改白名单。两者也可以并存,按环境分开用。
Q: 能指定只提取某个城市的IP吗?
可以,在提取链接里加地区参数就行,比如area=广东,深圳。前提是服务商支持城市级定位,神龙HTTP支持300+城市精准定位,这类需求直接在参数里配置即可。