先说说为什么值得自己建一个池子
去年帮朋友的公司看他们的采集系统,发现一个挺典型的问题:每次发请求前都去调一遍代理商的提取接口,拿到IP直接用,用废了再取。一天下来光提取接口就调了上万次,慢不说,取回来的IP里还混着不少坏的,请求失败率常年挂在15%上下。
后来我给他们加了一层本地IP池,用Redis存,失败率降到3%以内,提取接口的调用量也砍掉了九成。这层池子干的就是三件事:提前囤、反复验、按好坏分配。现取现用的模式里,这三件事全压在业务请求的路径上,哪件出问题都直接体现为失败。
这篇文章把整套东西拆开讲:数据结构怎么设计、调度逻辑怎么转、代码长什么样。代码可以直接抄走改。
四个数据结构,各管一件事
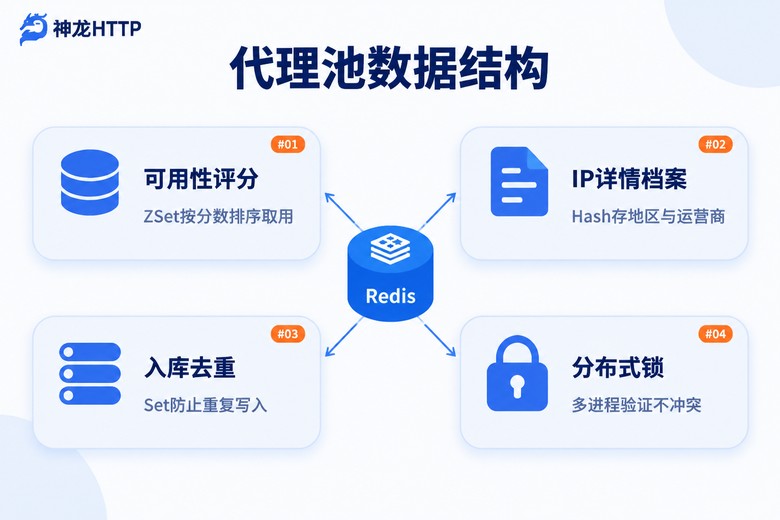
设计之前先想清楚池子要回答四个问题:这个IP好不好用?这个IP是谁?这个IP是不是已经入库了?验证任务是不是只有我在跑?四个问题正好对应四种Redis结构:
| Redis结构 | key 设计 | 存什么 | 干什么用 |
|---|---|---|---|
| ZSet 有序集合 | proxy:pool | 成员是 ip:端口,分数是可用性评分 | 池子主体,按分数取用 |
| Hash 哈希 | proxy:detail:{ip}:{port} | 地区、运营商、协议、入库时间 | 单个IP的档案 |
| Set 集合 | proxy:adding | 正在入库的IP标记 | 防止重复写入 |
| String | proxy:verify_lock | 验证任务的锁标记 | 多进程不重复验证 |
核心是ZSet。ZREVRANGE取Top N是O(logN),ZINCRBY加减分是原子操作,多个进程同时给同一个IP打分也不会互相覆盖。有人图省事把分数塞进Hash的一个字段里,取的时候要自己排序,打分要自己处理并发,绕一圈全是坑。
Hash存详情的价值在调度时才体现:比如目标站对某些城市的出口响应明显更快,有了地区字段,按城市筛IP就是一行命令的事。如果这种需求很频繁,可以再补一组Set按地区建索引,取的时候用ZINTERSTORE求交集,成本很低。
动手写:入库、取用、打分
环境就三样:Python 3.8+、redis-py、一个Redis实例。先写最基础的三个函数:
import redis, requests, time, random

r = redis.Redis(host='127.0.0.1', port=6379, db=0,
                decode_responses=True)

POOL = 'proxy:pool'            # ZSet:成员 ip:port,分数=可用性
DETAIL = 'proxy:detail:'       # Hash 前缀
ADDING = 'proxy:adding'        # Set:入库去重

def add_proxy(ip, port, region='', isp='', init_score=50):
    key = f'{ip}:{port}'
    # sadd 返回0说明已存在,挡住重复入库
    if not r.sadd(ADDING, key):
        return False
    try:
        r.zadd(POOL, {key: init_score})
        r.hset(DETAIL + key, mapping={
            'region': region, 'isp': isp,
            'add_time': int(time.time())})
        return True
    finally:
        r.srem(ADDING, key)

def get_proxy(top_n=10):
    # 高分段随机取一个,避免请求全压在同一个IP上
    top = r.zrevrange(POOL, 0, top_n - 1)
    return random.choice(top) if top else None

def report(key, ok):
    if ok:
        new = r.zincrby(POOL, 1, key)      # 成功加1分
        if new > 100:
            r.zadd(POOL, {key: 100})       # 封顶,防止老IP垄断
    else:
        new = r.zincrby(POOL, -10, key)    # 失败扣10分
        if new < 20:                       # 低分直接清退
            r.zrem(POOL, key)
            r.delete(DETAIL + key)
业务代码里的用法就三行的事:
key = get_proxy()
proxies = {'http': f'http://{key}', 'https': f'http://{key}'}
try:
    requests.get(target_url, proxies=proxies, timeout=8)
    report(key, True)
except requests.RequestException:
    report(key, False)
    key = get_proxy()   # 重新取一个再试
注意取用那步的随机:如果永远取分数最高的那个,所有请求都会砸在同一个IP上,把它加速用废。前10名里随机挑一个,负载摊开了,池子的整体寿命反而更长。
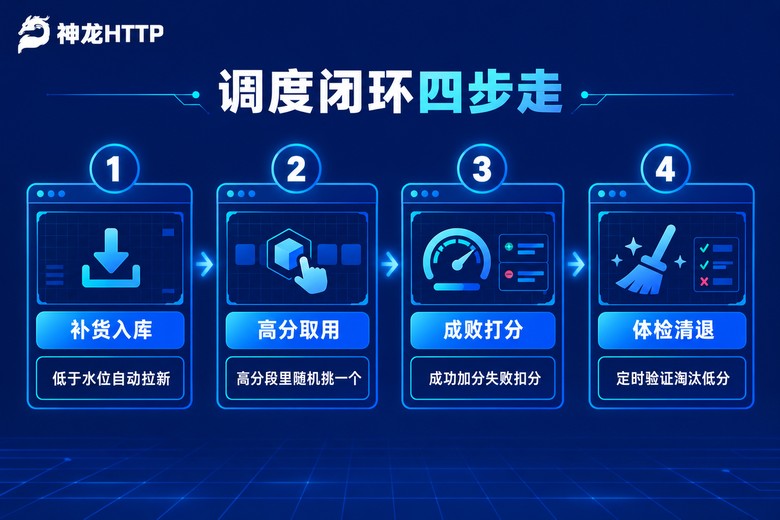
让池子自己转起来:三个后台任务
上面的代码只是池子的骨架,真正让它活起来的是三个后台任务,凑成一个闭环:补货、打分、体检,缺一环池子都会慢慢变成一潭死水。
import concurrent.futures

LOCK = 'proxy:verify_lock'
CHECK_URL = 'http://你的业务域名/ping'   # 用真实业务地址验证最准

def check_one(key):
    proxies = {'http': f'http://{key}', 'https': f'http://{key}'}
    try:
        requests.get(CHECK_URL, proxies=proxies, timeout=5)
        report(key, True)
    except requests.RequestException:
        report(key, False)

def verify_job():
    # 加锁,60秒自动过期,进程挂了锁也不会卡死
    if not r.set(LOCK, '1', nx=True, ex=60):
        return
    try:
        # 只验20~70分的:高分的不用频繁验,快出局的验了也白验
        candidates = r.zrangebyscore(POOL, 20, 70)
        with concurrent.futures.ThreadPoolExecutor(max_workers=20) as tp:
            tp.map(check_one, candidates)
    finally:
        r.delete(LOCK)

def refill_job(min_size=200):
    lack = min_size - r.zcard(POOL)
    if lack <= 0:
        return
    for item in fetch_from_provider(count=lack):
        add_proxy(item['ip'], item['port'],
                  region=item.get('city', ''),
                  init_score=30)   # 短效IP初始分压低
节奏建议:验证任务60秒一轮,水位检查30秒一轮,用APScheduler或者crontab都行。验证只扫中间分数段是个省资源的细节——一个IP如果已经90分,说明它最近表现一直不错,没必要每分钟都去戳它;一个已经25分的IP,离清退线就差5分,验通了也撑不了多久。
我踩过的三个坑
第一,验证地址别用通用检测站。我最早拿公共的回显服务当检测地址,检测全绿,业务请求照样失败。通用站点通了不代表你的目标站能通,有的站对请求特征敏感得多。直接拿业务域名里最轻量的一个页面当检测地址,验出来的结果才作数。
第二,评分参数要跟IP类型挂钩。短效动态IP存活本来就只有几分钟,初始分给50、失败扣10,两三次失败就出局,正合适;长效静态IP给60起步,扣分放宽到5,给它证明自己的机会。一套参数打天下,要么错杀好IP,要么留一堆僵尸。
第三,别过早折腾架构。10万个IP在Redis里也就占几十MB内存,单机绰绰有余。我见过有人池子还没跑顺就上主从加哨兵,问题出在评分规则太狠、IP全被清退光了,跟架构半毛钱关系没有。先把日志打出来,看分数分布,再谈别的。
池子的上限,由IP源头决定
最后说句实话:池子是个筛选器,不是点石成金的魔法。源头IP质量差,调度逻辑写得再精巧,也筛不出能用的东西。所以选供应商主要看三点——可用率、存活时长跟业务是否匹配、提取接口本身稳不稳。
我目前的主力方案接的是神龙HTTP:3000万+正规授权代理IP储备,国内三大运营商正规授权,可用率99.9%,300+城市级精准定位。它的提取接口兼容主流爬虫编程语言,文档和示例代码齐全,接到上面这套池子里,实际要改的只有一个fetch_from_provider函数。个人中心还有可视化的用量统计和实时监控,哪天池子消耗突然异常,对着监控很快就能分清是源头的问题还是自己调度的问题。
常见问题
Q: 短效IP几分钟就失效,建池子是不是白费劲?
不是。短效IP的价值本来就在于高频更新,池子的作用是保证你每次取出来的都是刚验证过、分数够高的那一批。失效是常态,池子让失效发生在池子内部,而不是发生在你的业务请求里。
Q: 初始50分、成功加1、失败扣10、低于20清退,这些数字是拍脑袋定的吗?
有逻辑但确实要调。这套参数的含义是:一个IP平均连续失败两次才出局,成功七八次能爬进高分段。业务对失败极敏感就把清退线提到30;IP成本高想物尽其用就把扣分降到5。跑一天日志看分数分布,再微调一次基本就顺了。
Q: Redis挂了怎么办,池子会丢吗?
池子本质是缓存不是数据库,挂了就重建——调提取接口重新入库,几分钟的事。想更稳可以开RDB持久化,但专门为池子搭主从就过了,成本不划算。
Q: 验证任务越跑越慢,一般是什么原因?
大概率是低分IP没被及时清退,堆在20~70分段反复被扫。先确认清退逻辑真的生效了,再把验证线程数往上调——验证是IO密集型操作,max_workers给到50都没问题。健康的标准是单轮验证控制在30秒以内。