上个月接了个价格监控的活,需要长期维护一个代理IP池。免费源网站收了四十多个,单线程一页一页抓,光采集环节就要一个多小时,后面还压着验证、去重、入库一串活。跑了一周之后我把采集和验证全改成多线程,整套流程压缩到十分钟以内。这篇文章把改造过程完整拆开讲,代码都能直接跑。
先算一笔账:单线程到底慢在哪
先把慢的原因找准。采集代理IP是典型的I/O密集型任务:程序发出请求后,绝大部分时间都在等对方服务器回话,CPU基本闲着。拿我那次的项目算,40个列表页平均每页响应2.5秒,串行跑完光网络等待就是100秒起步;验证环节更夸张,5000条IP逐条测试,单条按3秒算,串行要跑接近三个半小时。
这类任务有个特点:等待时间可以重叠。线程A在等响应的时候,线程B完全可以发下一个请求,多线程正好干这个。下面是我改造前后的实测对比:
| 环节 | 单线程 | 并发后 |
|---|---|---|
| 采集 40 个列表页 | 约 100 秒 | 10 线程约 12 秒 |
| 验证 5000 条 IP | 约 3.5 小时 | 50 并发约 5 分钟 |
| 去重 + 入库 | 3 秒左右 | 基本不变 |
注意最后一行:去重和入库是CPU操作,本来就快,并发对它帮助不大。优化的重点始终在采集和验证这两块,后面的篇幅也围绕它们展开。
线程池并发采集:ThreadPoolExecutor 半小时上手
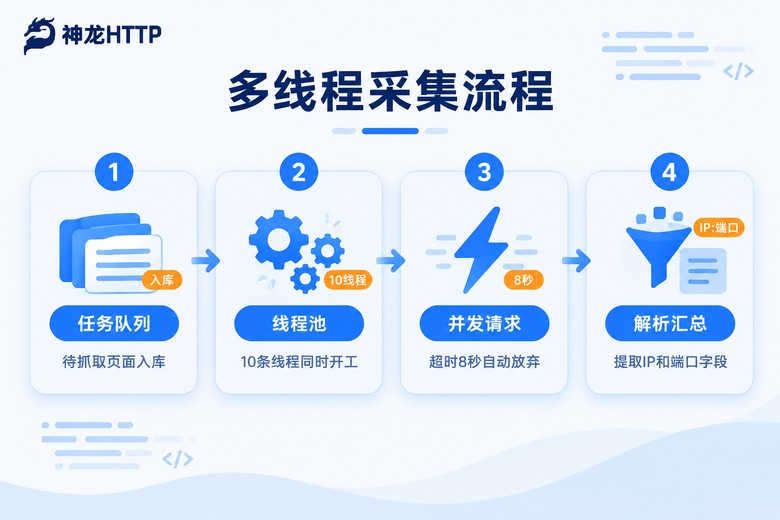
Python标准库里的concurrent.futures就够用,不用装额外的东西。核心思路:把所有待抓取的页面扔进线程池,每个线程负责"请求→解析→提取IP端口",主线程负责收结果。
import requests
from concurrent.futures import ThreadPoolExecutor, as_completed
from bs4 import BeautifulSoup

HEADERS = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}

def fetch_page(url):
    try:
        resp = requests.get(url, headers=HEADERS, timeout=8)
        resp.encoding = resp.apparent_encoding
        return resp.text
    except Exception:
        return None

def parse_proxies(html):
    proxies = []
    soup = BeautifulSoup(html, "html.parser")
    for tr in soup.select("table tr"):
        tds = tr.find_all("td")
        if len(tds) >= 2:
            ip, port = tds[0].text.strip(), tds[1].text.strip()
            if ip and port.isdigit():
                proxies.append((ip, int(port)))
    return proxies

urls = [f"https://free-proxy-source.example.com/list/{i}" for i in range(1, 41)]

raw_list = []
with ThreadPoolExecutor(max_workers=10) as pool:
    futures = {pool.submit(fetch_page, u): u for u in urls}
    for fut in as_completed(futures):
        html = fut.result()
        if html:
            raw_list.extend(parse_proxies(html))

print(f"共拿到 {len(raw_list)} 条原始记录")
三个细节值得单独说:
线程数别贪多。I/O密集型任务10到20个线程是比较稳的区间。开到100个,目标网站大概率把你当成异常流量直接限流,得不偿失。我的习惯是从10开始,盯着成功率逐步加。
timeout必须写。不设超时的请求一旦碰上响应慢的站点,线程会被一直挂住,整个池子的吞吐量被拖垮。
异常要兜住。单个页面失败是常态,try/except包住每个任务,别让一个页面的报错带崩整批任务。
验证也要并发:五分钟筛完五千条IP
抓下来只是第一步。免费源里的IP质量参差不齐,实测5000条原始数据里能用的往往不到两成,验证这步省不得。
验证逻辑很简单:拿着代理去请求一个稳定的测试接口,正常返回的留下,超时或报错的记一次失败。串行验证要跑几个小时,但验证同样是纯I/O操作,照样丢进线程池:
import time
import requests
from concurrent.futures import ThreadPoolExecutor, as_completed

TEST_URL = "http://example.com/get"  # 换成任意稳定的回显测试接口

def check_proxy(ip, port, timeout=5):
    proxies = {"http": f"http://{ip}:{port}", "https": f"http://{ip}:{port}"}
    start = time.time()
    try:
        r = requests.get(TEST_URL, proxies=proxies, timeout=timeout)
        if r.status_code == 200:
            return {"ip": ip, "port": port, "latency": round(time.time() - start, 2)}
    except Exception:
        pass
    return None

valid = []
with ThreadPoolExecutor(max_workers=50) as pool:
    futures = [pool.submit(check_proxy, ip, port) for ip, port in raw_list]
    for fut in as_completed(futures):
        result = fut.result()
        if result:
            valid.append(result)

print(f"验证通过 {len(valid)} 条")
50个并发一起跑,几分钟出结果。这里有两个建议:一是记录响应耗时,同样能用的IP,200毫秒和3秒的体验天差地别,后续取用按耗时排序优先拿快的;二是记录连续失败次数,偶发失败一次很正常,连续失败3次以上的IP基本可以判定失效,直接移除,别让它占着坑。
去重分两层:内存 set 管当下,唯一索引管长期
去重要分两个层面看,很多教程只讲了第一层。
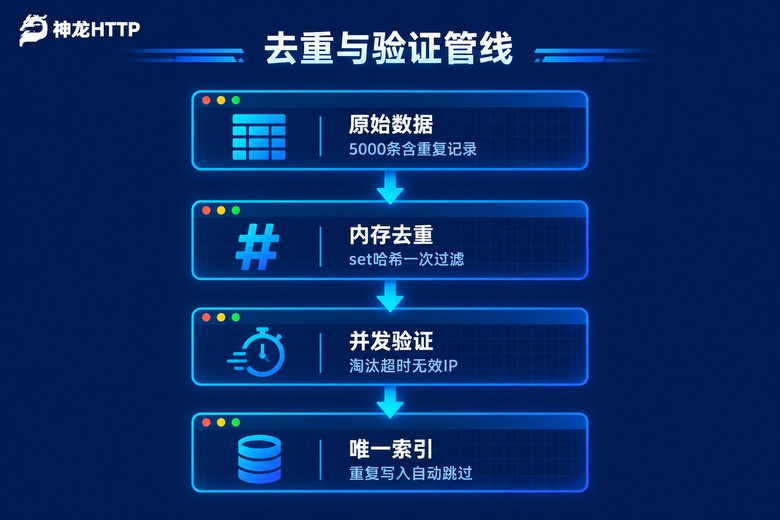
单次运行内去重:同一个IP:端口在多个页面重复出现太常见了,40个页面抓下5000条,去完重可能只剩3000条。用Python内置的set,哈希查找几乎零开销:
seen = set()
unique = []
for item in raw_list:
    key = f"{item[0]}:{item[1]}"
    if key not in seen:
        seen.add(key)
        unique.append(item)

print(len(raw_list), len(unique))  # 5000 3127
跨运行去重:今天的采集结果和昨天的重叠度很高,光靠内存里的set管不了隔天的事。让数据库来把关——给表加唯一索引,重复数据写入时自动跳过:
import sqlite3

conn = sqlite3.connect("proxy_pool.db")
cur = conn.cursor()
cur.executemany(
    "INSERT OR IGNORE INTO proxy_pool (ip, port, latency, last_check) "
    "VALUES (?, ?, ?, datetime('now'))",
    [(p["ip"], p["port"], p["latency"]) for p in valid]
)
conn.commit()
规模再大一点,比如多台机器同时采集,就加一层Redis的set做全局去重,SADD天然幂等,重复添加不会产生冗余数据:
import redis

r = redis.Redis(host="127.0.0.1", port=6379, decode_responses=True)
pipe = r.pipeline()
for p in valid:
    pipe.sadd("proxy:validated", f'{p["ip"]}:{p["port"]}')
pipe.execute()
存储表设计:让IP池自己管好生命周期
表结构直接决定池子好不好用。我的设计是一张表管到底:
CREATE TABLE IF NOT EXISTS proxy_pool (
    id          INTEGER PRIMARY KEY AUTOINCREMENT,
    ip          TEXT    NOT NULL,
    port        INTEGER NOT NULL,
    protocol    TEXT    DEFAULT 'http',
    latency     REAL,
    fail_count  INTEGER DEFAULT 0,
    last_check  TEXT,
    UNIQUE(ip, port)
);
每个字段都有明确职责:
| 字段 | 职责 |
|---|---|
| ip + port(联合唯一) | 去重依据,重复写入自动跳过 |
| protocol | 协议类型,http / https / socks5 |
| latency | 最近一次验证的响应耗时,取用时排序 |
| fail_count | 连续失败计数,超过 3 次移除 |
| last_check | 上次验证时间,超过 30 分钟需重新验证 |
取IP的时候按这个思路查:
SELECT ip, port FROM proxy_pool
WHERE fail_count < 3
  AND last_check > datetime('now', '-30 minutes')
ORDER BY latency ASC
LIMIT 20;
这样这张表就不只是个仓库,而是一个有进有出、有新陈代谢的池子:新IP不断进来,失效IP不断淘汰,留下的始终是能干活的那批。
自建池子还是用现成服务?算笔维护账
最后聊聊很多开发者纠结的问题:自己养池子,还是直接用付费服务?
自建池子的隐性成本比想象中高。免费源可用率普遍只有一两成,意味着每天要多抓几倍的数据量再筛掉九成;源站页面一改版,解析代码就得跟着改;验证调度要持续跑,机器和带宽是长期投入。当练手项目、学并发编程,自建池子价值很大;但如果是正式业务,这些维护时间换算成人力成本,往往比直接买服务更贵。
正式项目我的选择是神龙HTTP这类现成服务:3000万+正规授权代理IP储备,可用率99.9%,IP纯度99.8%,支持HTTP/HTTPS/SOCKS5三种协议。API兼容主流爬虫编程语言,文档和示例代码齐全,几行代码就能接入,验证、清洗这些环节全都不用自己操心。需要指定地区的IP时,300+城市级精准定位直接选就行。个人中心里有可视化用量统计和实时监控,消耗了多少、有没有异常一目了然,技术团队7×24小时在线,遇到问题响应很快。
我的实际做法是两条腿走路:核心业务跑付费服务保稳定,自建池子留着做数据补充和技术储备。前面这套多线程采集加去重存储的方案,正好用来管理自建那部分。
常见问题
Q: 线程开得越多采集越快吗?
不是。I/O密集型任务一般10到20个线程就到性价比拐点了,再往上加,线程调度本身的开销会吃掉收益,请求过密还容易触发目标网站的反爬限制。从10开始逐步调,盯着成功率和总耗时找平衡。
Q: requests 在多线程下安全吗?
requests本身是线程安全的,每个线程独立发请求、或各自用独立的Session都没问题。要注意两点:不要跨线程共享同一个Session对象并发改配置;各线程解析出的数据在自己线程内处理完再汇总,别多处同时改同一份数据。
Q: 去重到底用 set 还是数据库唯一索引?
两个不冲突,各管一段。set负责单次运行内的快速过滤,省掉重复验证的时间;数据库唯一索引负责跨运行去重,保证池子里不出现重复记录。多机部署再加一层Redis set做全局把关,三层下来基本没有漏网之鱼。
Q: 免费源抓来的IP可用率太低怎么办?
低是常态,免费源可用率通常只有10%到20%,所以才需要高并发验证快速筛选,把淘汰成本压到几分钟内。如果业务对稳定性要求高,建议直接用神龙HTTP的付费代理,99.9%的可用率配合按量提取,省下的验证和维护时间远超投入。