先对齐标准:什么样的池子才配叫"高效"
不少人对IP代理池的想象特别简单:写个脚本到处收IP,扔进一个列表,用的时候随机捞一个。头十分钟确实能跑,半小时之后成功率一路往下掉,翻日志一看,池子里一大半IP早就没气了。问题从来不是"有没有IP",而是你不会验活、调度、补货这三件事。到了2026年,目标站点的检测只会更细,粗放的池子连一天都撑不住。
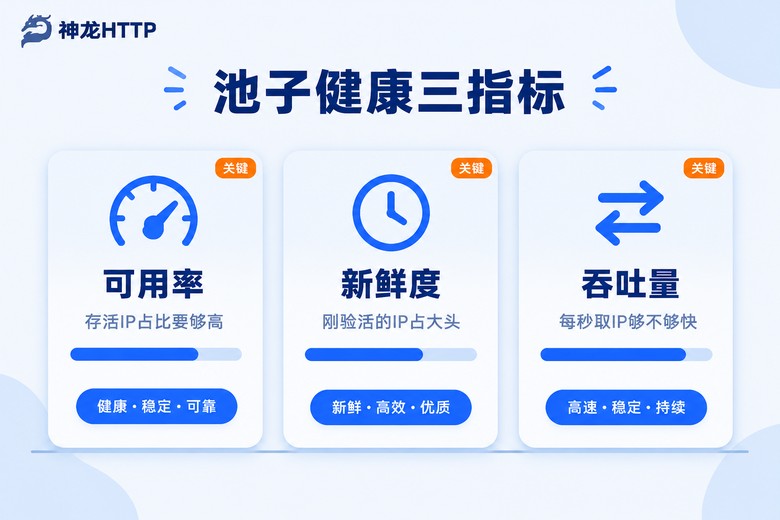
衡量一个池子好不好,就看三个硬指标:
可用率:从池子里取10个IP,至少得有8个能直接用。85%算及格,95%算良好,能做到99%以上,基本就是闭着眼取都不踩坑的水平。
新鲜度:池子里的IP是刚验过的,还是三天前验的?IP的寿命很短,短效动态IP可能几分钟就失效了。新鲜度差的池子,就算可用率数字好看,取出来也是一堆过期罐头。
吞吐量:业务高峰期每秒要从池子里取几十上百个IP,取的动作本身不能卡壳。很多自建池子就败在这一步——不是没IP,是取IP的接口先撑不住了。
| 指标 | 及格 | 良好 | 优秀 |
|---|---|---|---|
| 可用率 | 85% | 95% | 99% 以上 |
| 平均响应时间 | 800ms | 500ms | 200ms 以内 |
| 水位恢复速度 | 小时级 | 分钟级 | 秒级自动补 |
三个指标都达标,才谈得上高效:取出来的IP大概率能用,用的时候不用干等。这两条做到了,后面的优化才有意义。
四层结构搭起来,少一层都撑不久
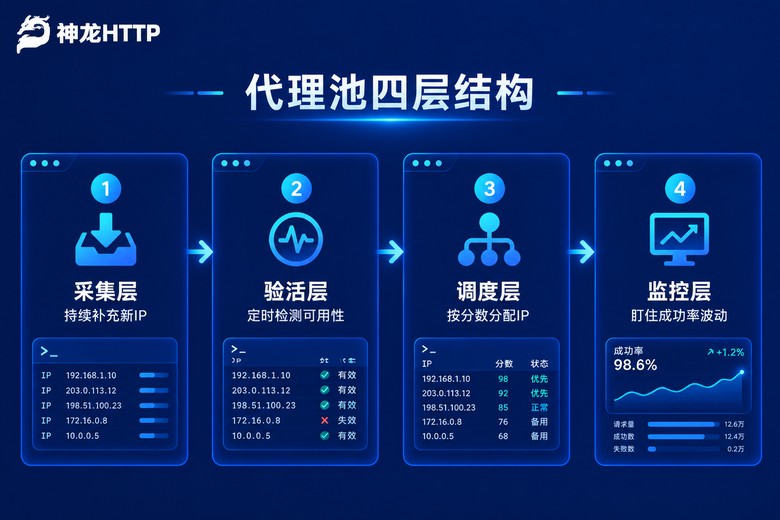
一个能长期跑的池子,拆开看永远是四层,缺任何一层,都会在某个深夜给你惊喜。
采集层负责持续补货。来源可以是服务商的提取API,也可以是自己维护的来源列表,关键是"持续"两个字——IP的消耗速度远比新人想象的快,一个小时的活儿可能吃掉几百个IP。
验活层负责把死IP拦在门外。这里讲究分级:轻量探活只测连通性,几十毫秒一个,高频跑;深度校验走完整请求,顺便把响应时间量出来,低频抽测。两级配合,成本和质量才平衡得住。
调度层决定"这一次请求派哪个IP上场",这是整个池子的灵魂,后面单独开一节讲。
监控层最容易被偷懒省掉。没有监控的池子就是个黑盒,成功率什么时候开始跌的、跌了多少,全靠业务方来骂人才知道。成功率、响应时间、池子水位,这三条曲线必须天天有人看。
验活别一刀切,分两级才省成本
见过最离谱的做法:一万个IP,每个都发完整请求验一遍,一轮跑下来四十分钟,跑到后面,前面验过的又死了一批。验活本身是有成本的,带宽、时间、目标网站的承受能力,都是账。
务实的做法是把验活拆成两级,节奏先按下面这套跑,再根据数据微调:
# 两级验活的节奏,先按这个跑,再按数据微调
LIGHT_CHECK_INTERVAL = 60     # 轻量探活:每 60 秒扫一遍全池
LIGHT_CHECK_TIMEOUT = 2       # 探活超时 2 秒,超时直接标记
DEEP_CHECK_RATIO = 0.1        # 深度校验:每轮随机抽 10% 走真实请求
DEEP_PASS_TIMES = 3           # 连续通过 3 次深度校验,进优质池
POOL_LOW_WATER = 0.3          # 可用池水位低于 30% 触发补货
轻量探活高频扫全池,负责快速把明显死掉的IP踢出去;深度校验低频抽测,连续通过几次的IP才升进"优质池"。调度时优先从优质池取,普通池当备胎。这样深度校验的量被压到十分之一,池子的响应质量反而更稳。
调度是灵魂:轮询不如打分
最常见的调度是轮询——大家排着队,一人一次。听起来公平,实际很糟:好IP和差IP一视同仁,差IP反复浪费你的请求,好IP的能力又没用足。
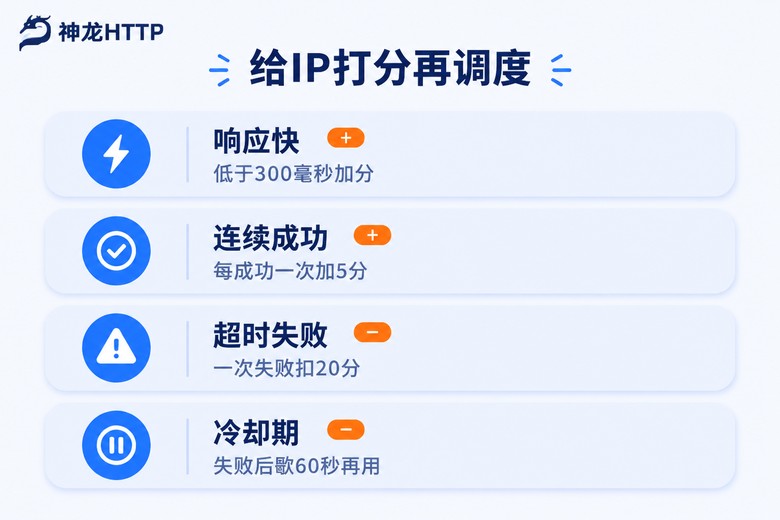
更好的思路是给每个IP打分:成功了加分,响应越快加得越多;失败重罚扣分,扣完进冷却期,分数归零直接移出候选。下面这段代码二十来行,拿来就能跑:
import time
import random

class PoolIP:
    def __init__(self, ip):
        self.ip = ip
        self.score = 60        # 初始分,不高不低
        self.last_fail = 0     # 上次失败的时间戳
        self.streak = 0        # 连续成功次数

    def on_success(self, cost_ms):
        self.streak += 1
        bonus = 5 if cost_ms < 300 else 2   # 响应快多加分
        self.score = min(100, self.score + bonus)
        self.last_fail = 0

    def on_fail(self):
        self.streak = 0
        self.score -= 20                   # 失败重罚
        self.last_fail = time.time()

    def usable(self):
        if self.score <= 0:                # 分数耗尽,移出候选
            return False
        if time.time() - self.last_fail < 60:  # 冷却期,先歇着
            return False
        return True

def pick(pool):
    candidates = [x for x in pool if x.usable()]
    if not candidates:
        raise RuntimeError("池子空了,先补货再跑")
    # 按分数加权随机,而不是永远取最高分
    weights = [c.score for c in candidates]
return random.choices(candidates, weights=weights, k=1)[0]有个细节值得说:取IP用的是按分数加权随机,不是永远取最高分。要是永远取最高分,所有请求都会压到同一个IP身上,再好的IP也会被瞬间打挂。加权随机让高分IP多干活、低分IP少干活,压力摊开,谁都不会过劳。
IP从哪来:自己收不如正规渠道进
池子架构搭得再漂亮,IP质量不行也是白搭。免费来源不是不能用,而是账算不过来:可用率常年两三成,寿命短、来路杂,光维护来源列表和验活的时间成本,就比IP本身值钱了。
正经项目,我的建议一直是把IP这一层交给正规服务商,自己只做调度和业务。比如神龙HTTP,3000万+正规授权代理IP储备,来自国内三大运营商的正规授权,可用率99.9%,取出来的IP基本拿来就能用;接入也省事,API兼容主流爬虫编程语言,文档和示例代码齐全,把自己的调度层接上去就能跑,高并发提取的时候也不卡壳。
| 对比项 | 自己收免费IP | 正规渠道采购 |
|---|---|---|
| 起步成本 | 写采集脚本、维护来源列表 | 拿API文档直接接入 |
| 可用率 | 两三成是常态 | 99% 上下 |
| 维护精力 | 天天补货、天天验活 | 质量由服务商兜底 |
| 来源合规 | 来路不明,风险自担 | 三大运营商正规授权 |
一笔账算下来很清楚:自己收IP省下的是采购预算,赔进去的是人力和项目稳定性。业务量上了规模之后,正规渠道几乎是唯一划算的选择。
上线之后,盯死三条曲线
池子跑起来不等于完事,每天要看的就三样:
成功率曲线:突然下滑,多半是目标站点改了策略,或者优质池被掏空了,先查水位再查IP质量。
响应时间曲线:均值慢慢往上爬,说明优质池在缩水,补货速度跟不上消耗速度。
池子水位:可用IP数量跌破三成就报警,自动触发补货,别等人来点补货按钮。
监控这块如果不想从零搭,神龙HTTP的个人中心自带可视化用量统计和实时监控,消耗趋势、异常波动一眼就能看到,技术团队7×24小时在线,池子半夜出状况也找得到人。
常见问题
Q: 池子要多大才够用?
别贪大。按消耗速度倒推:一天消耗5万个IP,常备两三千个验活通过的IP就够用,重点是补货速度要跟得上。水位跌破三成自动补,比堆一个几万IP的大池子实在得多——池子越大,验活成本越高,死IP占比反而越高。
Q: 验活频率多高才合适?
看IP类型。短效动态IP寿命只有几分钟,探活间隔要压到分钟级;长效静态IP可以放宽到十几分钟一轮。判断标准就一条:验活的成本不能超过IP本身的价值。
Q: 打分参数从哪组开始调?
先用保守值跑:初始60分、快速成功加5分、失败扣20分、冷却60秒。跑两天看数据——好IP总被误踢就把扣分调轻,差IP赖着不走就把冷却拉长。参数没有标准答案,数据说了算。
Q: 想取指定地区的IP怎么办?
自建池子就得在采集层按地区打标、分池存放,工程量不小。选服务商的话重点看定位精度,神龙HTTP支持300多个城市级精准定位,提取时直接带上地区参数,取到的就是目标地区的IP,不用再东拼西凑。