先弄明白:代理IP转API,到底在转什么
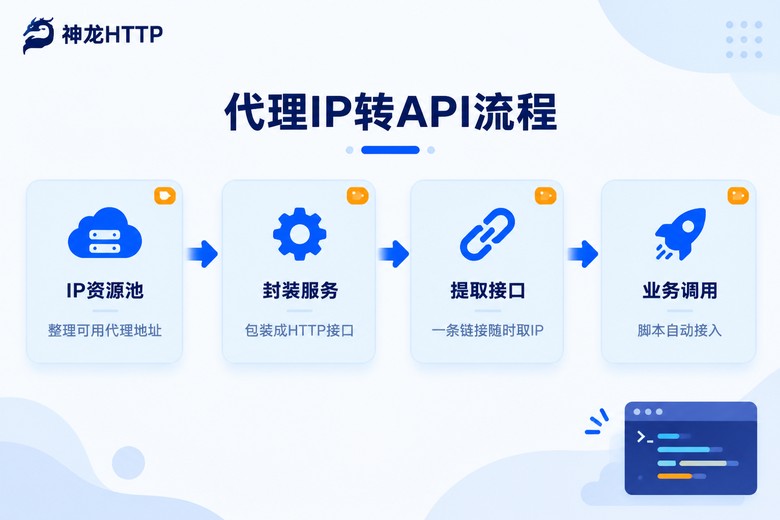
不少人被"转格式"三个字唬住了,其实拆开看特别简单。代理IP本身只是一堆地址,比如txt文件里躺着几百行 113.120.61.18:9091 这样的文本;而API格式,就是给这堆地址装一个"取货窗口"——你的程序发一个HTTP请求过去,它立刻还你一个或一批当前可用的IP。
所以这件事的本质不是格式转换,而是把一份静态的IP列表,变成一个随叫随到的提取服务。转完之后,采集脚本里写一行请求就能拿到新鲜IP,再也不用手动复制粘贴、挨个验活。
落到操作上,路子有两条:一条是自己动手封装接口,一条是直接用代理服务商做好的提取API。两条我都实际跑过,各有各的适用场景,下面挨个说。
方法一:自己封装,二十行代码把IP列表变成接口
适合手里已经有一批IP、想内部分发或者纯粹练手的场景。用Python的Flask框架,几分钟就能跑起来:
from flask import Flask, jsonify
import random

# 实际使用时,从文件或数据库读取你的IP池
ip_pool = [
    {"ip": "113.120.61.18", "port": 9091},
    {"ip": "183.57.42.77", "port": 8080},
    {"ip": "219.135.98.6",  "port": 8000},
]

app = Flask(__name__)

@app.route("/get_proxy")
def get_proxy():
    if not ip_pool:
        return jsonify({"code": 0, "msg": "池子空了"})
    pick = random.choice(ip_pool)
    return jsonify({"code": 1, "data": "{}:{}".format(pick["ip"], pick["port"])})

if __name__ == "__main__":
    app.run(host="0.0.0.0", port=5000)
存成 proxy_api.py,执行 python proxy_api.py,然后浏览器访问 http://127.0.0.1:5000/get_proxy,会返回类似这样的内容:
{"code": 1, "data": "183.57.42.77:8080"}
一个最小可用的提取接口就成了。但用上几天你就会碰到三个绕不开的问题:IP从哪来?失效了谁检测?并发一高接口扛不扛得住?自建方案只解决了"分发"这一环,IP的质量和补给仍要自己操心——这也是多数人最后转向第二条路的原因。
方法二:用服务商的提取API,链接生成就能调
正规的代理服务商(比如神龙HTTP)把上面整套东西做成了标准产品:在后台选好参数,生成一个专属提取链接,浏览器打开就能返回IP,程序里直接请求这个链接即可。常见可配置的参数有这几类:
| 参数 | 作用 | 常见取值 |
|---|---|---|
| 返回数量 | 一次提取几个IP | 5 / 10 / 50 |
| 返回格式 | 文本或JSON,决定解析方式 | json / text |
| IP有效期 | 按业务节奏选短效或长效 | 1~5分钟起 |
| 协议类型 | 匹配目标网站的访问方式 | HTTP / HTTPS / SOCKS5 |
以神龙HTTP为例,它背后是3000万+正规授权的代理IP储备,覆盖国内三大运营商资源,可用率标称99.9%——从接口拿出来的IP基本拿来就能用,省掉了自己养池、验活的大量琐碎活儿。
完整调用示例:取IP、用IP、失败重试一条龙
光看不练容易忘,下面这段Python代码演示标准用法:先请求提取接口拿IP,再带着IP访问目标网站,单个IP失败就改用下一个。
import requests

# 提取链接在服务商后台生成,替换成你自己的
API_URL = "你的专属提取链接"

def fetch_proxies(num=5):
    """从提取接口拿一批IP"""
    resp = requests.get(API_URL, params={"num": num, "format": "json"}, timeout=5)
    return resp.json()["data"]  # 形如 [{"ip":"x.x.x.x","port":8080}, ...]

def crawl(target_url):
    """带代理访问目标网站,失败自动改用下一个IP"""
    for item in fetch_proxies():
        proxy = "http://{}:{}".format(item["ip"], item["port"])
        try:
            r = requests.get(target_url,
                             proxies={"http": proxy, "https": proxy},
                             timeout=8)
            if r.status_code == 200:
                return r.text
        except Exception:
            continue  # 这个IP不行,接着试下一个
    return None

html = crawl("https://www.example.com")  # 替换成你的目标站点
print(html[:200] if html else "本轮IP全部失败,检查提取接口")
三个细节划一下重点:timeout=8 必须加,否则一个卡死的IP能拖住整个流程;except 里的 continue 是容错核心,保证单个IP失效不会中断任务;如果提取的是SOCKS5协议,先执行 pip install "requests[socks]",proxies 里改写成 socks5://IP:端口。正式跑任务时,建议把取到的IP先存进本地队列,消耗到剩余几条再补货,别每次请求都去调提取接口。
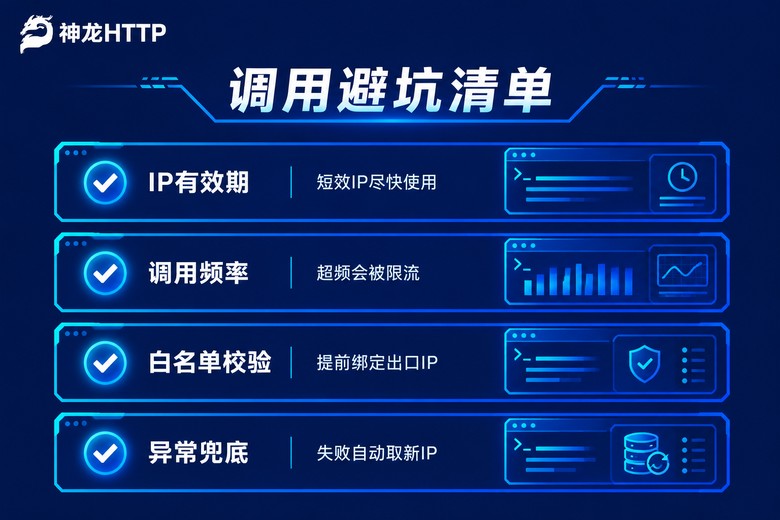
封装和调用路上,最容易栽跟头的五个地方
流程本身不难,坑全藏在细节里。我把被问得最多的几类问题整理成一张表,对照排查能省不少时间:
| 坑 | 典型现象 | 解决办法 |
|---|---|---|
| IP到手就失效 | 刚提取就连不上 | 看清有效期,即取即用 |
| 调用超频 | 接口返回空或报错 | 本地缓存IP,降低提取频率 |
| 白名单没绑 | 提示无权限 | 后台绑定服务器出口IP |
| 协议不匹配 | HTTPS站点握手失败 | 确认代理支持对应协议 |
| 异常没兜底 | 一个IP挂,全任务停 | 捕获异常,自动取新IP重试 |
排查接口问题时,先看返回的错误码和提示文字,正规服务商的报错一般写得很直白。神龙HTTP的个人中心里有可视化用量统计和实时监控,调用趋势、异常情况一眼能看到,比翻日志快得多。
常见问题
Q:自己封装接口和用服务商的API,到底选哪个?
看IP来源。已经有稳定可靠的IP来源、只想做内部分发,用Flask封装半小时搞定;如果IP本身也要自己找、自己验,那直接用神龙HTTP这类服务商的提取接口更划算,IP质量、可用率、并发能力都是现成的,你只管写业务逻辑。
Q:提取接口返回的格式能自定义吗?
能。主流服务商都支持纯文本和JSON,文本格式还能指定分隔符。生成链接时选好格式,代码里对应解析即可。JSON的好处是能带上端口、过期时间等字段,程序处理起来更省心。
Q:为什么刚提取的代理IP,有的就是连不上?
代理IP有生命周期,短效IP可能一两分钟就更新一轮,提取到使用之间隔得越久,失效率越高。两个办法:按需提取、即取即用;代码里保留失败重试逻辑。即便IP池可用率标称99.9%,网络环境瞬息万变,兜底代码永远不能省。
Q:提取接口有调用次数限制吗?
有,一般按每秒或每分钟计,超频后接口会暂时拒绝请求。合理做法是本地维护一个小型IP队列,消耗到阈值再补充,而不是每次访问目标网站都提取一次。拿不准节奏时,看看后台的用量统计曲线,把调用频率调到平稳状态最稳妥。