先把概念捋直:IP池和"提取"是怎么回事
很多人第一次接触代理IP,会被"池""提取""对接"这几个词绕晕。其实拆开看特别简单:IP池就是一个装满可用IP的大仓库,服务商把维护着的IP都放在里面,随时补充新鲜货、淘汰失效货。而"提取",就是你去仓库领货的动作——告诉仓库要几个、要什么类型,仓库回给你一串IP和端口,拿去就能用。
为什么要提取,而不是一直用同一个IP?因为单个IP用久了容易失效:可能被目标网站限了访问速度,可能运营商那边回收了,也可能单纯是到期了。手头有个池子,失效一个就补一个,程序才不会动不动停摆。
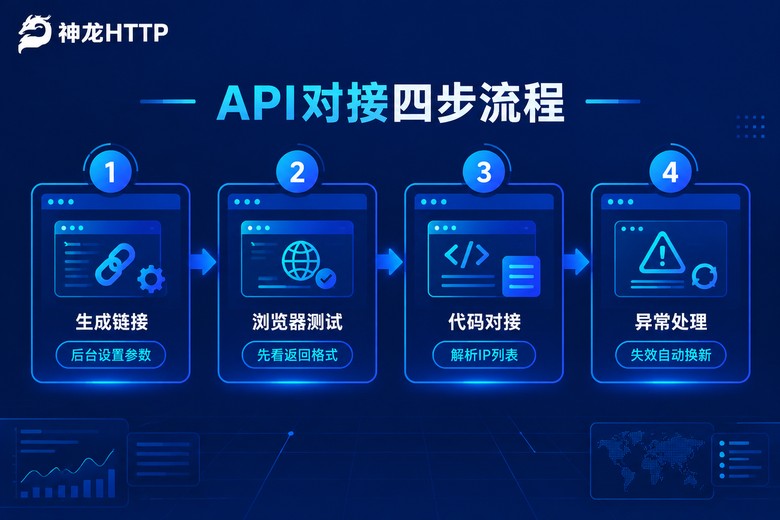
所以整件事的链条是:生成提取链接 → 按参数领IP → 接进自己的程序 → 失效了再领。下面按这个顺序讲。
三种提取方式,一张表看懂区别
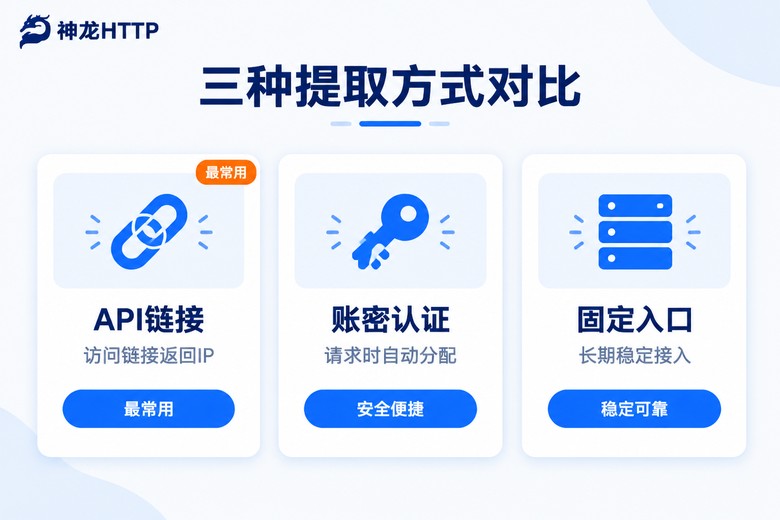
目前主流的提取方式就三种,区别主要在"什么时候拿到IP"。
第一种:API链接提取。平台在后台生成一条专属链接,程序访问这条链接,立刻返回一批当下可用的IP。这是用得最多的方式,适合定时给本地IP队列补货的场景——比如每五分钟领一次,存进队列里慢慢用。
第二种:账密认证提取。不用提前领IP,请求时直接带上用户名和密码,服务商在后台自动分配。好处是完全不用维护IP列表,代码里省掉一层"先领再用"的逻辑。
第三种:固定入口提取。服务商给你一个固定的地址和端口,所有请求都往这个入口发,由它去调度池子里的IP。适合不想折腾、希望接入方式越简单越好的长期任务。
| 提取方式 | 拿到IP的时机 | 适合谁 | 要维护的东西 |
|---|---|---|---|
| API链接提取 | 主动访问链接时 | 自己管理IP队列的程序 | 提取链接 + IP队列 |
| 账密认证提取 | 每次请求时自动分配 | 不想管IP列表的人 | 账号密码 |
| 固定入口提取 | 接入后持续可用 | 长期稳定跑的任务 | 一个固定地址 |
新手我一般建议从API链接提取入手,因为它最直观:链接一访问,IP明明白白摆在返回结果里,出了问题一眼能分清是提取环节还是使用环节的锅。
手把手:从生成链接到跑通第一个请求
下面以神龙HTTP为例走一遍完整流程,其他平台的思路大同小异。
第一步,生成提取链接。注册后在个人中心找到提取API页面,选好套餐类型,系统会生成一条属于你的链接。链接不带参数也能用,但拼上参数会更精准。
第二步,设置参数。常用的就这么几个,直接拼在链接后面:
你的提取链接?num=5&format=json&protocol=http解释一下:num=5表示一次领5个;format=json让结果以JSON格式返回,程序好解析;protocol=http指定协议类型,需要HTTPS或SOCKS5就改成对应的值。部分服务商还支持指定城市、排除已用过的IP等参数,按需添加。
第三步,浏览器先测一遍。别急着写代码,把拼好的链接粘到浏览器地址栏回车,看返回内容。正常应该是一串规整的IP和端口,类似这样:
[
  {"ip": "113.xx.xx.21", "port": 8001},
  {"ip": "220.xx.xx.87", "port": 8002}
]
如果返回的是报错信息,多半是参数拼错或者额度用完了。在浏览器里改,比在代码里调试快得多。
第四步,写代码对接。用Python演示,十几行就能跑通:
import requests

# 换成你在后台生成的提取链接
api_url = "你的提取链接?num=5&format=json"

# 1. 领IP
resp = requests.get(api_url, timeout=10)
ip_list = [(item["ip"], item["port"]) for item in resp.json()]

# 2. 逐个试用
target = "你要访问的目标网址"
for ip, port in ip_list:
    proxies = {"http": f"http://{ip}:{port}",
               "https": f"http://{ip}:{port}"}
    try:
        r = requests.get(target, proxies=proxies, timeout=5)
        print(f"可用 {ip}:{port} 状态码 {r.status_code}")
    except Exception:
        print(f"失效 {ip}:{port},跳过换下一个")
跑通之后,把"领IP"这部分封装成函数,再加上失败重试,就是一个能干活的雏形了。神龙HTTP的提取API兼容主流编程语言,文档里带了Python、Java、Go等示例代码,基本复制过来改个链接就能跑;卡住了他们的技术团队7×24小时在线,响应速度在行业里算快的。
提取回来的IP,这样用才不浪费
对接跑通只是及格线,想让IP池稳定输出,还有几个细节值得花心思。
用多少领多少。别一次提取几百个囤着,短效IP放久了就失效,等于白白消耗额度。按程序的消耗速度定提取量,比如每分钟用掉10个,那就每次领10到15个,留点余量即可。
先验再用。领回来的IP先拿一个轻量请求探探路,能通再丢给业务逻辑。别让业务请求去当探路者,失败一次的代价比校验一次高多了。
失败就换,别硬磕。一个IP连续超时两三次,直接丢弃换下一个。把重试上限写死在代码里,避免程序在一个坏IP上耗到天荒地老。
盯着用量报表。以神龙HTTP为例,个人中心里有可视化的用量统计和实时监控,哪个时段消耗突然变大、成功率有没有异常波动,一眼就能看出来。之前帮朋友排查程序,就是靠报表发现某天下午提取量翻了几倍,最后定位是重试逻辑写错,陷入了循环领IP的死胡同。
常见问题
Q:提取出来的IP能用多久?
A:看你选的产品类型。短效动态IP一般存活几分钟到几十分钟,适合需要频繁获取新IP的采集任务;长效静态IP可以按天计,适合要稳定出口的业务。写代码时别把IP缓存太久,失效就重新提取。
Q:提取频率有上限吗?
A:有。平台会限制每秒或每分钟的提取次数,超了会返回报错。建议在代码里加个间隔,或者用定时任务匀速领取,别在短时间内疯狂请求提取链接。
Q:怎么判断提取回来的IP还能不能用?
A:最简单的办法是拿它去请求一个稳定的目标,几秒内返回正常状态码就算可用。把这套校验做成业务前置的一层,失效IP根本进不了正式流程。
Q:API对接一直报错,从哪里查起?
A:按顺序检查四件事:链接有没有复制完整、参数拼写对不对、账户额度有没有用完、本机网络通不通。四项都没问题还报错,直接找服务商客服,把返回的错误信息发过去,比自己瞎试快得多。