先从一个真实场景说起:爬虫跑着跑着全成了 403
上个月帮朋友盯一个商品价格采集的 Scrapy 项目。前二十分钟一切正常,每秒五六个请求稳稳当当;然后开始冒出 403,接着是连接超时,最后整个任务卡死不动。翻日志才发现,目标站把我们常用的那几个出口地址全拉黑了。
问题不复杂:所有请求都从同一个出口出去,对方一眼就能认出来。解决办法也直白——让每个请求从不同的出口走,挂掉的出口及时淘汰,新的及时补上。这套东西就是代理池。这篇文章不聊概念,直接在 Scrapy 里把它写出来:中间件怎么接、池子怎么打分、多台机器一起跑时怎么共享,代码全部给全。
下载中间件:Scrapy 里挂代理的正确入口
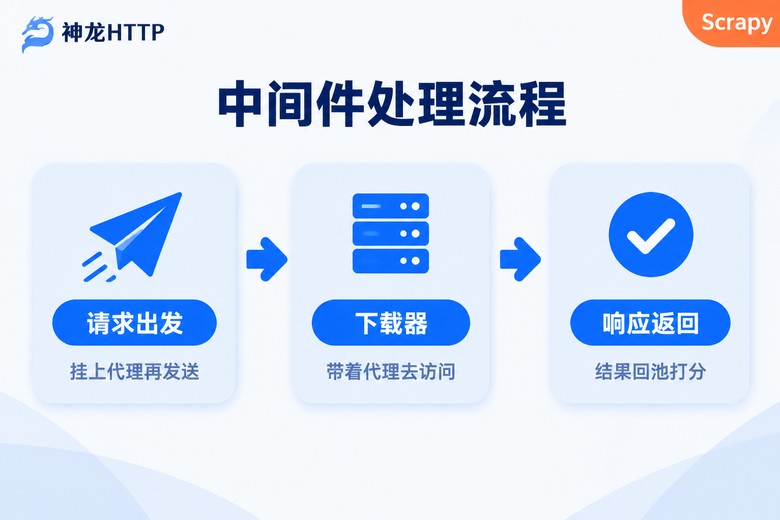
跟代理打交道的地方叫下载中间件(Downloader Middleware)。请求从爬虫出发到真正发出去,中间会路过一串中间件,每个中间件有三个可以下手的时机:
process_request:请求发出之前。在这里把代理塞进 request.meta,这是最核心的一步。
process_response:拿到响应之后。在这里判断这次请求成没成功,给对应的代理加分或减分。
process_exception:请求抛异常的时候。超时、连接被拒都走这里,是淘汰坏代理的关键位置。
还有一个容易踩的坑:优先级数字。settings 里 DOWNLOADER_MIDDLEWARES 的数字越小越先执行,Scrapy 自带的 HttpProxyMiddleware 排在 750,它负责真正读取 meta 里的代理并建立连接。所以自定义中间件的数字必须写在 750 之前,比如 543,不然你塞进去的代理根本没人理。
手写一个带打分的内存代理池
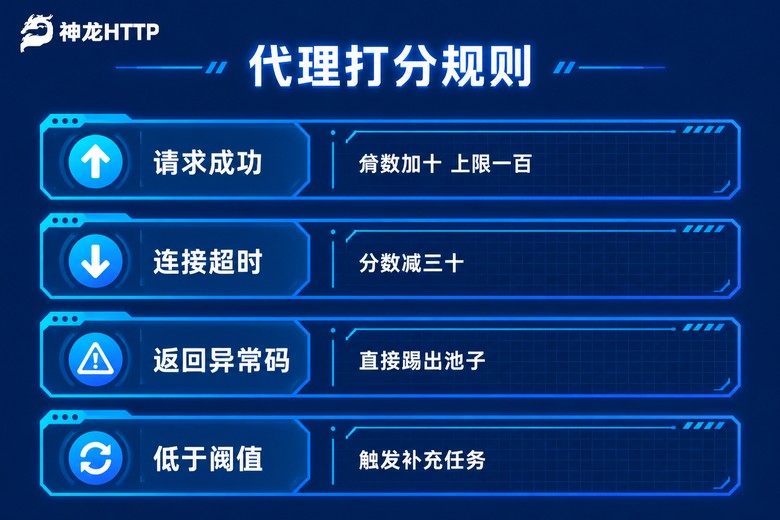
池子的核心逻辑就三件事:存、取、打分。下面这个实现不依赖任何外部服务,一个字典搞定,小项目直接抄走就能用。
# proxy_pool.py
import random


class ProxyPool:
    """内存版代理池:带打分和自动淘汰"""

    def __init__(self, min_score=60):
        self._items = {}          # {代理地址: 分数}
        self._min_score = min_score

    def add(self, proxy, score=100):
        """新代理入池,已存在则保留较高分"""
        old = self._items.get(proxy, 0)
        self._items[proxy] = max(old, score)

    def get(self):
        """随机取一个还活着的代理"""
        alive = [p for p, s in self._items.items() if s >= self._min_score]
        return random.choice(alive) if alive else None

    def feedback(self, proxy, ok):
        """根据请求结果调整分数"""
        if proxy not in self._items:
            return
        if ok:
            self._items[proxy] = min(self._items[proxy] + 10, 100)
        else:
            self._items[proxy] -= 30

    def alive_count(self):
        return sum(1 for s in self._items.values() if s >= self._min_score)


pool = ProxyPool()   # 模块级实例,全项目共用
几个设计取舍说一下。取代理用随机而不是轮询,是因为轮询会让低分代理也被均匀消耗;随机加打分,好代理自然被用得更多。失败减 30 分而不是直接删,是给网络抖动留余地——一次超时可能只是代理临时抽风,连续失败分数跌破 60,get() 自然就不再选它。
中间件接线:完整代码走一遍
中间件负责两头的活:发请求前取一个代理挂上,拿到结果后把情况反馈回池子,失败就换个代理重试。
# middlewares.py
from scrapy import signals

from myproject.fetcher import fetch_proxies_from_api
from myproject.proxy_pool import pool


class ProxyPoolMiddleware:

    MAX_RETRY = 3
    BAD_STATUS = (403, 407, 429, 502)

    def __init__(self, pool):
        self.pool = pool

    @classmethod
    def from_crawler(cls, crawler):
        mw = cls(pool=pool)
        crawler.signals.connect(mw.spider_opened, signal=signals.spider_opened)
        return mw

    def spider_opened(self, spider):
        """爬虫启动时先灌一批代理进池子"""
        for p in fetch_proxies_from_api(count=20):
            self.pool.add(p)
        spider.logger.info("代理池初始化完成,可用 %d 个", self.pool.alive_count())

    def process_request(self, request, spider):
        proxy = self.pool.get()
        if proxy:
            request.meta["proxy"] = proxy
        request.meta["download_timeout"] = 10

    def process_response(self, request, response, spider):
        proxy = request.meta.get("proxy")
        if response.status == 200:
            self.pool.feedback(proxy, ok=True)
            return response
        if response.status in self.BAD_STATUS:
            self.pool.feedback(proxy, ok=False)
            retry = self._build_retry(request)
            if retry:
                return retry
        return response   # 404 之类的正常放行,不是代理的锅

    def process_exception(self, request, exception, spider):
        proxy = request.meta.get("proxy")
        if proxy:
            self.pool.feedback(proxy, ok=False)
            return self._build_retry(request)
        return None

    def _build_retry(self, request):
        times = request.meta.get("proxy_retry_times", 0)
        if times >= self.MAX_RETRY:
            return None
        retry = request.copy()
        retry.dont_filter = True
        retry.meta["proxy_retry_times"] = times + 1
        new_proxy = self.pool.get()
        if new_proxy:
            retry.meta["proxy"] = new_proxy
        return retry
settings.py 里注册,注意 543 这个数字:
DOWNLOADER_MIDDLEWARES = {
    # 数字必须小于 750,才能赶在 HttpProxyMiddleware 之前生效
    "myproject.middlewares.ProxyPoolMiddleware": 543,
}
两个细节值得说。一是 process_response 里返回一个新 request,Scrapy 会把它重新送进调度器再走一遍下载流程,这是手动重试的标准姿势;dont_filter=True 是为了绕过去重,不然同一个地址第二次会被直接丢弃。二是重试上限卡在 3 次,防止池子空了之后请求无限打转。
池子的水从哪来:API 提取与定时补充
池子会越用越少,得有人负责补水。代理服务商都提供提取接口,返回一段文本,一行一个地址,写个定时任务拉取就行:
# fetcher.py
import requests

def fetch_proxies_from_api(count=20):
    """从服务商提取接口拉代理,返回列表"""
    api = "你的提取链接"   # 在服务商个人中心生成
    try:
        resp = requests.get(api, params={"num": count}, timeout=5)
        lines = resp.text.strip().splitlines()
        return [line.strip() for line in lines if line.strip()]
    except requests.RequestException:
        return []
再挂一个 Extension,让它在爬虫运行期间自动补水:
# extensions.py
from scrapy import signals
from twisted.internet.task import LoopingCall

from myproject.fetcher import fetch_proxies_from_api
from myproject.proxy_pool import pool

class PoolRefiller:
    @classmethod
    def from_crawler(cls, crawler):
        ext = cls()
        crawler.signals.connect(ext.spider_opened, signal=signals.spider_opened)
        return ext

    def spider_opened(self, spider):
        LoopingCall(self.refill).start(120, now=False)   # 每 2 分钟查一次

    def refill(self):
        if pool.alive_count() < 15:
            for p in fetch_proxies_from_api(count=20):
                pool.add(p)
EXTENSIONS = {
"myproject.extensions.PoolRefiller": 100,
}补水的节奏看消耗速度,我们的经验是可用数低于 15 就触发,一次补 20 条。服务商的选择上,我们后来用的是神龙HTTP,看中两点:一是提取接口返回格式干净,按行 split 就能用,官方文档里连 Scrapy 的示例代码都给好了,API 兼容主流爬虫语言,接进项目十分钟的事,HTTP、HTTPS、SOCKS5 三种协议都支持;二是底子够厚,3000 万以上的正规授权 IP 储备、官方标称 99.9% 的可用率,实测跑一个通宵基本不用人工干预,池子里的代理很少成批死掉。
多台机器一起跑:把池子搬进 Redis
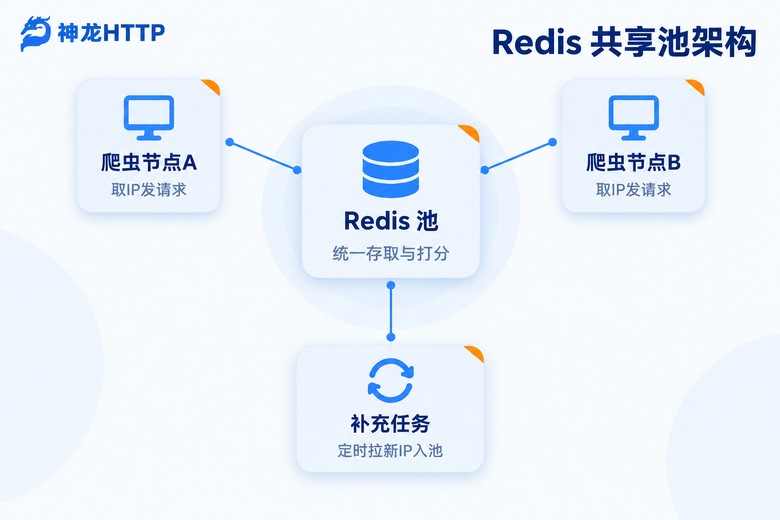
单机版有个明显短板:三台机器各跑各的池子,同一个坏代理可能被三台机器轮流踩一遍。把池子挪进 Redis,所有机器读写同一份数据,问题就没了。用有序集合(ZSet)存,分数就是排序值,打分和淘汰都能用原生命令完成:
# redis_pool.py
import random
import redis

r = redis.Redis(host="10.0.0.8", port=6379, db=0, decode_responses=True)
KEY = "proxy:pool"
MIN_SCORE = 60

def add(proxy, score=100):
    old = r.zscore(KEY, proxy) or 0
    r.zadd(KEY, {proxy: max(old, score)})

def get():
    # 在 60 分以上的代理里,取分数最高的前 10 个随机挑一个
    top = r.zrevrangebyscore(KEY, "+inf", MIN_SCORE, start=0, num=10)
    return random.choice(top) if top else None

def feedback(proxy, ok):
    if not proxy or r.zscore(KEY, proxy) is None:
        return
    if ok:
        r.zincrby(KEY, 10, proxy)
    else:
        r.zincrby(KEY, -30, proxy)
        if r.zscore(KEY, proxy) < MIN_SCORE:
            r.zrem(KEY, proxy)   # 分数跌破阈值,直接清理
中间件代码一行不用改,把池子的几个方法换成这套函数的封装就行。这也是前面坚持把池子写成独立类的原因:接口不变,底层随便换。
三种池化方案摆在一起看
| 方案 | 适合谁 | 优点 | 短板 |
|---|---|---|---|
| 内存字典池 | 单机、日请求几万以内 | 零依赖,半小时写完 | 重启即空,多进程不共享 |
| Redis 池 | 多机分布式、长期任务 | 全局共享,打分淘汰自动化 | 多维护一个 Redis |
| 每次现提取 | 一次性小任务 | 完全不用管池子 | 提取次数翻好几倍,费钱 |
拿不准就从内存版起步,代码写规范点,等真上了多机再平移到 Redis,迁移成本几乎为零。另外不管用哪种,监控都得有——神龙HTTP 的个人中心里有可视化的用量统计和实时监控,提取了多少、成功失败比例一目了然,异常情况能第一时间发现,比自己埋日志省事得多。
常见问题
Q: 代理挂上去了,但请求还是走的本机出口,怎么回事?
九成是中间件优先级写错了。检查 DOWNLOADER_MIDDLEWARES 里的数字,必须小于 750(HttpProxyMiddleware 的位置),否则你设置的 meta 会被跳过。还有一种情况是代理地址少了协议前缀,要写成 http://ip:port 的完整形式。
Q: 池子里的代理死得特别快,几分钟就全没了?
先分清是代理质量差还是目标站封得狠。把 feedback 的失败原因打出来看:超时多说明代理本身不稳,换家服务商试试;返回 403/429 多说明是目标站在限制频率,这时候要调高 DOWNLOAD_DELAY、降低单 IP 的请求密度,光靠换代理救不了。
Q: 打分的加减值怎么定才合理?
没有标准答案,看任务容忍度。短平快的任务可以用"失败即删"的狠策略,保证池子里全是刚验证过的;长跑任务建议温和些,像文中的 +10/-30,给网络波动留缓冲。上线后观察一两天,调到淘汰速度和补充速度基本持平就行。
Q: HTTPS 请求走代理有什么要注意的?
Scrapy 里不用特殊处理,meta 里设了代理后,HTTPS 请求会自动走 CONNECT 隧道。要留意的是服务商那头:确认套餐支持 HTTPS,神龙HTTP 的代理对 HTTP、HTTPS、SOCKS5 都支持,混着用没问题。如果遇到证书报错,检查 SSL 校验配置,爬虫场景一般关闭校验或配置好证书即可。