第一次写采集脚本的人,大多经历过这样的场面:程序前半小时跑得顺顺当当,突然开始成片报错,打开返回结果一看,全是要求验证的页面。折腾半天才发现,问题不在代码,而是请求一直用本机IP,量一大就被目标网站盯上了。
于是开始找代理IP。可打开服务商的产品页,短效动态、长效静态、固定IP……名字一大堆,价格差出好几倍,反而更懵了。这篇文章不讲空概念,直接按你手头的任务类型对号入座,看完就知道该用哪种。
先花两分钟,认清三种IP的脾气
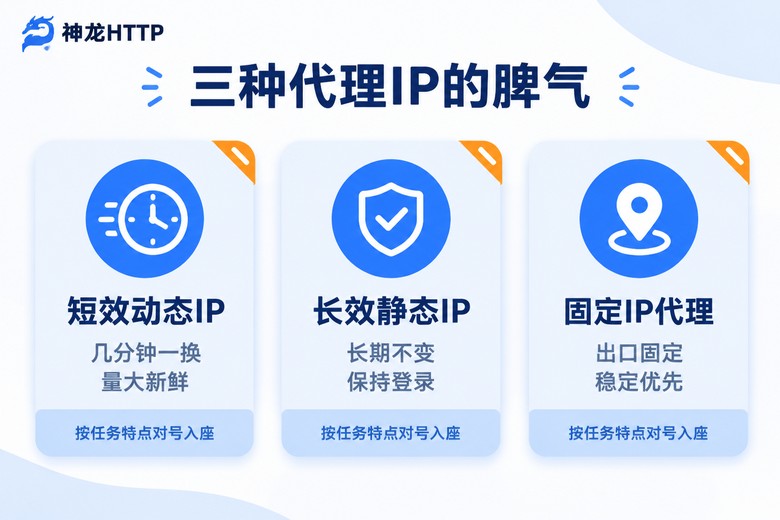
市面上的代理IP产品看着五花八门,剥掉包装,核心就三类,脾气各不相同:
短效动态IP:存活时间短,几分钟到几十分钟不等,到期自动失效,提取一批用一批。优势是量大、新鲜,目标网站不容易把你当成"老熟人"重点照顾。
长效静态IP:一个IP能用一天甚至更久,期间保持不变。适合需要"被记住"的任务,比如登录之后才能看到的页面。
固定IP代理:出口长期固定不动,稳定性优先,适合对连接质量要求苛刻的业务。
| 类型 | 存活时间 | 适合的任务 | 成本 |
|---|---|---|---|
| 短效动态IP | 几分钟~几十分钟 | 大规模、无需登录的采集 | 低,按量用划算 |
| 长效静态IP | 一天以上 | 保持登录态的连续采集 | 中等 |
| 固定IP代理 | 长期固定 | 对出口稳定性要求高的业务 | 相对较高 |
场景一:公开数据大规模采集,选短效动态
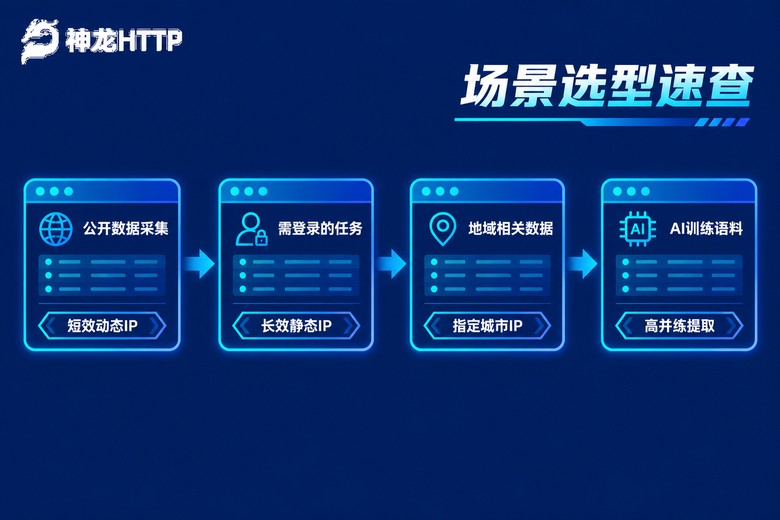
最常见的一类任务:电商价格监控、公开资讯聚合、招聘信息汇总。它们有三个共同点——页面不需要登录、请求量大、要连续跑很久。
这种场景下,短效动态IP是性价比最高的选择。逻辑很直白:请求量大,单个IP用久了容易触发频率限制,那就让它"用完即走",每批请求取一批新IP,把压力摊到海量IP上,单打独斗变成车轮战。
实际操作中有两个细节值得注意:
一是轮换频率别拍脑袋定。有人以为换得越勤越好,其实如果目标网站靠Cookie和访问行为识别访客,换太勤反而显得反常。稳妥的做法是:让同一个IP跑完一个完整的页面会话再取新IP,或者摸清对方的限制阈值后,留出20%左右的安全余量来定轮换周期。
二是失败重试要取新IP。请求失败时,别拿着同一个IP硬重试,先获取新的IP再试一遍,能省掉大量无效等待,成功率也明显更好看。
场景二:要登录才能看的数据,选长效静态
第二类任务复杂一点:采集前得先登录账号,比如商家后台的订单数据、会员专属价格。这类任务最怕IP跳来跳去——账号刚在A城市登录,五分钟后请求又从B城市发出来,任何风控系统都会觉得不对劲,轻则弹验证,重则把账号限制住。
所以这种场景要用长效静态IP,让整个采集周期内出口保持不变,模拟一个正常用户"固定在一台设备上操作"的状态。如果任务涉及多个账号,尽量让每个账号固定使用同一个出口,别混着来。
场景三:数据跟地域挂钩,选城市级定位
有些数据天生带地域属性:本地生活服务的门店列表、不同城市的促销活动、区域化的搜索排序。你在北京采到的结果,跟深圳用户看到的可能完全是两回事。
这类任务的关键不是IP数量,而是定位精度。选服务商时要确认能不能指定到城市级别。像神龙HTTP覆盖300多个城市,可以按需提取指定城市的IP——采哪个地区的数据,就用哪个地区的出口,拿回来的结果才对得上。
提醒一句:任务开跑前先测一下定位。拿到IP后访问一个能显示归属地的页面,核对返回城市是否和申请的一致,别等跑完了才发现城市对不上,白忙一场。
场景四:AI训练语料与超大规模采集,看并发和可用率
给大模型准备训练语料、做行业级别的数据盘点,量级和普通采集不是一个概念——单日请求量动辄千万级,一跑就是几周。这个量级下,考察服务商的维度要换一换:
可用率:99.9%和95%放到千万级请求里,差距是几十万次失败请求,以及背后对应的人工处理时间。提取速度:IP消耗快,补充速度跟不上,任务就会"断粮"。池子规模:3000万以上的储备量,跑长周期任务才不容易重复撞车。
一张表看懂怎么选
| 你的场景 | 推荐类型 | 重点看的指标 |
|---|---|---|
| 电商价格、公开资讯等大规模采集 | 短效动态IP | IP池规模、可用率 |
| 后台数据、需登录的页面 | 长效静态IP | 稳定性、存活时长 |
| 本地生活、区域化数据 | 城市级动态IP | 定位精度、覆盖城市数 |
| AI语料、行业大盘数据 | 短效动态+高并发提取 | 并发能力、提取速度 |
选定之后,接入其实很简单
以神龙HTTP为例,它的提取API兼容主流爬虫编程语言,文档里带示例代码,把取到的IP填进请求就能跑。一个最简的Python示例:
import requests

# 从API提取到的代理IP(示例格式)
proxy = {"http": "http://用户名:密码@ip:端口",
         "https": "http://用户名:密码@ip:端口"}

resp = requests.get("https://目标网站.com/data",
                    proxies=proxy, timeout=10)
print(resp.status_code)
实际项目里再包一层:提取IP、校验可用性、失败取新IP重试,一个耐跑的采集骨架就有了。另外建议把服务商后台的用量统计用起来——神龙HTTP的个人中心有可视化用量监控,每天消耗多少、成功率多少一眼可见。发现成功率突然往下掉,多半是目标网站调整了限制策略,及时调整比闷头硬跑省事得多。
三个新手容易踩的坑
坑一:只比价格,不看纯度。纯度低的池子里混着大量被用过的IP,取回来就是各种异常。神龙HTTP的IP纯度做到99.8%,背后是国内三大运营商正规授权的资源,这类指标比单价重要得多。
坑二:协议不匹配。目标网站是HTTPS,你买的代理却不支持,请求全挂。下单前确认协议类型,HTTP/HTTPS/SOCKS5至少要覆盖你需要的那个。
坑三:没有重试机制。再好的IP池里也会有失效的个体,脚本里一定要有"失败取新IP重试"的逻辑,这是任务能不能长时间稳定跑的分水岭。
常见问题
Q: 免费代理IP能用于数据采集吗?
能跑通,但不建议用在正经任务上。免费IP可用率低、速度慢、归属地不可控,采到一半失效是常态。学习练手可以试试,生产任务还是用付费的正规服务,成本其实没想象中高。
Q: 短效动态IP多久取一次新的比较合适?
没有标准答案,取决于目标网站的限制策略。经验值是:普通页面按"一个IP跑完一个完整会话"来换;有明确频率限制的站点,按限制阈值的八成设置轮换周期。正式跑之前先小规模试半小时,观察异常率再定。
Q: 采集中途IP突然大量失效怎么办?
先到服务商后台看监控数据,分清是IP池的问题还是目标网站的问题。如果IP本身可用率正常,大概率是对方调整了限制规则,这时要放慢请求频率、完善请求头,必要时直接找技术支持——正规服务商都有7×24小时的技术团队,别自己硬扛。
Q: 怎么判断一家代理服务商的IP质量?
看三个硬指标:可用率(99.9%属于第一梯队)、IP纯度(决定拿到手的IP干不干净)、归属地精度(能不能定位到城市)。更重要的是先试用,拿真实业务小规模跑一轮,比看任何宣传数字都靠谱。