从一个常见的崩溃现场说起
凌晨一点,采集脚本还在跑,你躺在床上刷手机,突然收到告警:任务成功率从98%掉到了30%。打开日志一看,满屏都是连接超时。原因不难猜——目标网站把你的常用出口地址限流了,同一个地址请求太频繁,谁都会被盯上。
这时候如果你手里有一筐轮流干活的IP,情况就完全不一样了:这个被限速了,脚本自动取下一个新IP来顶上,任务照跑不误。这一"筐"IP,就是大家常说的代理IP池。这篇文章就把它彻底讲透:它是什么、怎么搭、日常又该怎么养。
代理IP池到底是什么
说白了,代理IP池就是一个随时补充、随时淘汰的可用地址仓库。你可以把它想象成一个鱼塘:新IP从各个渠道的进水口游进来,检测程序定期"捞"一遍,不活跃的清出去,活跃的留下继续干活。你的业务程序不直接面对目标网站,而是先到塘里领一个IP,通过它去发请求。
为什么要费这个劲?单个IP的寿命天然就短,尤其是短效动态IP,可能几分钟到几小时就换了。业务要想不间断,就不能押宝在某一个地址上,而是依赖"一批地址 + 一套管理机制"。池子解决的不是"有没有IP"的问题,而是"永远有能用的IP"这个问题。
拆开看:一个IP池的四个核心部件
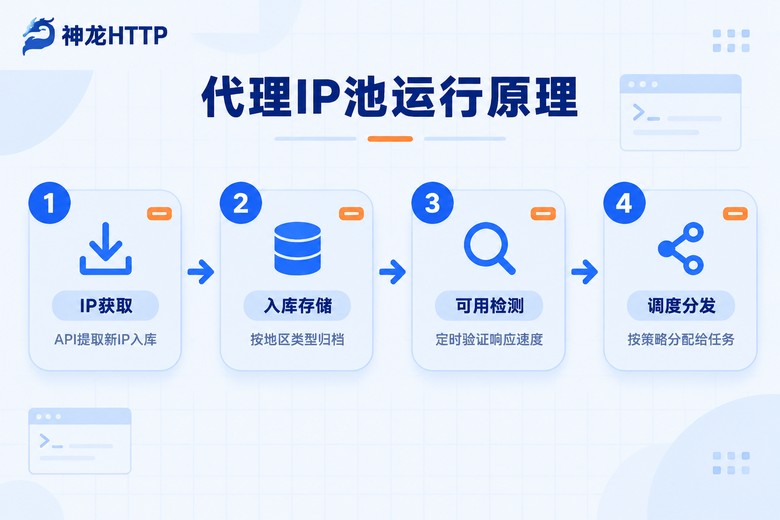
很多教程把IP池讲得很玄,其实拆开就四个部件,缺一个都转不起来。
1. 获取:IP从哪来。两条路子,一是写爬虫去网上收集免费公开的代理地址,成本为零,但质量参差不齐,一百个里能用的常常不到十个;二是从正规服务商的API接口提取,按规则定时拉取新IP入库,稳定得多。正经跑业务的项目,基本都走第二条路。
2. 存储:放在哪。别用文本文件,IP一多读写就是灾难。主流做法是放Redis里,用集合去重,用有序集合按分数排序——分数就是每个IP的健康状况,随时能取出"优等生"。
3. 检测:谁说了算。IP入库只是起点,每隔几十秒到几分钟要做一轮"体检":拿它去请求一个稳定的测试地址,两秒内有响应算合格,超时或报错就扣分,分数低于警戒线直接移出池子。
4. 调度:怎么用。业务来取IP时,池子按策略分发——随机取、轮着取、优先取高分IP,或者按地区取。策略选得好,整体成功率能差出一大截。
下面这段Python代码是个最小可运行的骨架,把检测和调度两个环节串了起来,拿来改改就能跑:
import requests
import time
import random

TEST_URL = "https://www.example.com"   # 任意稳定可达的测试地址
TIMEOUT = 2                            # 超过2秒视为不合格

# 用列表模拟池子,正式项目建议放 Redis,用有序集合按分数排序
ip_pool = [
    {"ip": "117.62.21.35:4231", "score": 100},
    {"ip": "223.152.10.88:5678", "score": 100},
    {"ip": "101.68.73.12:8899", "score": 100},
]

def check_one(item):
    """给单个IP做体检:通则保留,不通则清出"""
    try:
        start = time.time()
        requests.get(TEST_URL,
                     proxies={"http": "http://" + item["ip"]},
                     timeout=TIMEOUT)
        cost = int((time.time() - start) * 1000)
        print(item["ip"], "可用,耗时", cost, "ms")
        return True
    except Exception:
        print(item["ip"], "已失效,移出池子")
        return False

def get_proxy():
    """调度策略:优先取高分IP,简单但有效"""
    alive = [x for x in ip_pool if x["score"] > 60]
    return random.choice(alive)["ip"] if alive else None

# 一轮完整的体检:不合格的直接清出去
for item in ip_pool[:]:
    if not check_one(item):
        ip_pool.remove(item)

print("当前池内可用IP:", len(ip_pool), "个")
真实项目里还要加上多线程检测、失败重试、地区标签这些功能,但核心逻辑就是这个循环:进水 → 体检 → 淘汰 → 补充,一刻不停地转。
搭好只是开始:日常运维怎么管
IP池是个"活物",搭好那天只是及格线,真正拉开差距的是日常运维。盯住下面这几项,池子才不会悄悄烂掉。
存活率曲线:每隔几分钟统计一次池内可用IP的占比,画出趋势图。健康的状态是平稳的,如果曲线持续下滑,多半是获取端出了问题——比如API提取额度用完了,或者来源页面改了结构。
响应耗时分布:不光要看能不能通,还要看多快。把耗时分成几档,比如500毫秒以内、1秒以内、超2秒,超时档的IP该剔就剔,别让慢节点拖累整个任务。
淘汰与补充的节奏:短效IP淘汰快,补充频率就得跟上。经验值是让"每小时补充量"略大于"每小时自然失效量",池子水位才会稳。水位一旦跌破任务的并发需求,成功率立刻给你颜色看。
调度日志:每次分发都记一笔——什么时间、哪个任务、拿了哪个IP、结果如何。出了问题能快速回溯,是IP本身不行,还是目标网站调整了规则。
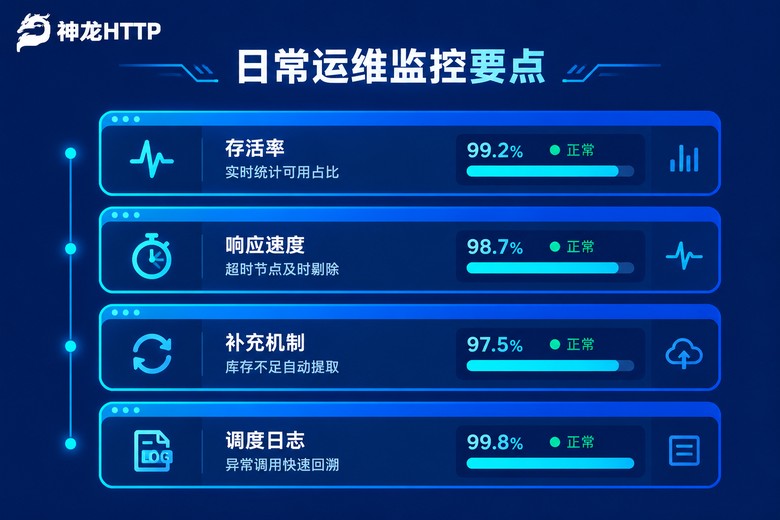
这些活儿听起来琐碎,但一件都不能省。如果你不想自己养一套监控系统,也可以直接用服务商后台的现成能力——比如神龙HTTP的个人中心里就有可视化用量统计和实时监控,异常用量一眼就能识别出来,使用趋势也有图表可看,等于把运维监控这摊事外包了一半。
自建池子,还是直接用现成服务
这个问题几乎每个团队都纠结过。给你一个直接的判断依据:看你的业务对IP质量的要求有多高。
| 对比维度 | 自己搭免费池 | 用正规代理服务 |
|---|---|---|
| IP质量 | 来源杂,存活时间全凭运气 | 正规授权,可用率99.9% |
| 维护成本 | 检测、补充、监控全要自己写 | 服务商托管,开箱即用 |
| 上手速度 | 少则几天,多则几周 | 拿到API当天就能跑 |
| 承载能力 | 高峰期水位不稳,容易断供 | 低延迟高并发,扛得住大任务 |
我的建议是分阶段走:学习阶段自己搭一个几十个IP的小池子,把原理摸透,这段代码经验非常值钱;一旦进入正式业务,就别在基础设施上耗时间了,直接接现成的服务。神龙HTTP在这方面对开发者比较友好,API兼容主流爬虫编程语言,官方文档配了示例代码,把提取链接换成你自己的密钥,几十行代码就能把池子的"进水口"接到自己的存储里,后面那套检测调度逻辑照常自己管。
还有一点值得说:合规。免费收集来的IP来源说不清,用起来心里总不踏实;正规服务商的IP是有三大运营商授权的,做公开数据采集、市场研究这类正经业务,底子干净,睡得着觉。
常见问题
Q: 自己搭的池子,IP用几次就失效了,是不是我代码写得有问题?
大概率不是。短效动态IP本来就设计为短周期存活,几十分钟换一批很正常。解决办法有两个:一是提高检测和补充频率,让新IP的进水速度追上失效速度;二是改用长效静态IP,单个地址能顶几天甚至更久,适合需要稳定出口的业务。
Q: 池子要多大才够用?
按"并发数 × 单请求耗时 ÷ IP平均存活时间"往上浮30%估算。比如你的任务同时开50个线程,每个请求平均10秒,IP平均存活5分钟,那池子常驻几十到一百个可用IP就够。与其堆数量,不如保证质量——一百个能用的,胜过一千个半死不活的。
Q: 定时检测所有IP,会不会把服务器资源吃光?
池子上了万级规模确实会。三个省资源的办法:错峰检测,把全量体检拆到不同时间段;抽样检测,高分IP少测、低分IP多测;并发控制,检测线程数限制在几十个以内。规模再大,就值得单独起一个检测服务了。
Q: 不太会写代码,也能用上代理IP池的思路吗?
可以。很多服务商的提取API本身就带去重和可用性保证,你只需要定时提取一批新IP,填进现成的工具或脚本配置里轮流使用,等于服务商帮你把"检测、淘汰"这两步做了。神龙HTTP的文档里有各语言的示例代码,照着抄改参数就行,遇到问题也有技术团队7×24小时兜底。