先从一个踩坑的例子说起
朋友老周去年接了个活:帮一家做家居用品的客户盯全网价格,每天要把两百多个商品的公开售价整理成报表,周末还得交一份价格波动分析。他一听觉得不难,网上搜了个九块九的代理套餐就上了手。
结果干了不到一周就出问题了。采回来的数据里,有的商品价格停在三个月前,有的页面直接返回一堆乱码,还有几次整个任务卡在半路,一条数据都没落下来。客户在报表里发现两个明显不对的低价,老周查了一晚上才搞清楚,那是页面缓存留下的旧价格。活儿最后是交了,返工的时间全搭进去,算下来还倒贴。
问题出在哪?不在"代理IP"这个工具本身,而是他没弄明白这东西的原理就急着动手。类型选错、节奏用错,钱花出去了,数据却不可靠。这篇文章就把电商代理IP这件事掰开讲清楚,帮你把预算花在刀刃上。
代理IP的原理:一个"中间人"的角色
先说最底层的逻辑。你平时用自己的电脑访问一个网站,网站服务器看到的是你家宽带分配的真实IP,就像快递单上的寄件地址,一目了然。挂上代理之后,流程多了一步:你的请求先发到代理服务器,由它替你去访问目标网站,拿到数据再转交给你。网站那边记录到的,是代理服务器的IP,不是你的真实地址。
打个比方,你托一位朋友去店里代买东西,店家全程只见到你朋友的脸。代理服务器就是这个"中间人":你出需求,它出面跑腿。

那电商场景为什么特别依赖这个"中间人"?因为电商平台对访问行为很敏感。一个IP每分钟请求几百次商品页,正常购物的人不可能有这种浏览速度,系统就会提高警惕,轻则弹出验证码拖慢任务,重则返回空数据甚至限制访问。代理IP的价值就在这里:把访问分散到大量不同的IP上,让单个IP的请求密度降到接近真人浏览的水平。任务跑得顺,采回来的数据也完整。
平台是怎么"盯上"一个IP的
知道了原理,还得知道对面是怎么看的。电商平台的检查逻辑并不神秘,主要盯四件事。
一是请求频率。同一个IP短时间内高密度地翻页面、拉接口,这是最容易暴露的信号。老周踩的坑里有一部分就来自这里,他的程序不加延时,一口气把请求全挤在几秒内发出去了。
二是IP的"出身"。IP分机房IP和家用宽带IP,前者来自数据中心,后者来自普通用户的网络。一个商品详情页的访问者如果清一色是机房IP,比例上就不太正常。
三是IP的"前科"。一个IP如果之前有过高频访问的记录,可能已经被打了标记,换个任务接着用,照样会被重点照顾。
四是行为轨迹。真人逛电商会看详情页、翻评价、对比规格,程序如果只会直线式地拉数据,特征就很单一。把节奏放慢、请求之间留间隔,情况会明显改善。
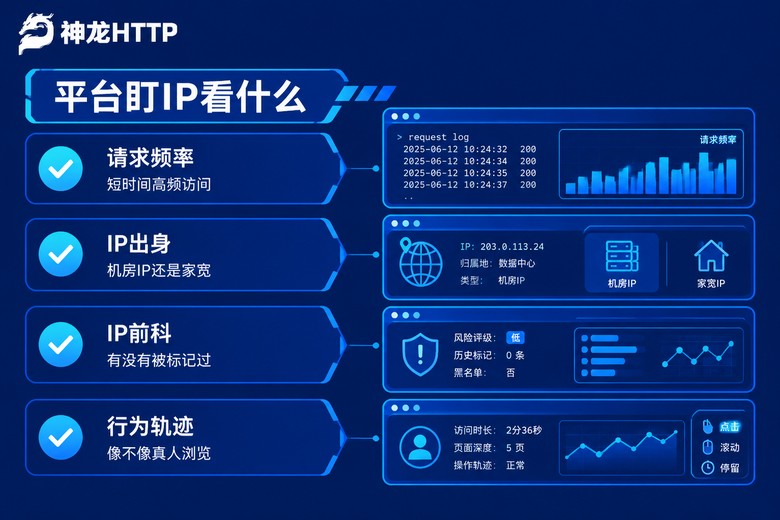
这四条里,频率和出身跟代理IP的选择直接相关。这也是为什么选对IP类型,比什么都重要。
短效动态和长效静态,选错就烧钱
市面上的代理IP按存活时间分两大类,对应完全不同的任务。很多人像老周一样闭着眼买便宜的,结果类型不匹配,钱花了活儿干不好。
短效动态IP:一个IP用几分钟到几十分钟就失效,然后自动换上新的。单价低、量大管饱,适合单次任务短、跑完就结束的活儿,比如每天定时抓一遍商品价格、定期整理一份公开数据报表。
长效静态IP:一个IP能连续用上几天甚至更久,地址固定不变。适合需要长时间保持连接稳定的任务,比如持续盯一个数据看板、跑那种中途断了就得重来的长流程。
| 对比维度 | 短效动态IP | 长效静态IP |
|---|---|---|
| 单个IP存活时间 | 几分钟到几十分钟 | 几天到更长 |
| 单价水平 | 低,按量计费划算 | 相对高 |
| 典型任务 | 定时抓价格、日更报表 | 长时间监控、连续流程 |
| IP变动 | 自动换新 | 基本固定不变 |
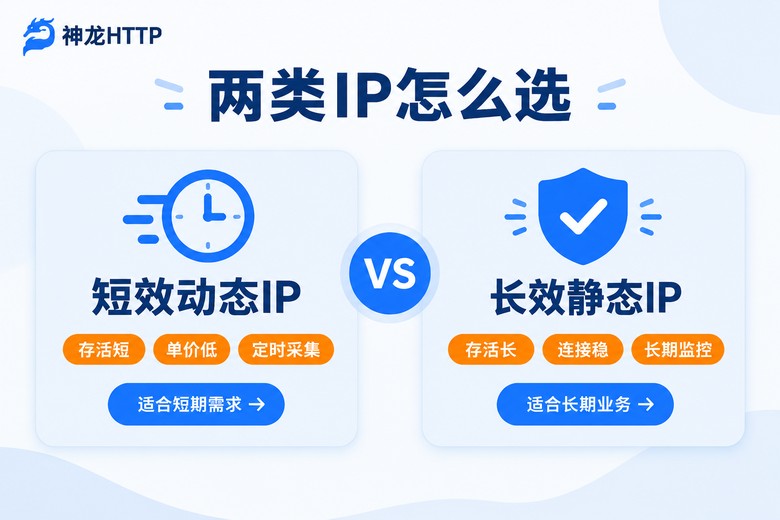
拿神龙HTTP来说,短效动态IP和长效静态IP两条产品线都有,可用率保持在99.9%,IP纯度99.8%。纯度这个指标很实在——纯度高意味着IP没被滥用过,采回来的数据干净完整,不用反复返工。选之前先想清楚自己的任务形态,再决定买哪类,这一步就能省下不少冤枉钱。
动手:十分钟接上第一个代理IP
原理清楚了,类型选好了,接下来上手。以神龙HTTP为例,流程就三步:在个人中心拿到API提取链接,用代码取一批IP,然后带着代理发请求。用Python写大概是这样:
import requests
import time

# 第一步:从神龙HTTP个人中心复制API提取链接,取一批可用IP
def fetch_ips():
    api_url = "在这里填你的IP提取链接"
    resp = requests.get(api_url, timeout=5)
    return resp.json()   # 返回形如 ["1.2.3.4:8000", ...] 的列表

# 第二步:带代理请求页面,失败就换下一个IP
def get_page(url, ip_list):
    for ip in ip_list:
        proxies = {
            "http": "http://" + ip,
            "https": "http://" + ip
        }
        try:
            resp = requests.get(url, proxies=proxies, timeout=8)
            if resp.status_code == 200:
                return resp.text
        except requests.RequestException:
            continue
        time.sleep(1.5)   # 请求之间留间隔,别挤在一起
    return None

ips = fetch_ips()
target_url = "要采集的商品页链接"
html = get_page(target_url, ips)
print(html[:300] if html else "这批IP都失败了,重新提取一批再试")
几个新手容易忽略的细节说一下:
超时必须设。不设超时的请求一旦卡住,整个任务就停在那儿,后面排队的IP全白提取了。代码里的 timeout=8 是个稳妥的起点。
失败要换IP重试。任何一个IP都有失效的可能,别把希望押在单个IP上,写个循环挨个试,成功率立刻不一样。
节奏要留白。两次请求之间隔上一两秒,看似慢了,实际上IP消耗少、数据完整度高,总耗时反而更短。
神龙HTTP的API兼容主流爬虫编程语言,文档里有现成的示例代码,改改参数就能跑。自己折腾不通的时候,他们的技术团队7×24小时在线,响应速度在行业里算快的。
预算不白花的四个实在做法
先小规模试跑,再扩大。新任务先按最小量跑通全流程,人工抽查几条数据,确认价格、标题、库存这些字段都完整,再加大采集量。老周那两个缓存旧价格,如果当初抽查过,当天就能发现。
任务和IP类型要匹配。定时抓价格这类短任务,用短效动态就够了,别为了"一步到位"全买长效静态,单价高出一截,用在几分钟就结束的任务上,等于花钱买闲置。
把程序的节奏放慢。请求间隔加一两秒,任务错开平台访问高峰时段。跑得稳比跑得快重要,IP消耗能降下来一大截。
每天看一眼用量面板。神龙HTTP个人中心里有可视化用量统计和实时监控,消耗曲线、异常提醒都能看到。哪天消耗突然翻倍,多半是程序里循环写错了,及时发现能省下一笔。
常见问题
Q:电商代理IP到底解决什么问题?
一句话:把访问请求分散到大量不同的IP上,避免同一个IP请求太密被平台限流。对做价格监测、公开数据采集的电商从业者来说,它直接决定数据全不全、任务能不能跑完。
Q:免费的代理IP能用吗?
练手可以,正经任务别用。免费IP来源杂、纯度低,经常采到旧缓存或缺页的数据,返工耗掉的时间远超省下的钱。老周的九块九套餐就是前车之鉴,免费的只会更不稳定。
Q:短效动态和长效静态,还是拿不准选哪个?
看任务时长。几分钟跑完、每天定时执行的,选短效动态;要连续跑几小时以上、中途不能断的,选长效静态。实在纠结,就各买最小量各试一天,用实际数据做决定。
Q:用代理IP采集公开数据,有什么要注意的?
只采集公开可见的信息,控制好请求频率,遵守目标网站的访问规则。另外尽量选正规服务商,比如神龙HTTP的IP来自国内三大运营商正规授权,资源干净,用着踏实。