三行代码:让requests请求走代理
先说场景。你写了个脚本去采集公开数据,本地测试一切正常,跑到几百条之后,返回的内容开始变成验证页面,再跑直接超时。这基本就是同一个出口IP请求太密集,被对方的风控盯上了。解决办法很直接:让请求从不同的IP出去,也就是给requests挂上代理。
requests里管这件事的参数只有一个,叫 proxies,它是个字典:
import requests

proxies = {
    "http": "http://114.80.32.12:16816",
    "https": "http://114.80.32.12:16816"
}

resp = requests.get("https://httpbin.org/get", proxies=proxies, timeout=10)
print(resp.json()["origin"])
跑一下,如果打印出来的origin是代理的IP而不是你本机的宽带IP,说明配置生效了。这是验证代理最靠谱的办法,比盯着状态码猜实在得多。
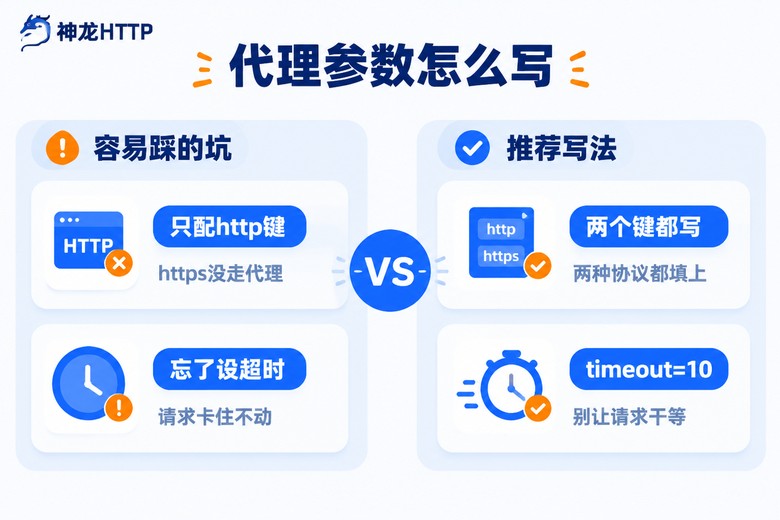
新手最容易犯的错,是只写"http"这一个键。requests对http和https请求是分开看配置的,你访问的目标站如果是https开头,而字典里没有"https"这个键,那条请求就会直连出去,等于白配。所以两个键都写上,值一般填同一个地址,这是习惯动作。
另外提醒一句,代理地址里的协议头别省。只写"114.80.32.12:16816"而不带http://,某些版本会报错或者行为怪异,老老实实把协议头带全。
代理带账号密码,写法只差一点
付费代理通常要做身份验证,账号密码直接拼进地址就行,格式是在IP前面加上"用户名:密码@":
from urllib.parse import quote

user = "myaccount"
pwd = quote("p@ss#123")   # 密码含特殊字符,先做URL编码
host = "114.80.32.12:16816"

proxies = {
    "http": f"http://{user}:{pwd}@{host}",
    "https": f"http://{user}:{pwd}@{host}"
}

resp = requests.get("https://httpbin.org/get", proxies=proxies, timeout=10)
这里有个不起眼但坑过很多人的细节:密码里如果有@、#、:这类符号,必须先用quote编码,不然requests会把它当成地址的分隔符,报一堆看不懂的连接错误。我见过有人对着ProxyError查了一下午,最后发现就是密码里那个@没处理。
如果你用Session会话,写法也一样,把字典赋给session.proxies,之后这个会话里的所有请求都自动走代理,不用每次都传:
session = requests.Session()
session.proxies.update(proxies)
session.get("https://httpbin.org/get", timeout=10)
实战示例:API提取IP,失败自动取下一个
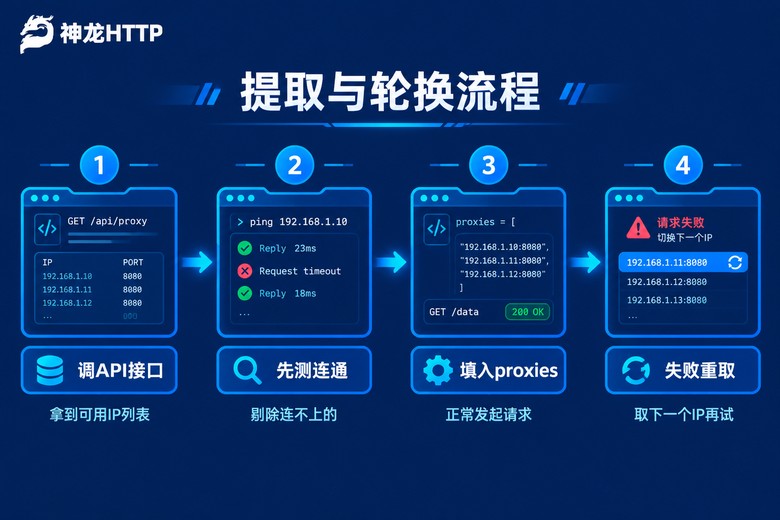
真实项目里,你不会在代码里写死一个IP——代理IP是有寿命的,短效的可能几分钟就更新一轮。更实际的做法是:通过服务商的API接口提取一批IP,程序里维护一个池子,谁失效了就取下一个。
下面是一套改改就能用的骨架代码:
import requests

def get_ip_list():
    """在服务商个人中心生成自己的API提取链接,贴进来即可"""
    api_url = "https://你的提取链接?num=5"
    result = requests.get(api_url, timeout=10).json()
    # 字段名以服务商文档为准,这是常见的返回结构
    return [f"http://{item['ip']}:{item['port']}" for item in result["data"]]

def fetch(url, ip_pool):
    for proxy in ip_pool:
        try:
            resp = requests.get(
                url,
                proxies={"http": proxy, "https": proxy},
                timeout=10
            )
            if resp.status_code == 200:
                return resp.text
        except requests.RequestException:
            continue   # 这个IP连不上,取下一个
    return None

pool = get_ip_list()
html = fetch("https://目标站点.example/list/1", pool)
逻辑很朴素:拿到IP列表,逐个试,谁好用就用谁,全挂了就返回空。要跑长期任务的话,再补两件事——一是定时重新调API获取新的IP,刷新池子;二是把失效的IP记下来,看看是不是某个网段集中出问题,方便跟服务商反馈。
以神龙HTTP为例,它的API兼容主流爬虫编程语言,文档里带示例代码,把提取链接换成你自己的,上面这段几乎不用改就能跑。提取到的IP支持HTTP/HTTPS/SOCKS5三种协议,用不同语言写的采集程序都能接进来。
四个容易忽略的细节,踩过才明白
1. timeout一定要设。代理链路比直连多一跳,响应慢是常态。不设超时的话,一个卡住的请求能拖住整个脚本,看起来像死机。10秒是个合理的起点,慢了就取下一个IP,别死等。
2. 小心系统环境变量捣乱。如果你的电脑或服务器上设过HTTP_PROXY这类环境变量,requests会优先读它们,可能让你以为配好了代理,实际走的却是另一条路。排查时可以加一行 session.trust_env = False,把环境变量的干扰关掉。
3. 别随手关证书校验。网上有些教程让你写 verify=False 来绕开SSL报错,这属于掩耳盗铃。报SSL错误多半是代理通道不支持https,正确做法是改用支持https的代理类型,而不是把校验关掉留下隐患。
4. 频率该控制还是要控制。代理能分散请求出口,但不代表可以无节制地高频率请求。合理的间隔加上IP轮换,任务才能跑得长久。
| 报错或现象 | 大概率原因 | 处理办法 |
|---|---|---|
| ProxyError | IP或端口写错、代理已失效 | 核对地址,取一个新的IP重试 |
| SSLError | 代理通道不支持https | 改用支持https的代理类型 |
| ConnectTimeout | 代理响应慢或已失效 | 加大timeout,或取下一个IP |
| origin还是本机IP | https键没配 | http和https两个键都写上 |
代理IP从哪来?选对源头少走弯路
免费的IP列表网上到处都有,拿来跑通代码没问题,但正经项目别指望它——可用率低、寿命短,你刚验证完它就失效,排查的时间成本比什么都贵。
付费服务里,我判断就盯两条:IP质量硬不硬,出了问题有没有人管。神龙HTTP这两点都拿得出手:三千万级以上的IP储备来自国内三大运营商的正规授权,可用率标到99.9%,等于一百次请求里最多一次因为IP本身失败,重试成本几乎可以忽略;遇到问题,技术团队7×24小时在线,不用自己干耗。
还有一点很实用:它的个人中心有可视化用量统计和实时监控,今天用了多少、成功率多少、有没有异常,打开面板一眼就能看到,跑长期任务心里有底。个人或小团队可以先小流量试跑,确认效果符合预期再往上加任务。
常见问题
Q: 免费代理和付费代理差别真有那么大?
差别主要在可用率和稳定性。免费IP通常可用率不到两成,寿命以分钟计;正规付费服务像神龙HTTP,可用率99.9%、IP纯度99.8%,配合失败重取的逻辑,任务基本不会因为IP问题中断。
Q: 短效动态IP和长效静态IP怎么选?
看任务性质。高频次、大请求量、不需要维持会话的采集任务,用短效动态IP,到点自动更新;需要长时间保持同一个出口、维持登录状态的场景,用长效静态IP更合适。神龙HTTP两条产品线都有,按需选就行。
Q: 怎么确认代理真的生效了?
请求一个能回显IP的接口,比如 httpbin.org/get,看返回的origin字段。显示的是代理IP就说明生效了;还是本机IP的话,九成是https键没配,或者环境变量里有别的代理在起作用。
Q: 提取回来的IP要不要先做可用性验证?
建议做。先用一个轻量请求测连通性,能通的再进池子,能省掉大量运行中的失败重试。有些服务商的提取接口本身就带筛选参数,提取出来的已经是可用IP,具体看文档说明。