上个月有个朋友丢给我一份日志,说他的采集任务跑了两周都好好的,某天开始一半请求返回空数据,翻上去全是 403。他第一反应是加线程数,从 20 加到 80,结果失败率直接冲到七成。这不是并发的问题,是代理这一层没接对——IP 是死的、失败了也不换、重试还照着原路撞。
下面按真实落地的顺序走一遍:请求链路怎么摆、代理地址怎么配、IP 从哪儿来、什么时候该重试什么时候不该。全程带代码,能直接抄。
先弄明白:代理插在你这条请求的哪一环
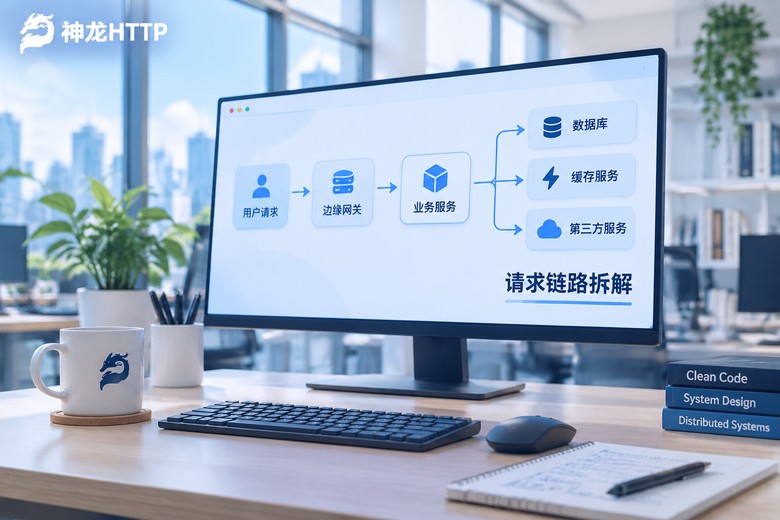
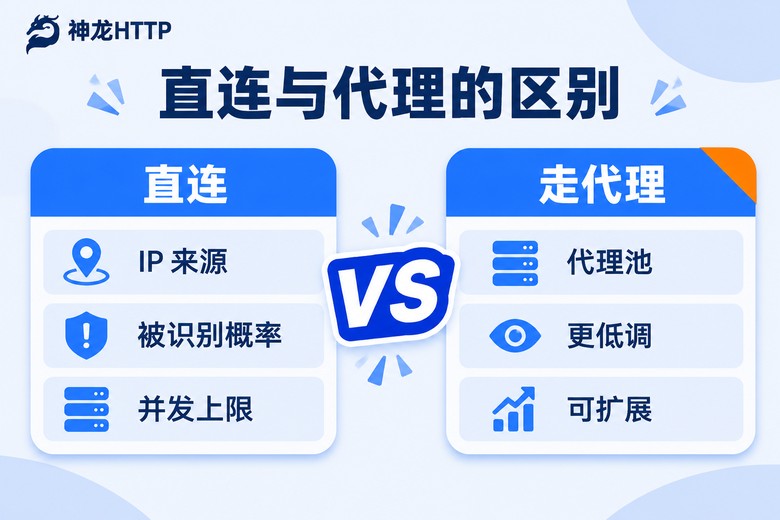
把一次请求拆开看,其实就三跳:你的程序发出请求 → 走代理服务器出去 → 到达目标站。目标站记录的访问来源是代理那台机器的 IP,你本机的地址不会暴露。
这里有个新手最容易踩的坑:proxies 字典里的 http 和 https 两个键,都要写上。很多人只写了 http 那一条,结果访问 https 站点时悄悄走了直连,前几十个请求正常,之后整段被封,还查不出原因。
# 只写 http 是错的,https 站会直连
proxies = {"http": "http://1.2.3.4:8080"}

# 两条都写,才真的全走代理
proxies = {
    "http":  "http://1.2.3.4:8080",
    "https": "http://1.2.3.4:8080",
}
还有一点:代理认的是"出口线路",不是"你的账号"。同一条代理线路如果一直用,目标站那边看到的就是同一个来源,用久了照样会被盯上。所以真正决定成败的不是有没有代理,而是背后有没有一个能持续更换的 IP 池。
环境配置:地址写进配置,别写死在代码里
我见过太多脚本把代理地址硬编码在第三十行,换个供应商就得全局搜索替换。正确的做法只有一步——把它挪到环境变量或者配置文件里。
import os, requests

HOST = os.getenv("PROXY_HOST")
PORT = os.getenv("PROXY_PORT")
USER = os.getenv("PROXY_USER")
PWD  = os.getenv("PROXY_PASS")

proxy_url = f"http://{USER}:{PWD}@{HOST}:{PORT}"

session = requests.Session()
session.proxies.update({"http": proxy_url, "https": proxy_url})
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0 Safari/537.36"
})
session.trust_env = False   # 避免系统代理变量干扰
用 Session 而不是每次 requests.get,好处是连接会复用,省掉大量握手开销。顺手把 trust_env 关掉,能躲开一部分"本机环境变量把代理指到别处"的怪问题。
如果你用 Scrapy,配置在 settings 里开重试,代理则交给下载中间件处理——不要在 settings 里写死一个固定 IP,那样等于没配。
# settings.py
DOWNLOADER_MIDDLEWARES = {
    "myproject.middlewares.ProxyMiddleware": 543,
}
RETRY_ENABLED = True
RETRY_TIMES = 3
RETRY_HTTP_CODES = [403, 429, 500, 502, 503, 504]
DOWNLOAD_TIMEOUT = 15
CONCURRENT_REQUESTS = 32
# middlewares.py
import random
class ProxyMiddleware:
def __init__(self, pool):
self.pool = pool
@classmethod
def from_crawler(cls, crawler):
return cls(crawler.spider.proxy_pool)
def process_request(self, request, spider):
p = self.pool.get()
request.meta["proxy"] = p["url"]
request.meta["proxy_id"] = p["id"]
def process_response(self, request, response, spider):
if response.status in (403, 429):
self.pool.drop(request.meta.get("proxy_id"))
return request.replace(dont_filter=True)
return responseIP 从哪儿来:提取、校验、入池、淘汰
这一步是整条链路的命门。免费名单那种做法,采集量小还能撑一阵,一旦上量就崩——你花在校验和剔除上的时间,比写业务解析逻辑还多。
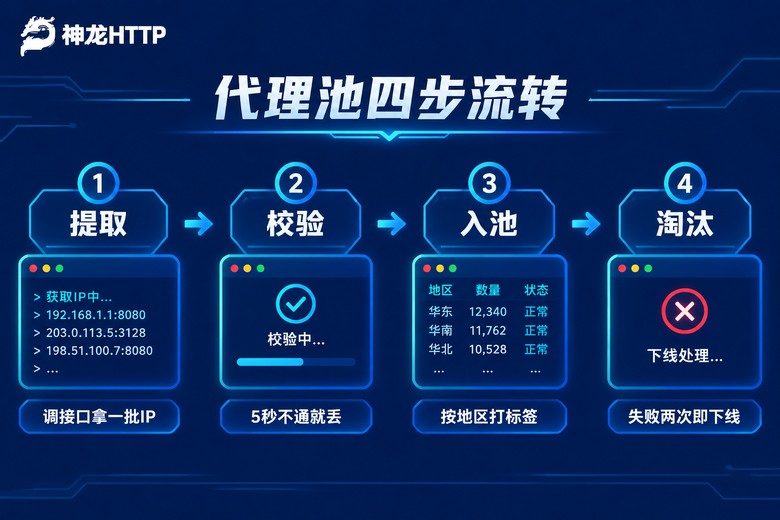
正规做法是自己维护一个小池子,四个动作循环跑:
提取:通过 API 一次拿一批,别一条一条要,接口调用本身也有开销。校验:拿到手的不一定通,先跑一遍连通性再进池。入池:带上地区、类型、拿到的时刻打标签,便于按需挑。淘汰:连续失败两次的直接下线,别心疼。
import time, requests

CHECK_URL = "https://你的校验接口/ip"     # 换成能回显来源IP的地址

def check(proxy_url, timeout=5):
    try:
        r = requests.get(
            CHECK_URL,
            proxies={"http": proxy_url, "https": proxy_url},
            timeout=timeout,
        )
        return r.status_code == 200
    except requests.RequestException:
        return False

# 校验并发别开太大,10~20 条足够,开太大反而把自己出口打满
def fill(pool, batch):
    for item in batch:
        if check(item["url"]):
            pool.add(item)
        time.sleep(0.1)
池子里的 IP 要按用途分。列表页、详情页这种短平快的任务,用短效动态的就够,用完即弃;需要保持登录态、要连续翻页的流程,就得靠长效静态或者固定 IP,中途换掉等于重新登录一次。这个区分做对了,后面的重试逻辑能少写一半。
失败重试:先分清是哪一类失败,再决定重不重试
很多人写重试就是一个 for i in range(3),不管什么错都重来三遍。这样做的后果是:认证错了也重试、并发太高也重试,白白把额度烧光。
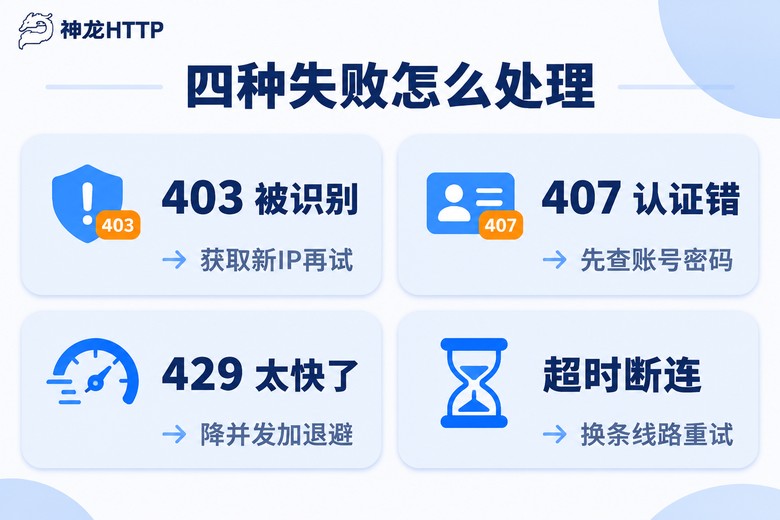
先做一次分类,下面这张表可以直接贴到你的代码注释里:
| 现象 | 真实原因 | 正确处理 |
|---|---|---|
| 403 | 被目标站识别出来了 | 获取新IP + 换 UA,隔几秒再试 |
| 407 | 代理账号或密码不对 | 不重试,先修配置 |
| 429 | 请求节奏太快 | 降并发,加退避等待 |
| 500 / 502 / 503 | 目标站抖动或代理网关不稳 | 原地重试 2~3 次 |
| 连接超时 | 这条线路不通 | 获取新IP后重试 |
最省事的一层是在连接层做自动重试,指数退避交给它算:
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

retry = Retry(
    total=3,
    backoff_factor=0.8,                       # 0.8s → 1.6s → 3.2s
    status_forcelist=[429, 500, 502, 503, 504],
    allowed_methods=["GET"],
    raise_on_status=False,
)
adapter = HTTPAdapter(max_retries=retry, pool_maxsize=50)
session.mount("http://", adapter)
session.mount("https://", adapter)
注意 403 和 407 不要放进去,它们不会自己好。403 需要换一条线路,407 需要改配置,自动重试只会把同一个错误重复三遍。
业务层的重试自己写更可控:
def fetch(url, tries=3):
    for i in range(tries):
        item = pool.get()
        try:
            r = session.get(url, proxies=item["proxies"], timeout=(3.05, 10))
            if r.status_code == 200:
                return r.text
            if r.status_code in (403, 429):
                pool.drop(item["id"])         # 这条不行了,下线
                time.sleep(2 ** i)            # 1s、2s、4s
                continue
            return None                       # 4xx 其他情况没必要重试
        except requests.RequestException:
            pool.drop(item["id"])
            time.sleep(2 ** i)
    return None
两个小细节值得加上:一是超时拆成 (3.05, 10) 这种连接/读取分离的写法,能更快识别"这条线路根本连不上";二是最后别忘了给任务一个总量上限,重试次数 × 并发数一旦超过池子容量,就会出现"所有请求都在等 IP"的假死,看着像卡住,其实是在排队。
真实落地时的几个建议
如果你不想自己维护池子的稳定性和可用率,直接用现成服务是更划算的选择。神龙HTTP 的池子有 3000 万+ 正规授权代理 IP,可用率标称 99.9%,覆盖 300+ 城市级定位——这条对做区域化数据采集特别有用,你要哪个城市的出口,直接在提取参数里指定就行,不用自己一台台去测。
它支持 HTTP/HTTPS/SOCKS5 三种协议,短效动态、长效静态、固定 IP 三条产品线是一站式给的。我的建议是:列表页、搜索结果这类高频短任务,用短效动态,失败就换;需要登录态、要连着翻几十页的流程,挂长效静态或固定 IP,避免中途掉线。API 兼容主流编程语言,文档里有示例代码,接进来基本就是改个 URL 和参数的事。
还有一个容易被忽略的功能:个人中心里有可视化的用量统计和实时监控。上线第一周我建议你天天看一眼,异常曲线基本能提前告诉你哪里出了问题——是某批 IP 集中失效,还是自己的并发突然飙了。比事后翻日志省事得多。真遇到调不通的情况,技术团队是 7×24 小时在线的,把请求日志贴过去比自己猜快。
常见问题
Q:配了代理,为什么请求还是从本机 IP 发出去的?
九成是只写了 http 那一个键,访问 https 站点时自动走了直连。把 http 和 https 两条都写上,再用一个能回显来源的接口验一次,问题就现形了。另外记得设 session.trust_env = False,不然系统环境变量可能把请求指到别的地方。
Q:重试次数设多少合适?
看任务性质。列表页这种一次性的,3 次封顶,第三次还不通说明这条线路和这个目标站不合,换 IP 比继续撞更有意义。详情页、需要保持状态的流程,可以放宽到 5 次,但必须配合换 IP,光重试不换出口等于白做。
Q:403 一直出现,是不是代理质量不行?
先别急着换供应商。检查三件事:UA 有没有换成正常的浏览器标识、请求间隔是不是太密、有没有带上必要的请求头。这三样都正常还是 403,再考虑提高 IP 的更换频率,或者换一批地区不同的出口试试。
Q:并发开多少比较稳?
不是越多越好。先按池子里可用 IP 数量的三分之一起步,跑十分钟看失败率,稳定在 5% 以内再加。我见过把并发从 20 直接拉到 80 的,失败率反而从 8% 涨到 70%——不是 IP 不够,是同一批 IP 被你自己的并发用废了。