先弄明白:这个池子到底是个啥
先说个真事。上个月帮朋友跑一个商品价格监测的脚本,头一天晚上跑得好好的,第二天早上一看,返回全是403,一条数据都没拿到。原因不复杂:脚本用家里宽带的同一个IP,一夜发了几千次请求,目标网站不拦你拦谁。
解决办法说白了就一句话:让每次请求从不同的IP出去。但总不能每发一次请求就手动找一个新IP吧,所以需要一个"仓库",里面常备一堆能用的IP,用的时候取一个,用坏了取下一个,坏掉的及时清出去,新的源源不断补进来。这个仓库,就是代理IP池。
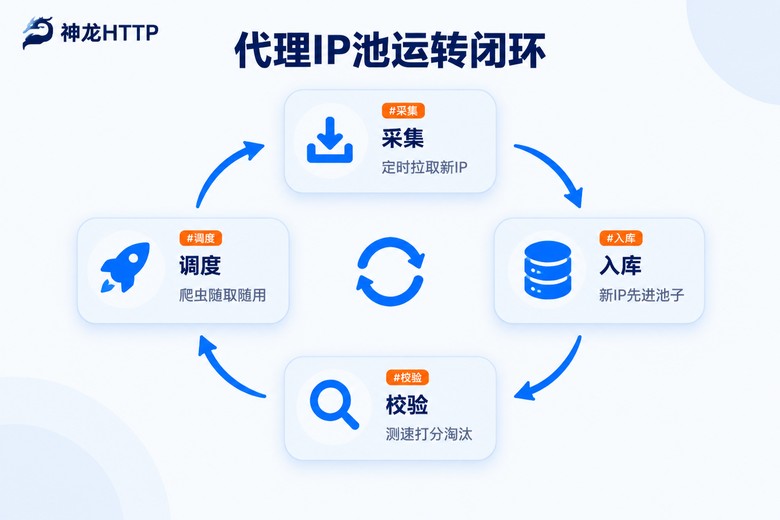
拆开看,一个能跑的池子就三个动作:进水——定时从IP来源拉一批新IP存进去;过滤——逐个测试,能通且速度快的留高分,不通的直接扔;放水——爬虫要发请求时,从池子里捞一个高分IP出来用。三个动作各写一个函数,加起来不到一百行代码。
动手前,把三样东西备齐
第一样,Python 3.8 以上版本,装好就行。第二样,Redis,用来存IP和它们的分数。本机安装嫌麻烦的话,用Docker一行命令起一个:
docker run -d -p 6379:6379 --name ip-redis redis
pip install requests redis第三样,也是最关键的一样:IP从哪来。很多人第一反应是去网上找免费公开IP,我劝你练手可以,正经项目别碰。我自己测过,免费列表里扒下来的IP,能用的经常不到三成,而且活不了几分钟,你的校验模块会比采集模块还忙,最后机器算力全耗在"验货"上了。
正式跑,建议直接用付费的代理服务。我在用的是神龙HTTP,看中两点:一是可用率99.9%、IP纯度99.8%,拉下来的IP基本开箱能用,池子里的校验模块就从"主力"退化成"兜底",压力小一大截;二是API兼容主流爬虫编程语言,文档里带示例代码,把链接贴进脚本就能跑通。注册之后进个人中心,生成一条API提取链接,格式选"ip:port、每行一个",数量按需选,复制出来备用。
第一步:把IP装进池子
新建一个 pool.py,先把公共部分写好。这里用Redis的有序集合(zset)存IP,score就是每个IP的健康分,这是整个池子的核心设计:
import time
import random
import threading
import requests
import redis
from concurrent.futures import ThreadPoolExecutor

r = redis.Redis(host="127.0.0.1", port=6379, db=0, decode_responses=True)

API_URL = "把神龙HTTP个人中心生成的API链接粘到这里"
TEST_URL = "https://httpbin.org/get"   # 专门用来体检的稳定地址
然后是采集函数。新IP进池子时先给10分的基础分,算不算数,等体检模块说了算:
def fetch_ips():
    """从API拉一批新IP,先给10分基础分"""
    try:
        text = requests.get(API_URL, timeout=10).text
    except Exception:
        return
    for line in text.strip().splitlines():
        proxy = line.strip()
        if ":" in proxy:
            r.zadd("ip_pool", {proxy: 10})
第二步:给每个IP做体检
IP这东西,不测不知道,一测吓一跳。哪怕是付费来源,也保不齐个别IP在你本机的网络环境下不通,所以体检这一步不能省,只是从"主力"变成了"抽查"。
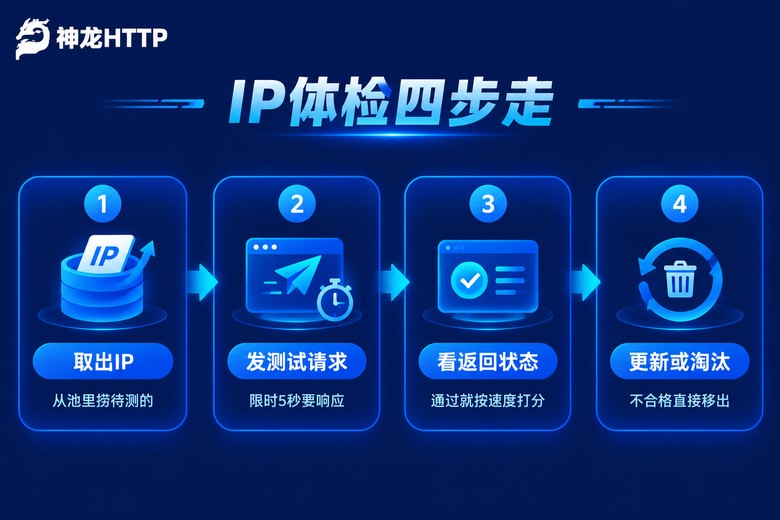
思路很简单:拿池子里每个IP去请求一个稳定的测试地址,通了就按响应速度打分——越快分越高,不通的直接清零出池。开20个线程一起测,几百个IP几十秒就能过一遍:
def check_one(proxy):
    """单个IP体检:通了按速度打分,不通记0分"""
    proxies = {"http": f"http://{proxy}", "https": f"http://{proxy}"}
    try:
        start = time.time()
        resp = requests.get(TEST_URL, proxies=proxies, timeout=(3, 5))
        cost = time.time() - start
        if resp.status_code == 200:
            return proxy, max(1, 10 - int(cost * 2))  # 越快分越高
    except Exception:
        pass
    return proxy, 0

def check_all():
    """全池体检,20个线程并发测"""
    candidates = r.zrange("ip_pool", 0, -1)
    with ThreadPoolExecutor(max_workers=20) as ex:
        for proxy, score in ex.map(check_one, candidates):
            if score > 0:
                r.zadd("ip_pool", {proxy: score})
            else:
                r.zrem("ip_pool", proxy)   # 0分,请出池子
注意 timeout 我写成了 (3, 5),意思是连接超时3秒、读取超时5秒。这两个值分开设很重要,后面踩坑那段细说。
第三步:让爬虫随取随用
池子有了,爬虫怎么用?两个原则:只取及格线以上的IP,用坏了立刻踢。取的时候在5分以上里随机挑一个,别总盯着分数最高的那个用,容易被用"疲":
def get_proxy(min_score=5):
    """只从及格线以上的IP里随机挑一个"""
    good = r.zrangebyscore("ip_pool", min_score, "+inf")
    return random.choice(good) if good else None

def crawl(url):
    """带重试的采集:一个IP不行,自动取下一个接着试"""
    for _ in range(3):
        proxy = get_proxy()
        if proxy is None:
            time.sleep(2)     # 池子暂时空了,等体检模块补货
            continue
        try:
            resp = requests.get(
                url, proxies={"http": f"http://{proxy}"}, timeout=(3, 8))
            if resp.status_code == 200:
                return resp.text
        except Exception:
            r.zrem("ip_pool", proxy)   # 关键时刻掉链子,踢掉
    return None
把三个模块串起来,正式跑起来
最后用一个常驻脚本,把采集和体检挂在两个后台线程上,主线程专心跑你的采集任务:
def fetch_loop():
    while True:
        fetch_ips()
        time.sleep(60)      # 每分钟补一批新IP

def check_loop():
    while True:
        check_all()
        time.sleep(120)     # 每2分钟全池体检一遍

if __name__ == "__main__":
    threading.Thread(target=fetch_loop, daemon=True).start()
    threading.Thread(target=check_loop, daemon=True).start()

    while True:
        html = crawl("你要采集的目标网址")
        if html:
            print(f"拿到 {len(html)} 个字符,池内可用IP:{r.zcard('ip_pool')}")
time.sleep(1)跑起来之后你会看到,池内可用IP数稳定在几百个上下,采集任务连续跑一整晚,中间不用你管。这就是池子该有的样子:你只管发请求,IP的事它自己消化。
几个我替你踩过的坑
坑一:只进不出,池子越养越"馊"。早期我只顾着往里加IP,忘了淘汰,结果池子看着有两千个,一半是死的,爬虫随机取到坏IP的概率越来越高,重试次数暴涨。记住一点:淘汰和补充同样重要,0分就清,别心疼。
坑二:体检地址选得太随便。我一开始拿目标网站自己当测试地址,结果体检请求把人家惹烦了,正常采集反而被限制。后来换成专门做测试的稳定地址(比如 httpbin),体检是体检,采集是采集,两码事分开。
坑三:超时只写一个数。requests 的 timeout 传单个数字时,连接和读取共用一个上限。网络抖一下,一个慢IP能拖住整个线程十几秒。拆成 (3, 5) 这种元组之后,坏IP三秒内就现形,体检速度翻了几倍。
坑四:不看账本。池子跑没跑健康,得有数。神龙HTTP的个人中心里有可视化的用量统计和实时监控,提取量、使用趋势、异常情况一目了然,我每天早上扫一眼,有没有出问题心里就有底。自建的部分也一样,把 r.zcard 的结果打个日志存下来,趋势不对劲能第一时间发现。
自建池子,还是直接调API?
有人会问:既然服务商有API,为什么不每次请求现取一个IP,还要池子干嘛?我的答案是:池子照样要搭,变的只是IP来源。本地有个池子缓存着,请求来的时候零延迟取用,还能按自己的业务逻辑打分淘汰,这层主动权拿在自己手里,心里踏实。两种路子的实际差别,我列个表:
| 对比项 | 纯用免费公开IP | 神龙HTTP API + 本地池 |
|---|---|---|
| IP来源 | 到处扒的公开IP,来路不明 | 3000万+正规授权储备 |
| 到手可用率 | 常常不到三成 | 99.9%,体检基本走个过场 |
| 响应速度 | 慢,动不动超时 | 低延迟,支持高并发提取 |
| 维护精力 | 天天修管道 | API一行调用,文档示例齐全 |
| 适合谁 | 练手理解原理 | 正式项目,要按时交数据 |
如果你刚入门,拿免费IP把这套代码跑通、理解每个模块在干嘛,完全够用。等要正经出数据了,把 API_URL 一换,其余代码一行不用改——这也是当初把来源、校验、调度拆开写的好处。
常见问题
Q: 池子里留多少个IP才够用?
看你的请求频率。我的经验值:每分钟100次请求以内,池子里常备200~300个及格IP就很从容;频率再高就按比例往上加。比起总数,更重要的是"活水率"——补充和淘汰的循环转得快不快。
Q: IP刚存进去就失效,正常吗?
正常,尤其是免费来源,几分钟寿命的IP一大把,这正是体检模块存在的意义。用神龙HTTP这类正规授权的付费来源会好很多,失效比例低,池子波动小,跑起来省心得多。
Q: 体检请求会不会给目标网站添麻烦?
不会,因为体检根本不打目标网站。给池子里的IP做检查,用的是专门的测试地址;只有真正采集的时候,请求才会发往目标网站。两套流量分开,互不干扰。
Q: 代码基础比较差,能搭起来吗?
能。整份代码就一个文件,依赖只有 requests 和 redis 两个库,照着本文从上往下粘就能跑。卡在哪一步,神龙HTTP那边有文档和示例代码,技术团队7×24小时在线,把报错贴过去基本都能很快解决。