跑采集脚本的人基本都撞见过这种场面:上午还正常返回数据,下午开始大量弹验证码,甚至直接给你一个 403。换了个代理继续跑,还是一样。很多人第一反应是"IP被封了",其实问题往往出在更早的一步——你手里这批代理,匿名度根本不达标。
匿名度这事听起来虚,测起来其实很实在。它不看你代理多快、池子多大,只看一件事:目标网站从这次请求里,能读到多少关于你的真实信息。下面把检测方法拆成三类,再讲清楚拿到结果以后怎么判读。
先弄明白:匿名度不是"能用不能用",而是分三档
代理服务器在转发请求时,会在 HTTP 头里动手脚。加什么、删什么,直接决定了目标站看到的是什么样子。
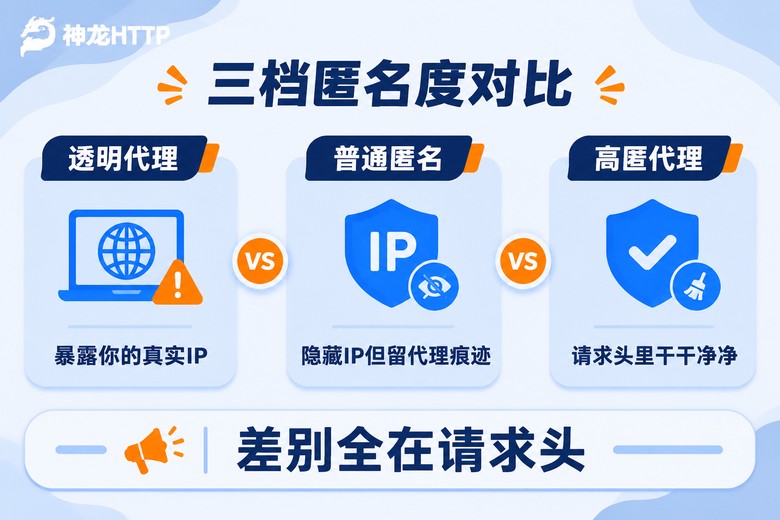
透明代理最省事,它把你原来的 IP 原封不动塞进 X-Forwarded-For,自己只做中转。站点一眼就知道:来的人用了代理,真实 IP 是这个。普通匿名代理稍微讲究点,它把来源 IP 换成了自己的,但仍在头里留下 Via、Proxy-Connection 这类表明"我是代理"的字段。高匿代理则把头清理得很干净,站点看起来就是一个普通访客从某个机房或家庭宽带连过来。
三档之间的差别,说到底就是请求头里多带了什么、少带了什么。所以检测的方向也很明确:想办法让代理去访问一个"会把它看到的头原样吐回来"的页面。
第一类:回显请求头,最直接也最容易做错
做法很土但有效——自己搭一个回显接口。别用第三方公共接口,一是你不知道它有没有改写头,二是反复请求容易被限速,测出来的结果不可信。
from flask import Flask, request, jsonify

app = Flask(__name__)

@app.route("/echo")
def echo():
    return jsonify({
        "remote_addr": request.remote_addr,          # 服务器看到的来源IP
        "xff":         request.headers.get("X-Forwarded-For"),
        "via":         request.headers.get("Via"),
        "client_ip":   request.headers.get("Client-IP"),
        "real_ip":     request.headers.get("X-Real-IP"),
        "forwarded":   request.headers.get("Forwarded"),
        "accept_lang": request.headers.get("Accept-Language"),
    })

app.run(host="0.0.0.0", port=5000)
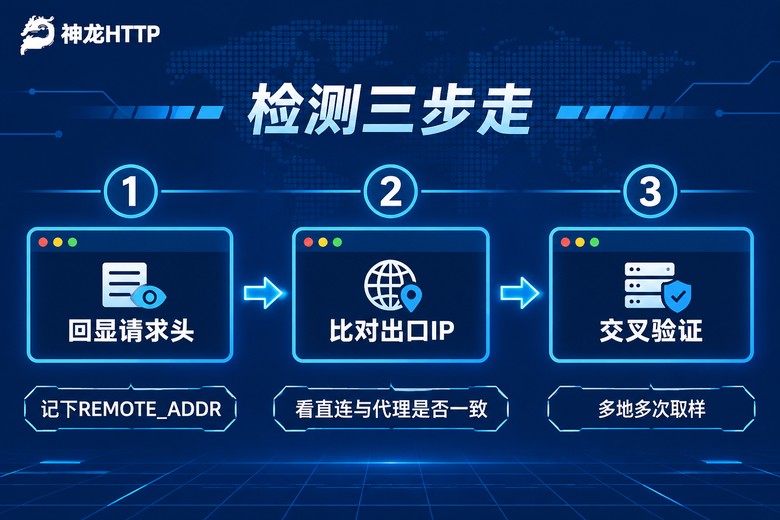
把这服务扔在一台公网机器上,然后分别用直连和代理各请求一次,对比两组结果。
import requests

TARGET = "http://你的回显服务地址:5000/echo"
proxy  = "http://账号:密码@代理地址:端口"

direct  = requests.get(TARGET, timeout=8).json()
proxied = requests.get(
    TARGET,
    proxies={"http": proxy, "https": proxy},
    timeout=15,
).json()

print("直连出口:", direct["remote_addr"])
print("代理出口:", proxied["remote_addr"])
print("XFF:", proxied["xff"])
print("Via:", proxied["via"])
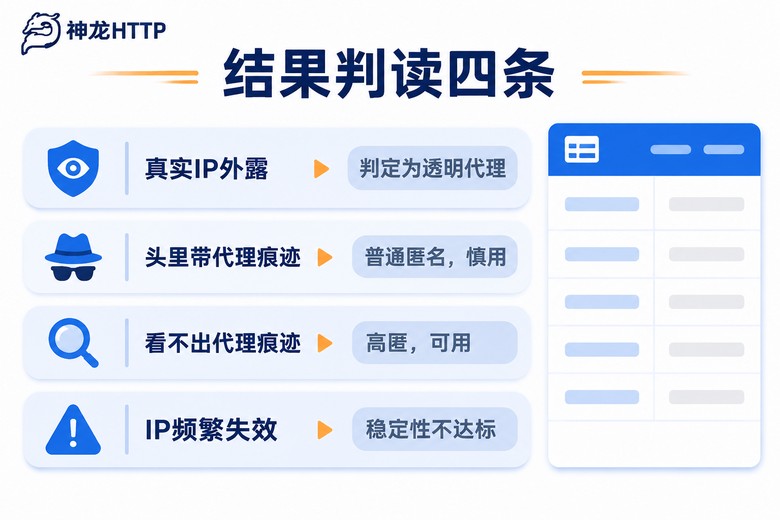
重点看三处。remote_addr 应该是代理服务器的 IP,而不是你本机的公网 IP——如果它等于直连时那个值,说明这代理压根没起作用,或者是个透明代理。XFF 里如果出现了你的真实 IP,匿名度直接判负。Via 只要非空,就至少是普通匿名,高匿是不该有这东西的。
常见错误是只测一次就下结论。同一个代理池里不同 IP 的配置经常不统一,有的出口节点清理了头,有的没清理。取样至少 10 个不同 IP,统计比例,比看单个结果靠谱得多。
第二类:出口 IP 比对与指纹一致性
光看头不够。有些代理把头清理得挺干净,但其他细节露馅了。
第一件事是出口比对:直连一次记下真实 IP,代理后再看一次,确认两者确实不同,并且代理出口 IP 的归属地跟你买的地区对得上。你在后台勾的是某城市的 IP,结果出口落在另一个省,那这个"城市级定位"就是虚的。
第二件事是指纹一致性,这块最容易被忽略。浏览器或客户端会带 Accept-Language、User-Agent,还可能暴露时区。如果你的请求头写着中文环境、时区是东八区,但出口 IP 却在别的时区,风控系统会立刻给你打上"环境不一致"的标记。这时候哪怕匿名度测出来是高匿,实际用起来照样掉。
第三件事是 DNS。代理只转发 HTTP 流量、不管 DNS 解析的话,解析请求可能直接从本地发出,等于把你的位置暴露了。检测时可以观察目标域名解析走的哪条链路,或者干脆选支持完整转发的代理。
第三类:行为面与时序特征,给前两类兜底
前两类看的是"说了什么",这一类看的是"怎么说话"。它不依赖任何回显,纯靠观测,适合验证那些头部被清理得很完美的代理到底是不是真高匿。
盯这几个指标就够了:响应时间分布——同一批 IP 的延迟如果忽高忽低、抖动特别大,说明线路质量差,或者这些 IP 正被大量共享;首包与连接建立耗时——建连慢但传输快,往往是链路绕远;并发下的失败率——单线程测都正常,一上并发就大面积超时,本质是承载能力不够;会话粘性——需要连续请求同一站点的场景里,IP 是不是几次就换一个,换了以后 cookie 还能不能续上。
这类检测没法给你一个"是或否"的结论,但它能做交叉验证。比如前两类都判成高匿,但时序特征显示这批 IP 延迟抖动剧烈、并发掉线率高,那结论就该改成:"匿名度够,但质量不够。"
结果怎么判读:把三张表拼起来看
单看一个指标容易误判,把三类结果放在一张表里对照,结论就清晰了。
| 检测项 | 透明代理 | 普通匿名 | 高匿代理 |
|---|---|---|---|
| 服务器看到的来源 IP | 你的真实 IP | 代理 IP | 代理 IP |
| X-Forwarded-For | 带真实 IP | 带真实 IP | 基本不出现 |
| Via / Proxy-Connection | 常有 | 常有 | 没有 |
| 目标站的判断 | 一眼看出用了代理 | 知道是代理来的 | 当成普通访客 |
| 适合的场景 | 仅内部调试 | 低风控页面 | 公开数据采集 |
判读顺序建议这样走:先看 remote_addr 是否被替换,这一步定生死;再看头里有没有真实 IP 泄露,有就直接降级;然后检查 Via 一类字段,决定是普通匿名还是高匿;最后叠加时序指标,判断能不能撑住你的并发量。
几个常见的误判来源也顺带说下。一是中间隔了 CDN,你测到的 IP 可能是 CDN 节点的,不是代理出口;二是目标站自己会改写头,回显接口和真实目标站的结果对不上;三是样本太少,抽了三个 IP 全是好节点,就以为整池都干净。多测、多换目标、多取样,才能把误判压下去。
更省事的做法:把检测提前到"入库"那一步
自己写检测脚本当然可以,但真跑起来你会发现工作量不小:要维护回显服务、要跑多轮取样、要统计比例、还要定期复检,因为代理池的质量是会变的。尤其是需要长期跑公开数据采集或者给 AI 大模型训练喂数据的场景,IP 一多,检测本身就成了一个项目。
所以不少团队的做法是:直接把匿名度作为选供应商的第一道门槛。神龙HTTP 这边的底子是国内三大运营商正规授权、3000 万+ 代理 IP 储备,IP 纯度 99.8%,可用率 99.9%,300+ 城市级精准定位,短效动态、长效静态、固定IP 三条产品线都支持 HTTP/HTTPS/SOCKS5。这类正规授权的资源,出口结构相对干净,头里的痕迹少,测出来的高匿比例才稳得住。
接入上也不折腾,API 兼容主流爬虫编程语言,文档和示例代码都给到,取到的 IP 可以直接进你现有的检测流程里跑一遍——该验的还是验,只是不合格的比例低很多。个人中心里有可视化的用量统计和实时监控,能看趋势、也能识别异常,什么时候某批 IP 开始塌了,一眼就能发现。技术团队是 7×24 小时支持的,遇到取用异常不用干等。
常见问题
Q:同一个代理 IP,在不同网站测出来的匿名度为什么不一样?
很常见。有些站点前面挂了 CDN 或者自建网关,会重写甚至补全请求头;有些站点只看 TCP 层来源,不读头。判断时以你自己的回显接口为准,第三方页面的结果只当参考。
Q:测出来是高匿,是不是就一定能稳定采集?
不是。匿名度解决的是"会不会被一眼认出用了代理",稳定性是另一回事,取决于 IP 的纯净度、复用频率和并发承载。一个高匿但被几十个人共用的 IP,照样很快失效。所以匿名度达标之后,还要看延迟抖动和并发失败率。
Q:需要测多少个 IP、多久复测一次?
初次入库建议至少抽 20 到 30 个 IP,分两到三个时段各测一轮,看比例而不是看单点。之后按你实际的取用节奏定,短效动态 IP 建议每天抽检一小批,长效静态 IP 可以拉长到每周。
Q:只测请求头够不够,还要不要做出口比对?
不够。头可以被清理得很漂亮,但出口归属地对不上、时区和语言环境矛盾,一样会被拦。头、出口、时序这三样拼起来看,才是一份可信的匿名度结论。