先把三个词摆回各自的位置
早上刚回完一封邮件,对面的哥们为这事纠结了快一周:API 提取、隧道提取、白名单,到底哪个好。我看了一眼他贴出来的代码,问题其实不在选哪个,而是他把三个不同层面的东西塞进了同一个抽屉。
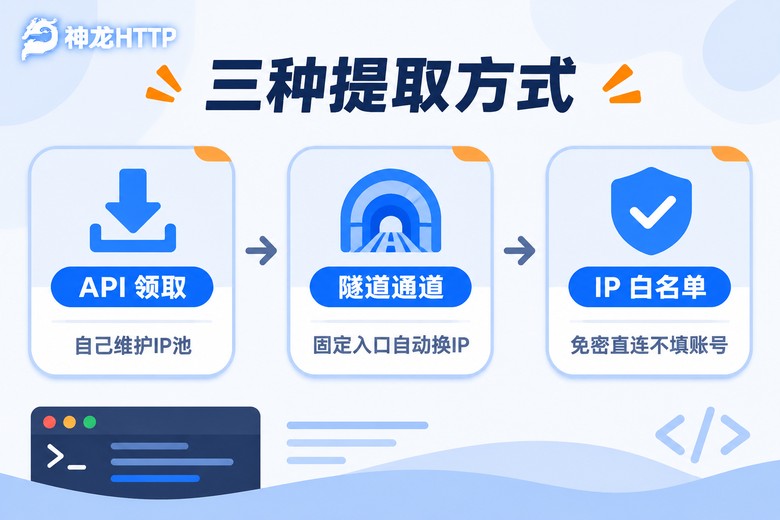
拆开说就清楚了。API 提取回答的是"IP 从哪来"——你调一次接口,拿回一串 IP 和端口,自己存着用。隧道提取回答的是"通道长什么样"——你只填一个固定的入口地址,后面的事交给服务商。白名单回答的是"怎么证明这台机器是你"——把服务器出口 IP 报备上去,连账号密码都不用填。
一个管货源,一个管水管,一个管门禁卡。混着比,永远比不出结果。
API 提取:自己当仓库管理员
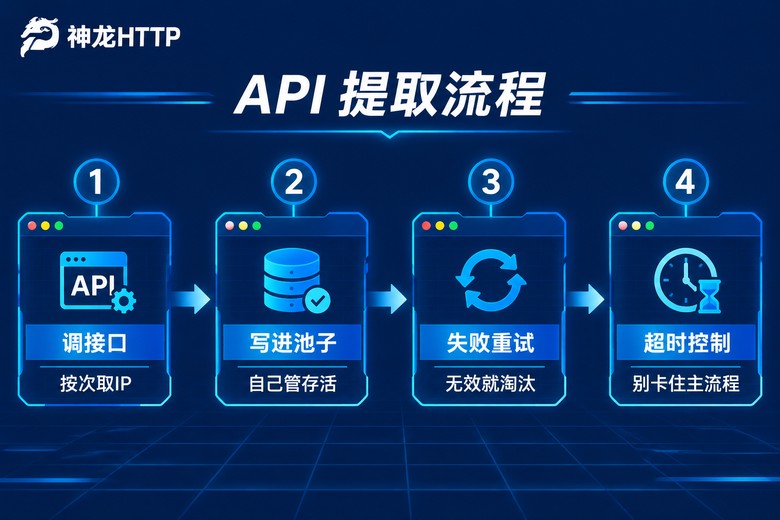
调一次接口,返回一批 IP。听着简单,真用起来有三件事跑不掉:存下来、盯存活、死了补货。而且这三件事都得你自己写。
先看最小能用的一段,Python 加 requests,十几行就够。
import requests

# 提取链接在个人中心生成,这里换成你自己的那一条
API_URL = "YOUR_API_URL"

def fetch_pool(size=50):
    # num 控制一次取多少个,参数名以文档为准
    resp = requests.get(API_URL, params={"num": size}, timeout=10)
    resp.raise_for_status()
    # 一般返回一行一个,格式是 IP:端口
    return [line.strip() for line in resp.text.splitlines() if line.strip()]

pool = fetch_pool(50)
print("本轮拿到", len(pool), "个")
取回来只是开始。池子里的 IP 会过期,失效的那条不淘汰,你的失败率就一直在那儿挂着,然后你会怀疑是服务商不行——其实大概率是池子里躺着一堆已经死掉的地址。所以取完之后得能标记、能剔除,用空了要能补。
API 提取的好处也在这儿:哪个城市、什么运营商、一次要多少,全写在参数里,你说得清清楚楚。要按地区挑 IP 的活,基本只能走这条路。
隧道提取:入口只有一个,出口一直在变
隧道反过来。你不需要知道此刻用的是哪个 IP,只要记住一个入口,把请求扔进去就行。
# 入口地址和端口在个人中心能看到,账号密码写在代理地址里
proxy = "http://用户名:密码@隧道入口:端口"
proxies = {"http": proxy, "https": proxy}

r = requests.get("TARGET_URL", proxies=proxies, timeout=15)
print(r.status_code)
注意这段代码里没有任何"取 IP"的动作。请求过去,通道那头会给你安排一个出口,你用就是了。之前那套池子管理、失效剔除、补货逻辑,一行都不用写。
代价是掌控变弱了。入口是固定的,哪天配置里写错一个字符,现象就是所有请求全部不通。排查的时候先看这里,别急着怀疑对方。
还有一点,隧道也会超时。别因为"反正有人管"就不设 timeout,一个卡死的请求能把整条线程拖住,这个坑我见过不止一次。
白名单:把认证这一步直接砍掉
严格讲,白名单不是第四种提取方式,它就是一种认证方式。把本机出口 IP 加到后台,之后的请求不用再带用户名密码。
# 出口 IP 已在后台报备,直接连隧道入口,不带账号密码
proxies = {"http": "http://隧道入口:端口", "https": "http://隧道入口:端口"}
r = requests.get("TARGET_URL", proxies=proxies, timeout=15)
省事是真省事。但有几个地方得盯住。
家宽环境下运营商给的 IP 会变,路由器重启一次可能就换了一个,白名单里的旧地址立刻作废。报错还挺含糊,看着像"连接被拒绝",本质是认证没过。云服务器的弹性 IP 同理,释放再绑定之后,要回来重新加一遍。
多台机器的时候先想清楚:是每台各自加进去,还是统一走同一个出口?这个问题在动手前定下来,比事后一台台补要省太多时间。
一张对照表,按手里的活挑
| 对比项 | API 提取 | 隧道提取 | 白名单认证 |
|---|---|---|---|
| 本质是什么 | 主动领取 IP 清单 | 固定入口转发 | 免密认证的方式 |
| 要不要自己维护池子 | 要,淘汰和补货全靠自己 | 不用 | 看搭配的是隧道还是 API |
| 什么时候换 IP | 你说了算 | 每次请求自动安排 | 取决于搭配的方式 |
| 接入成本 | 中等,得写一套池子逻辑 | 低,改一行代理地址 | 最低,账号都不用填 |
| 适合什么活 | 要按城市挑、要精细控制 | 长时间跑、并发高 | 多台机器共用同一通道 |
| 最常见的坑 | 失效 IP 没及时淘汰 | 入口配置写错,全盘不通 | 本机出口 IP 变了就连不上 |
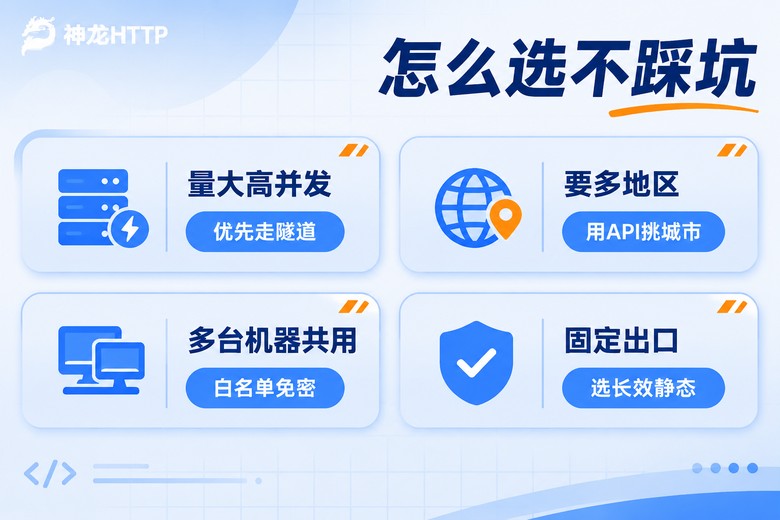
给三个不绕弯的结论:短周期、要多地区、要精细控制的,选 API;长时间挂着跑、并发上去了、不想维护池子的,选隧道;机器多、又不放心把账号密码散落在各个脚本里的,配白名单。
几个已经踩过的坑,你直接绕开
一次取太多。短效 IP 有存活时间,你一口气取五百个,前面的还没轮到用就过期了。按实际消耗速度取,不够了再补,别囤。
提取频率和并发没对上。十几个进程同时在跑,却只有一个去取 IP,结果就是大家抢同一个池子。要么加锁,要么各自取各自的。
失效不淘汰。这个最要命。池子越滚越大,里面一半是死的,失败率一直下不来,还以为是服务商的问题。
白名单报错看不懂。连不上先查自己的出口 IP 有没有变,这一条能省掉一半排查时间。
选的时候顺手看这两件事
神龙HTTP 这边,短效动态 IP、长效静态 IP、固定 IP 代理是一站式提供的,API 兼容主流爬虫语言,文档和示例代码都给得很全,基本是复制过来改个参数就能跑起来。它家的城市级精准定位覆盖 300 多个城市,做区域性的价格对比、门店数据这类活,能直接定位到想要的城市,省得结果出来再筛一遍。
另一个我觉得实用的是个人中心的可视化用量统计和实时监控。跑大规模采集的时候,你总得知道今天消耗了多少、哪段时间请求失败集中——这些数字摆在面板上,比自己写日志再统计要快得多。技术团队 7×24 小时在线,配置卡住的时候有人能问,比自己对着文档猜要省心。
所以回到最开始那个问题。三种方式没有绝对优劣,只有和你手上这活对不对得上。先想清楚三件事:要不要精细控制 IP、要不要长期挂着跑、有几台机器。答案基本自己就浮出来了。
常见问题
Q:三种方式可以混着用吗?
很常见,而且往往更好用。隧道提取配白名单认证是最省事的组合,固定入口加免密,脚本里连密码都不用写。API 提取也能把本机 IP 加进白名单,少传一次账号。唯一要注意的是别在一个项目里同时维护两套池子逻辑,容易乱,出问题也不好查。
Q:隧道提取会不会比 API 提取慢?
一般不会明显慢,差别更多在可控性上。隧道多了一跳转发,但省掉了自己维护池子、剔除失效 IP 的时间。如果真觉得延迟高,先看入口地区和你服务器离得远不远,再检查是不是并发开太大把自己堵住了。
Q:白名单加进去了,为什么还是连不上?
按顺序查三件事:本机出口 IP 有没有变;填的是不是 IPv4 地址、有没有多打空格;端口是不是写对了。绝大多数"白名单不生效"最后都落在第一条上。
Q:采集量不大,选哪个最省事?
直接上隧道提取加白名单,脚本里几乎不用改什么,代理地址一填就能跑,不用担心池子过期。哪天需要按城市挑 IP 了,再回去用 API 也不迟。