很多人第一次碰代理IP接口,卡住的地方其实不是写代码,是打开那条提取链接之后一脸懵:返回的这坨东西哪一段是IP?端口填哪里?为什么刚拿到手就失效了?这篇就把整条路从头走一遍,从链接里返回的字段,到你代码里跑起来的第一行 requests.get,中间该看的、该注意的,一次讲完。
提取链接返回的到底是什么
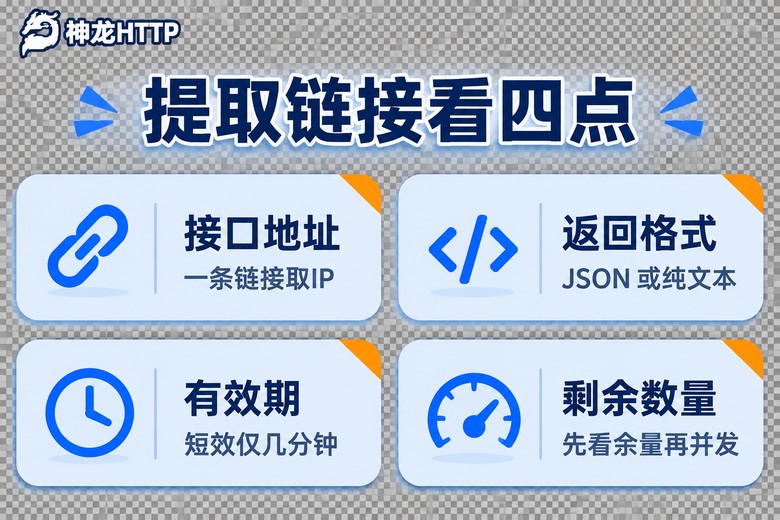
你开通服务后拿到的那个"API提取链接",本质就是一个普通网址。拿浏览器或者 curl 直接打开它,它会当场给你一批此刻可用的代理IP。就这么简单,没有任何玄学。
区别只在于返回格式。大多数接口支持 纯文本 和 JSON 两种,纯文本是 IP:端口 一行一条,复制粘贴最快;JSON 多带了有效期、归属地这些字段,写代码的时候更省事,建议直接用 JSON。
JSON 一般长这样:
{
  "code": 0,
  "msg": "success",
  "data": [
    {
      "ip": "1.2.3.4",
      "port": 8080,
      "expire_time": "2026-03-01 12:05:30",
      "city": "杭州"
    },
    {
      "ip": "5.6.7.8",
      "port": 9000,
      "expire_time": "2026-03-01 12:05:30",
      "city": "成都"
    }
  ]
}
看四个地方就够了:ip、port 拼成代理地址;expire_time 决定你还能用多久;code 是不是 0 判断这次提取成不成功;data 的长度就是这次拿到几条。短效动态IP通常只有几分钟寿命,所以拿到之后别囤着,立刻用。
先把提取链接在浏览器里跑通,再谈代码
这一步别跳过。很多人后面代码一直报错,其实问题出在链接本身就是错的:少了个参数、账号没开权限、提取数量超过了套餐限制。
最省事的验证方式就是命令行敲一下:
curl "你的提取链接"
能看到正常返回,说明账号、白名单、剩余额度都没问题。如果返回的是"白名单未授权"之类的内容,去个人中心把当前公网IP加进白名单,或者改用账号密码认证方式,这一步解决掉,后面能省掉一大半排查时间。
顺便说一句,很多提取链接支持加参数。比如 &num=5 可以一次取5条,&type=json 指定返回格式,&city=上海 指定城市。参数顺序不用背,改一次跑一次,看返回变没变就知道了。
第二步:几行代码把IP塞进请求里
拼代理地址的规则只有一条:http://IP:端口。如果服务商开了账号密码认证,就写成 http://用户名:密码@IP:端口。多出来的协议头别省,少了它 requests 会直接把代理参数当噪音忽略掉,你还以为代理没生效。
import requests

EXTRACT_URL = "你的提取链接"

# 1. 取一条IP
item = requests.get(EXTRACT_URL, timeout=5).json()["data"][0]
proxy = f"http://{item['ip']}:{item['port']}"

# 2. 塞进请求
proxies = {"http": proxy, "https": proxy}

# 3. 发请求,顺手确认出口IP
r = requests.get("http://httpbin.org/ip", proxies=proxies, timeout=8)
print(r.text)   # 这里看到的IP应该就是代理IP,而不是你本机的
代码跑通之后,先别急着接业务页面。找一个能回显出口IP的测试地址,确认"出去的IP真的变了",这一步能排除掉80%的假性成功——页面是返回了200,但其实是直连的结果,代理根本没起作用。
第三步:写个带重试的小函数,让它自己换IP
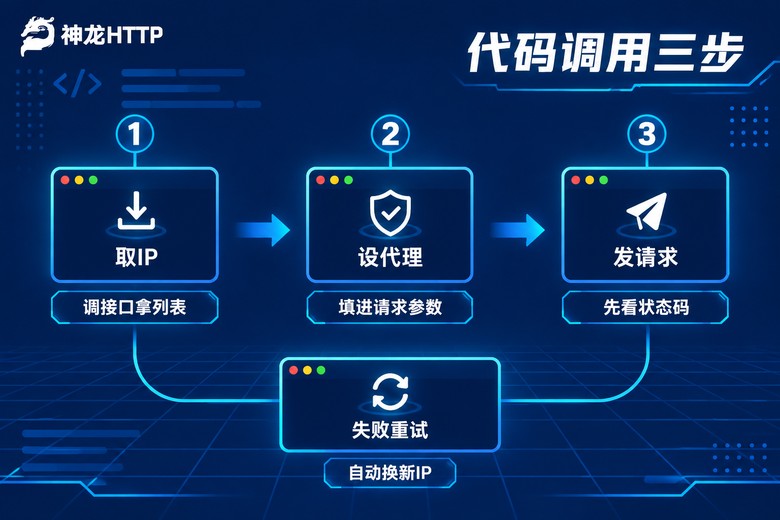
单次调用只是验证,真正跑起来的时候你必须接受一个事实:代理IP会掉。短效IP几分钟就换,网络抖动、目标站点限速都会让某一次请求失败。所以正确姿势是——失败就重新提取一条,而不是拿同一条IP死磕。
def fetch(url, retry=3):
    for i in range(retry):
        try:
            item = requests.get(EXTRACT_URL, timeout=5).json()["data"][0]
            proxy = f"http://{item['ip']}:{item['port']}"
            r = requests.get(
                url,
                proxies={"http": proxy, "https": proxy},
                timeout=8,
                headers={"User-Agent": "Mozilla/5.0 ..."}
            )
            if r.status_code == 200 and len(r.text) > 100:
                return r.text
            print(f"第{i+1}次没成功,状态码 {r.status_code}")
        except Exception as e:
            print(f"第{i+1}次异常:{e}")
    return None
注意 len(r.text) > 100 这个小判断。有些站点被拦了不给你报错,而是返回一个几百字节的空白页或者验证页,只看状态码会被骗过去。加个长度门限,能挡掉不少假成功。
第四步:并发和超时怎么调才不翻车
聊到这里,参数基本就那几个,但每个都直接影响成败。经验值摆出来:
| 参数 | 建议取值 | 调错了会怎样 |
|---|---|---|
| 提取接口超时 | 3~5 秒 | 设太短会频繁误判成提取失败 |
| 业务请求超时 | 8~15 秒 | 设太短大量假超时,设太长线程全卡死 |
| 单IP使用次数 | 10~30 次后主动换 | 一条IP用到底,很快被目标站点盯上 |
| 并发线程数 | 先 20,跑稳再加 | 一上来开几百,全部超时,看不出问题在哪 |
| 重试次数 | 3 次 | 无限重试会把任务队列堵死 |
实操建议是:先单线程跑通,再把线程数翻倍往上试,哪一档开始大量失败,就退回到上一档。稳定的并发值是要试出来的,不是抄来的。另外长时间任务记得定期检查手上这IP还剩多少寿命,快到期前主动换掉,比等它报错再换要平滑得多。
报错对照表:这几种情况先查这里
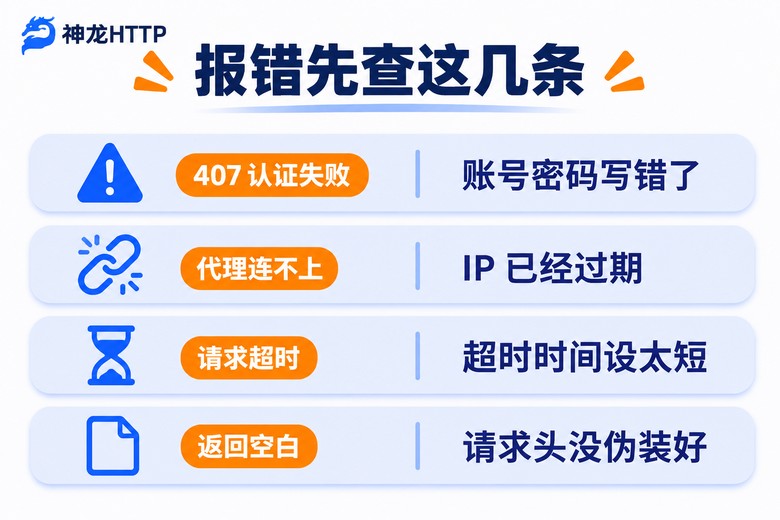
遇到问题别急着怀疑代码,先按现象对号入座:
| 现象 | 大概率原因 | 怎么处理 |
|---|---|---|
| 407 / 认证失败 | 账号密码写错,或白名单没加 | 检查拼接格式,确认当前公网IP在授权列表里 |
| 代理连不上 | IP过期了,或者端口抄错 | 重新提取一条,别复用旧数据 |
| 一直超时 | 超时阈值太小,或这条IP质量差 | 放宽到 10 秒,连续两次就换IP |
| 返回空白或验证页 | 请求头太"裸",被识别成程序 | 补上正常的 User-Agent 和 Referer |
| 状态码 200 但内容不对 | 代理没生效,其实走的是直连 | 用回显IP的测试页确认出口 |
选服务商时,我一般只看这几件事
代码写顺了以后你会发现,真正决定体验的其实是IP本身的质量。同样一段 Python,用不同的池子,成功率能差出一大截。
我现在用的神龙HTTP,比较省心的点在于它家是国内三大运营商正规授权的线路,3000万+的代理IP储备,可用率标称99.9%。这些数字落到实际使用上是什么意思?就是你在循环里重新提取的时候,很少连续几次都拿到已经死掉的IP,重试逻辑不会空转。300+城市级精准定位这一项在做分地区的数据采集、市场研究时特别好用,提取链接后面加个城市参数,返回的就是当地的出口。
另一件容易被忽略的是接入成本。神龙HTTP的API兼容主流爬虫编程语言,给文档也给了示例代码,requests、httpx 这些常见写法基本照抄就能跑。个人中心里有可视化的用量统计和实时监控,哪段时间调用失败率高、IP消耗得快,一眼能看出来,调参数的时候不用凭感觉猜。短效动态IP、长效静态IP、固定IP代理这几条产品线都有,同一套代码换个提取链接就能切,不用重写。
常见问题
Q:提取链接可以直接写在前端或者分享给同事吗?
不建议。链接里通常带着你的账号凭证,谁拿到谁就能消耗你的额度。要给别人用,就在后台单独开子账号,或者让请求统一走你自己的后端转发。
Q:为什么刚提取的IP,第一次用就失败了?
先确认它是不是短效IP——这类IP寿命可能只有1到5分钟,从提取到真正发出请求如果中间隔了几十秒,加上排队时间,很可能已经过期。正确的做法是用完即取、取完即用,把提取和请求放在同一个函数里紧挨着写。
Q:代理配上了,状态码也是200,但拿到的数据是空的?
十有八九是代理压根没生效,你的请求走了直连,被目标页面识别成程序后返回了空内容。解决办法很简单,先把请求打到一个会回显出口IP的测试地址上,看返回的IP是不是代理IP,是就继续排查请求头,不是就先修代理配置。
Q:并发数开多大比较合适?
没有标准答案,跟目标站点的承受能力、你手上的IP池规模都有关。稳妥的路径是20线程起步,稳定跑十分钟没有明显失败率上升,再加到40、60。一旦出现大面积超时,说明这一档已经超了,退回去就行。别一上来就开几百线程,那样失败日志会多到看不出问题根源。