做多城市数据采集的团队,十有八九在第二个月撞上同一堵墙:脚本在单个城市跑得好好的,一扩到二十几个城市,任务排期就开始崩。表现特别一致——上午该跑完的活儿拖到夜里,日志里大片 403 和连接超时,加机器也不顶事。
问题往往不在爬虫代码,在池子。IP池不是"买回来一堆地址"就完事,它更像一个需要盘点的库存:进多少货、怎么记账、过期的怎么清出去。下面把容量、去重、清洗这三块拆开讲,都能直接照着改调度逻辑。
一、先算清楚池子要多大
很多人第一句话就问"多大池子才够用"。这问题得倒过来算:你的任务每分钟要发多少请求,一个IP在目标站点上能安全扛多少,一除就出来了。
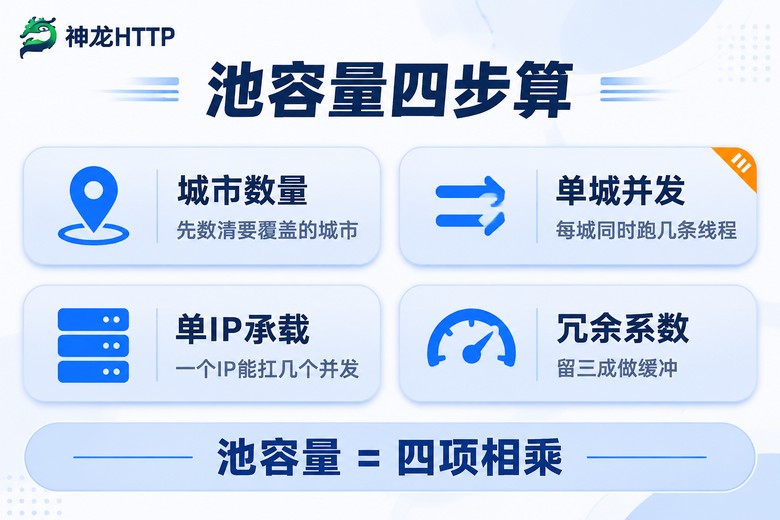
可以直接套的算式:建议可用池 ≈ 城市数 × 单城并发 × 单IP可承载并发 × 冗余系数。冗余系数取 1.3 到 1.5,用来兜住IP提前失效、目标站点临时收紧风控这些意外。
举个数。你要覆盖 25 个城市,每个城市同时跑 15 条线程,一个IP在同一站点上建议不超过 3 个并发(再高容易触发限流),那么 25 × 15 × 3 = 1125,再乘 1.4,池子得稳定供上 1500 个左右的可用IP,不是库存里有 1500 个就行。
"可用"这两个字最容易被忽略。如果你手上池子的可用率是 75%,要压出 1500 的可用量,库存至少得备 2000 出头。这就是为什么看池子要先看可用率,而不是光看总量那个大数字。
| 城市数 | 单城并发 | 单IP承载并发 | 冗余系数 | 建议可用池 |
|---|---|---|---|---|
| 8 | 10 | 3 | 1.3 | 312 |
| 15 | 12 | 3 | 1.4 | 756 |
| 25 | 15 | 3 | 1.4 | 1575 |
| 40 | 20 | 2 | 1.5 | 2400 |
还有一点:池子的提取速度和可用率是一对双胞胎。你的调度器一分钟要抽 200 个IP,接口一分钟只吐 80 个,池子再大也供不上,任务照样排队。选池子时把"每分钟能提取多少"也一并问清楚,最好按自己峰值需求的 1.5 倍留余量。
二、去重:别让同一个IP在同一天反复出现
去重做不好,最典型的症状是"明明池子里有几千个IP,某个城市却总有几个地址一天被用了三十多次"。目标站点看到的是同一个来源反复来,风控自然收紧。
真实项目里要去重的地方其实有三层,缺一层都漏:
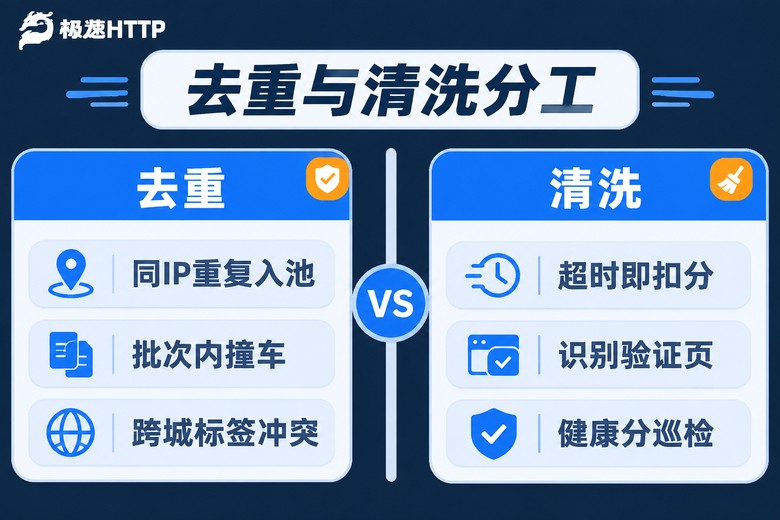
池内去重——新提取的IP落进池子前先查一遍,同一个 IP:端口 已经在了就丢掉,否则池子会虚胖,看起来五万,实际可用两万。批次内去重——同一批任务分配出去的时候,一个IP别同时发给两个线程,不然你自己就把并发打上去了。跨城市去重——这条最容易忘。一个挂在成都的IP,被同时派给了成都和西安两个城市的任务,返回的地域信息就对不上,你后面的数据清洗成本会翻倍。
import hashlib, time

class PoolGuard:
    def __init__(self):
        self.in_pool = set()        # 池内去重:IP:端口 指纹
        self.meta = {}              # 指纹 -> 归属城市 / 今日使用次数

    def _key(self, ip, port):
        return hashlib.md5(f"{ip}:{port}".encode()).hexdigest()

    def push(self, ip, port, city):
        k = self._key(ip, port)
        if k in self.in_pool:       # 已经在了,直接丢弃,别重复入库
            return False
        self.in_pool.add(k)
        self.meta[k] = {"city": city, "used": 0, "ts": time.time()}
        return True

    def take(self, city, max_per_ip=2):
        for k, m in self.meta.items():
            if m["city"] == city and m["used"] < max_per_ip:
                m["used"] += 1      # 批次内去重:一天最多派两次
                return k
        return None                 # 该城市子池临时空了,回去补货
这段逻辑不复杂,关键在于把去重放在入池和分发这两个动作上,而不是等任务跑完再去日志里查。数量上到几万的池子,用 Redis 的 Set 或者布隆过滤器更稳当,内存也吃得少。
三、清洗:让失效的IP自己退出队列
清洗不是"每天凌晨清一次",那样一个坏IP能拖你半天进度。合理的做法是边跑边打分:每个IP进来时健康分 100,成功一次回一点血,失败就扣,连续失败到线就踢出去。
from collections import defaultdict

score = defaultdict(lambda: 100)      # 健康分,初始100
streak = defaultdict(int)             # 连续失败次数

def report(ip, ok, reason=""):
    if ok:
        score[ip] = min(100, score[ip] + 2)
        streak[ip] = 0
    else:
        score[ip] -= 25 if reason == "timeout" else 15
        streak[ip] += 1

def should_drop(ip):
    return streak[ip] >= 3 or score[ip] < 40
扣分的力度按失效性质分档,别一刀切。连接超时多半是链路抖动,扣 15 分还有救;返回 403 或 429 是目标站点在限流,扣 25 分并把该城市暂停一分钟;如果抓回来的页面里出现"访问过于频繁""请完成验证"这类字样,说明这个IP已经被识别成自动化流量了,立刻踢掉,顺手把同段地址标记成观察对象。
| 现象 | 多半是什么问题 | 处理动作 |
|---|---|---|
| 连接超时超过 8 秒 | 链路抖动 | 扣 15 分,连续 3 次移出池子 |
| 返回 403 / 429 | 目标站点限流 | 扣 25 分,该城市任务暂停 1 分钟 |
| 页面为空或含验证提示 | 被判定为自动化 | 立即移出,同段地址标记观察 |
还有个小细节值得做:每天统计一次各城市的淘汰率。某个城市连续三天淘汰率超过 30%,多半不是IP的问题,是你在那个城市的请求节奏太急了,把并发调下来比换池子管用。
四、把容量、去重、清洗串成一条流水线
三块拆开都对,合到一起还得有个顺序感。比较省心的结构是四步:入池先探活(新IP先发一个轻请求确认能用)、按批次指纹去重、按城市子池路由分发、失败自动退场并触发补货。
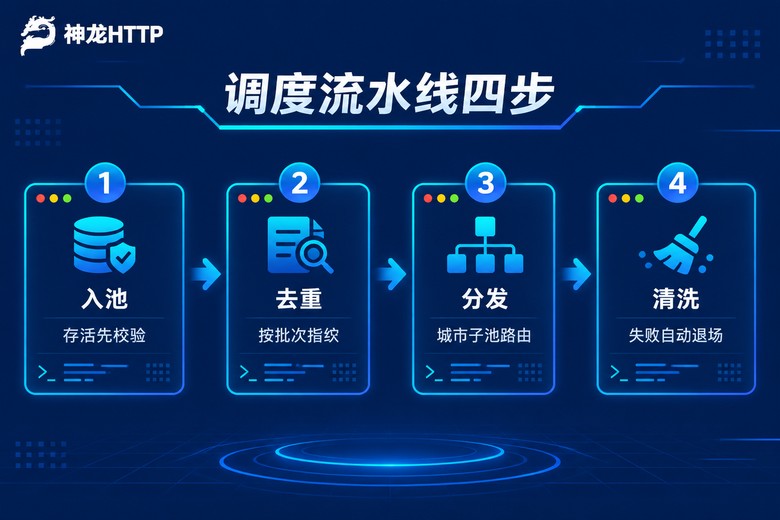
中间那个"城市子池"是很多人省掉的一环。做法很简单:池子在内存里按城市分组,成都的任务只从成都那一组拿IP,拿空了才去补。这样调度层的代码几乎不用改,但地域标签的准确率会明显上一个台阶,也不会出现一个城市把整个池子抽干、其他城市干等着的情况。
补货的阈值也建议提前定死,比如某个城市子池可用数量掉到需求的 40% 就触发一次提取,别等到彻底见底才反应过来——那时候任务已经在排队了。
五、选服务时多看两眼的地方
上面这些机制都得建在底层池子靠谱的前提下。挑服务的时候,除了价格和总量,我个人更看重两件事。
一是城市覆盖能不能做到城市级。多城市任务调度最怕地域标签漂移,IP说是这个城市的,实际出口在隔壁省,那你后面所有按城市汇总的数据都得重做。神龙HTTP 这边有 300+ 城市级精准定位,池子储备在 3000 万以上、可用率 99.9%,做按城市分组调度时不用自己再猜地域。
二是用量和状态能不能看见。个人中心里有可视化用量统计和实时监控,哪个城市消耗快、哪些IP异常多,一眼能扫出来,比翻日志快多了。接入上它家的 API 兼容主流爬虫语言,文档和示例代码都有,短效动态、长效静态、固定IP这几条产品线按任务周期挑就行,多城市的高并发提取也压得住。清洗和去重逻辑照上面写完,接进去两三天能跑顺。
最后补一句经验:池子这件事别追求一步到位。先用小规模跑一周,把每个城市的淘汰率、单IP平均使用次数、补货频次这三个数记下来,你自然就知道容量该放大多少、去重该卡多严。数字比感觉准。
常见问题
Q:池子里的IP越多越稳吗?
不是。池子大小要跟你的请求量匹配,盲目放大只会让去重和清洗的成本一起涨。按城市数、单城并发、单IP承载并发乘出来,再乘 1.3 到 1.5 的冗余就够,剩下的精力放在去重和清洗上更划算。
Q:按城市分组调度,池子里会不会有的城市总是不够用?
会有这种情况,尤其是三四线城市。解决办法是给每个城市子池设一个最低水位,掉到需求的 40% 就自动补货,同时允许在极端情况下借用相邻城市的IP,并在结果里标注出来,别让数据悄悄串味。
Q:去重做到什么程度算够?
看你的采集频率。同一个IP对同一站点的访问间隔,一般控制在几分钟以上比较稳妥;同一批任务里一个IP最多派两次。如果发现某个城市重复使用次数明显偏高,先查分发逻辑,再考虑换池子。
Q:清洗频率多高合适?
别固定在某个时间点。实时打分 + 阈值淘汰最省事,另外每天挑一次做全量巡检,把健康分长期偏低的IP清掉。短效动态IP本身生命周期短,按批次整体替换比逐个清洗更简单。